Agent 经验学习:从文本反思、程序技能到策略内化
LLM-based agent 已经能推理、搜索、调用工具,也能在网页、代码仓库和桌面环境里完成多步任务。但大多数系统仍然像一位每天失忆的执行者:今天排查过的 API 陷阱,明天还会再踩;上一次失败轨迹里已经暴露的错误策略,换一个任务又会重演;用户反复纠正的格式偏好,只在当前对话里短暂生效。
所以,「Agent 如何积累经验」不是给上下文再接一个向量库。真正的问题是:如何把一次任务中的状态、动作、环境反馈和结果,压缩成以后能够正确触发、可靠执行、持续维护的能力单元。
近三年的研究给出了多种答案。Reflexion 把失败后的反思写进 episodic memory;AWM 从轨迹中归纳 workflow;Voyager 把经验保存成可执行代码;SkillOpt、SkillGrad 开始把 skill 文档当作可以优化的外部参数;SKILL0 则尝试在训练中逐步撤掉 skill context,让行为进入模型参数。它们并不构成整齐的四代技术。更准确的分类维度是:经验被存在哪里,以什么形式表示,何时更新,以及反馈如何分配给某个 skill。
本文检索时间为 2026-06-30。Reflexion、Voyager 等早期工作已有较多后续讨论,但本文涉及的大部分 skill-centric 方法发表于 2025 年末至 2026 年上半年,当前仍是 arXiv 预印本。不同论文使用的模型、harness、任务集和成本口径并不一致,文中的数字只用于解释各自方法,不做跨论文排名。
1. 经验、记忆、工作流和技能不是同一个概念
一条 agent 轨迹可以写成:
\[ \tau = (o_0, a_0, f_0, o_1, a_1, f_1, \ldots, o_T, r), \]
其中 \(o_t\) 是观察,\(a_t\) 是动作,\(f_t\) 是工具或环境返回的信息,\(r\) 是最终奖励或任务结果。保存 \(\tau\) 只能证明系统留下了日志,不能证明它学到了经验。下一次任务通常不会与旧任务逐 token 相同,原始轨迹也夹杂了无效搜索、偶然成功和环境噪声。经验学习需要从轨迹中提取可迁移的因果线索,并说明它在什么条件下成立。
本文使用下面这组区分:
| 概念 | 主要内容 | 典型使用方式 | 最常见的问题 |
|---|---|---|---|
| Episodic memory | 某次任务的轨迹、结果和反思 | 找相似案例或在同一任务中重试 | 冗长、噪声多、容易记住实例而不是规律 |
| Semantic memory | 从多次经历提炼的事实、偏好和启发式 | 检索后注入上下文 | 适用范围模糊,正反经验可能冲突 |
| Workflow | 可重复的高层动作顺序 | 为新任务提供计划骨架 | 界面或任务结构变化后容易失效 |
| Tool | 原子化、可调用的环境接口 | 以参数执行一个确定动作 | 只提供动作,不负责何时调用和如何组合 |
| Skill | 带触发条件、流程、资源和验证方式的能力包 | 检索、组合并指导完整任务 | 版本、依赖、检索、验证和安全成本高 |
| Parametric policy | 写入模型权重的行为倾向 | 无需额外检索即可生成动作 | 更新昂贵,难以审计和回滚,可能遗忘旧能力 |
「Skill」本身也有语义漂移。经典 hierarchical RL 中的 skill 通常指 option 或 temporally extended policy;近年的 agent 论文则常把 Markdown 指南、Python 函数、API、脚本与测试文件统称为 skill。本文讨论后一种工程语境,但保留一个更严格的要求:skill 至少应回答 何时使用、如何执行、如何判断执行正确。只有方法说明而没有触发条件,更接近一段知识;只有函数签名而没有流程,更接近 tool。
2. 经验积累是一条带验证的闭环
把现有工作放在同一张图里,可以得到六个连续环节:记录轨迹、抽取规律、选择表示、按任务检索、执行与组合、依据反馈维护。任何一环失效,经验库都会从资产变成噪声源。
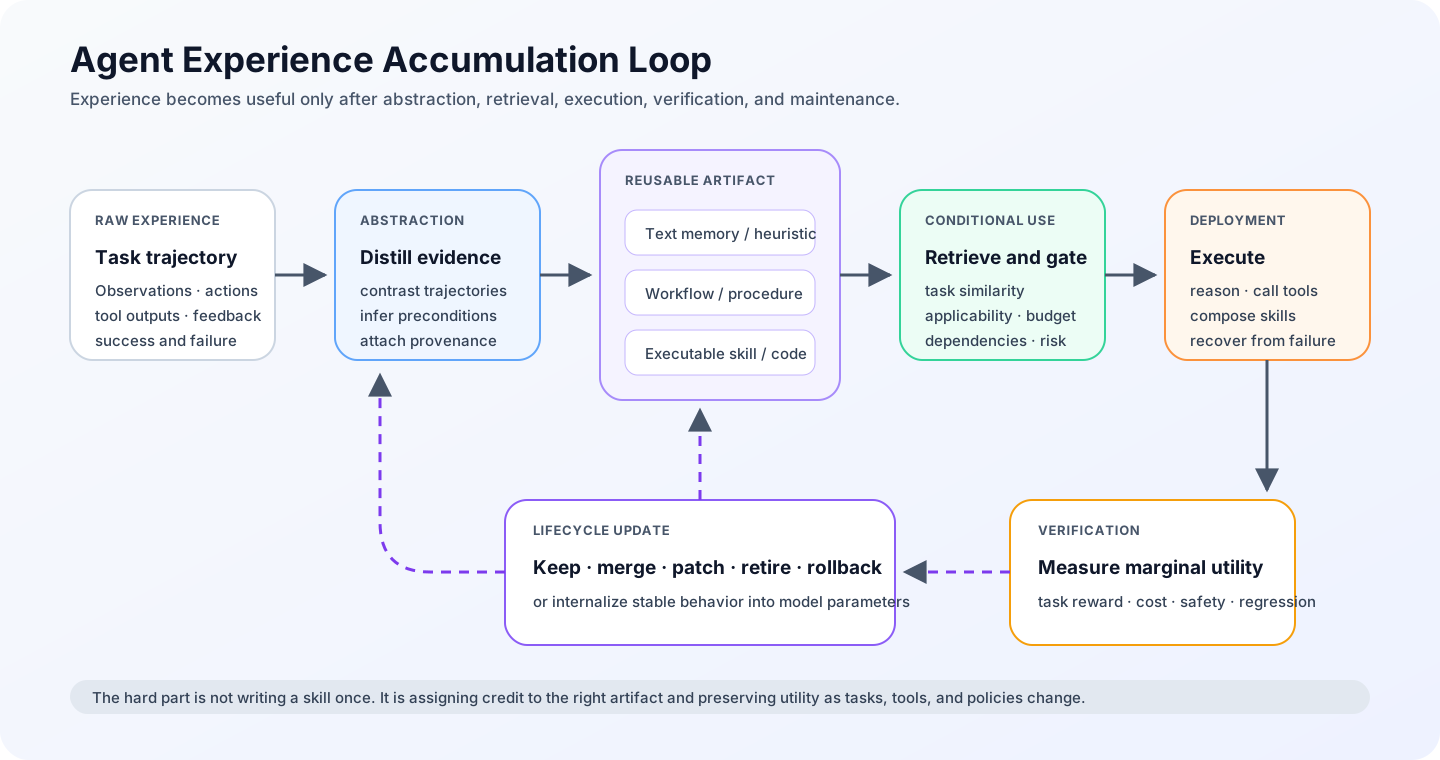
图 1:本文整理。经验只有经过抽取、条件化使用和验证,才会对后续任务产生可归因的增益。
可以把候选 skill 写成一个结构化对象:
\[ s = \{ \text{trigger}, \text{scope}, \text{preconditions}, \text{procedure}, \text{resources}, \text{verifier}, \text{fallback}, \text{provenance}, \text{version} \}. \]
这组字段不是为了把 Markdown 变成复杂 schema,而是为了补上纯反思文本缺少的边界。procedure 说明怎么做,preconditions 和 scope 防止错误迁移,verifier 提供可观察的完成标准,fallback 允许 agent 在成本过高或环境不兼容时退回更简单的策略,provenance 则把结论连回原始轨迹和反馈。
一个 skill 是否值得保留,不能只看使用它之后的任务分数。更合理的目标是边际效用:
\[ \Delta U(s;x) = \mathbb{E}\left[R(\pi, s, x)-R(\pi, \varnothing, x)\right] -\lambda C(s,x) -\mu \operatorname{Risk}(s,x), \]
其中 \(x\) 是任务,\(R\) 是任务收益,\(C\) 统计检索、上下文、工具和时延成本,风险项覆盖越权执行、错误副作用及供应链问题。这个表达式揭示了一个容易被成功率遮住的事实:一个能把通过率提高 1 个百分点、却让 token 和执行时间翻数倍的 skill,未必值得部署。
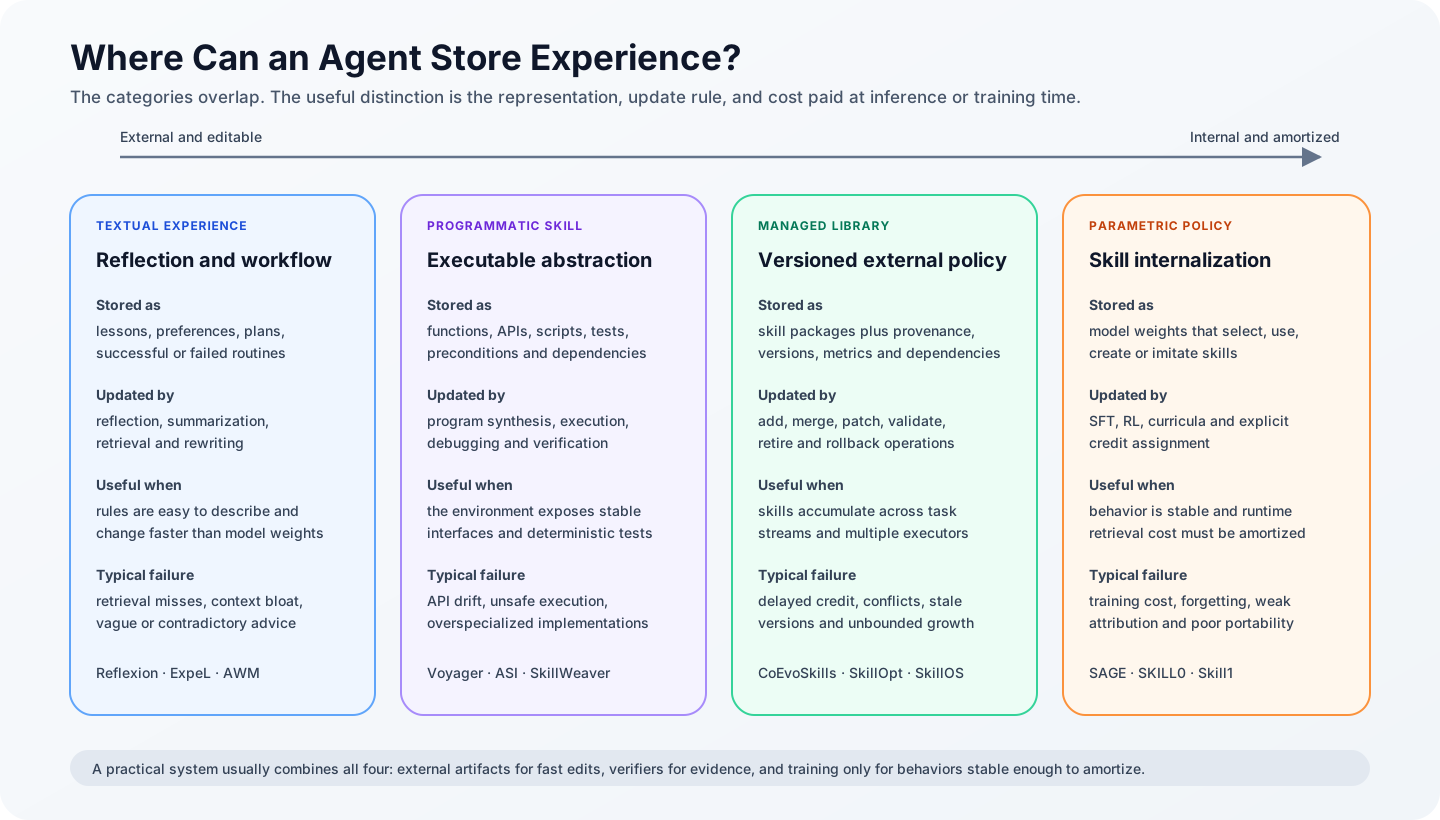
图 2:本文整理。文本、程序、受管技能库和参数内化并非互斥路线;实际系统通常同时使用。
3. 外部化文本经验:从任务内反思到跨任务工作流
3.1 Reflexion:从任务内重试开始
Reflexion 的做法很直接:agent 完成一次尝试后,根据标量反馈或语言反馈生成反思,把反思写进 episodic memory,再在下一次尝试中读回。模型权重不更新,学习发生在上下文里。该机制适合有明确重试机会的任务,例如代码测试失败后总结错误原因,或者在 ALFWorld 中根据环境反馈修正计划。
Reflexion 的贡献是把「失败后的语言总结」变成了可执行循环,但它主要解决同一任务或高度相似任务中的 retry。反思文本是否能跨任务复用、旧反思是否与新环境冲突、记忆满了以后保留什么,都没有自然答案。一次失败产生一句「下次先检查输入」,听起来合理,却可能没有足够证据支持它成为长期规则。
ExpeL 把视角从单次 retry 推向跨任务经验学习。它收集训练任务中的成功和失败经验,从对比中抽取自然语言 insight,并在推理时同时检索 insight 与相似轨迹。这里出现了一个后来反复出现的结构:原始案例保留具体证据,抽象经验负责迁移。两者缺一不可。只存案例会占满上下文,只存原则又容易丢掉适用条件。
3.2 AWM:把轨迹压缩成可复用 workflow
Agent Workflow Memory(AWM) 不再把整条轨迹或一句反思直接塞回 prompt,而是从 web navigation 任务中归纳经常重复的 routine,例如「搜索商品、进入详情页、核验属性、加入购物车」。它支持 offline induction,也支持测试时从已完成任务在线归纳 workflow。
AWM 在 Mind2Web 和 WebArena 上分别报告 24.6% 和 51.1% 的相对成功率提升,并减少成功任务所需的步骤。更有信息量的部分不只是分数,而是表示方式的变化:workflow 位于原子点击和完整任务之间,能压缩长轨迹,也允许新任务组合旧流程。
但 workflow 仍然是文本。页面元素改名、站点状态改变或动作参数需要精确绑定时,agent 必须再次解释文字并生成低层操作。误差会沿着「检索 workflow → 理解 workflow → 定位控件 → 执行动作」逐步累积。文本经验的灵活性来自解释空间,脆弱性也来自同一处。
3.3 ReasoningBank、AutoRefine 与 AutoSkill:文本库开始有生命周期
ReasoningBank 从 agent 自判的成功与失败经验中提炼 reasoning strategy,并用 memory-aware test-time scaling 生成更多有对比价值的轨迹。它比只存成功 routine 更重视失败经验,因为失败能够说明某种策略何时不成立。问题随之变成:如果自判本身不可靠,错误归因也会进入 memory bank。
AutoRefine 将经验分成两种形态:复杂过程被封装为带独立推理与记忆的 specialized subagent,静态知识则保存为 guideline 或 code snippet。它还显式加入评分、剪枝和合并,避免 repository 随经验增长而退化。AutoSkill 更关注长期用户交互,把稳定偏好和要求抽成标准化文本 skill,在后续会话中动态注入。
这条路线的共同优点是无需访问模型权重,更新快、可读、容易回滚,也适合闭源模型。代价同样清楚:
- 检索器必须从不断增长的库中找到真正相关的经验。
- 每次注入都消耗上下文,并可能挤掉当前任务的直接证据。
- 文本规则缺乏类型与执行保证,agent 可以「读过」却不遵守。
- 用户偏好、环境事实和任务流程具有不同有效期,统一放进一个向量库会掩盖版本问题。
因此,文本经验并没有被程序技能淘汰。它更适合保存变化快、难以形式化、需要人审阅的规则。真正需要警惕的是把「能写成一句话」误认为「已经学会」。
4. 程序化技能:把经验变成可执行接口
4.1 Voyager:代码技能库的早期范型
Voyager 在 Minecraft 中维护一个不断增长的 JavaScript skill library。每个 skill 是可执行代码;agent 根据任务检索相关函数,通过环境错误、执行反馈和自验证迭代代码。相比自然语言建议,函数可以直接调用、组合和测试,也能把多步低层动作压缩成一个高层接口。
Voyager 报告获得的独特物品数量是此前方法的 3.3 倍,并能把技能库迁移到新的 Minecraft 世界。这个结果说明程序表示对开放世界任务很有吸引力,但它也依赖一个相对理想的环境:动作接口明确、执行可以重试、结果可观察、错误不会造成真实损失。
OS-Copilot/FRIDAY 将类似思路扩展到操作系统任务。FRIDAY 能在网页、终端、文件和办公软件之间创建与复用技能。相比 Minecraft,通用电脑环境暴露了更多工程问题:不同应用的状态不可完全观察,GUI 操作不稳定,权限边界也更复杂。程序技能越接近真实系统,验证和隔离就越不能省略。
4.2 ASI:程序技能的价值来自验证,而不是代码外观
Agent Skill Induction(ASI) 在线归纳、验证并使用程序技能。论文在 WebArena 上报告相对静态 agent 提升 23.5%,相对文本技能提升 11.3%,同时减少 10.7%–15.3% 的执行步骤。作者把主要差异归因于 induction 阶段的程序化验证:候选技能需要通过正确性、可用性和有效性检查后才能进入库。
这个结论比「代码比文本稳定」更准确。LLM 生成的代码同样可能幻觉、写死页面结构或在边界输入上失败。程序表示真正增加的是可测试性。只要环境能够给出确定反馈,系统就可以拒绝错误技能,而不必仅凭另一个 LLM 判断一段说明是否合理。
SkillWeaver 让 web agent 自主探索网站、提出可练习的技能、反复执行,再把经验蒸馏成 API。它在 WebArena 与真实网站上分别报告 31.8% 和 39.8% 的相对成功率提升,并展示了强 agent 生成的 API 对弱 agent 的迁移价值。这里的重点是「honing」:一个 API 不是从单条成功轨迹剪出来就结束,而要经过多次练习,把偶然可用的脚本变成较稳健的接口。
4.3 PolySkill:把目标与实现拆开
程序技能容易过拟合具体网站。一个名为 search_product_amazon 的函数也许很好用,却很难迁移到另一个电商站。PolySkill 借用软件工程中的多态抽象,把 skill 的目标与具体实现分开:抽象层描述「完成什么」,实现层处理「在当前网站如何完成」。论文报告在已见网站上的技能复用提高 1.7 倍,在未见网站上成功率提升最高 13.9%。
这种分层缓解了「复用」与「适配」的冲突。抽象目标可以跨站点,具体实现仍允许按环境替换。但系统必须维护接口契约:输入输出、前置条件和副作用如果没有写清,多态只会把错误推迟到运行时。
程序化技能还引入文本记忆不具备的风险。skill 可以读写文件、调用网络、执行 shell,也可能在资源文件中隐藏恶意逻辑。PhantomSkill 展示了第三方 skill package 的供应链攻击面。对生产系统而言,程序技能至少需要沙箱、最小权限、依赖锁定、资源级扫描、执行审计和可撤销版本;「代码能跑」从来不是充分的接纳标准。
5. 技能库维护:生成后的版本、验证与归因
当技能只有十个时,embedding 检索加人工检查可能够用。数量增长到数百或跨多个 agent 共享后,skill library 更像一个持续变化的软件仓库。新增技能可能覆盖旧技能,两个局部正确的流程可能互相冲突,环境升级会让历史经验过期,而一次任务的最终分数很难说明是哪一个 skill 起了作用。
5.1 从轨迹归纳到版本化编辑
Trace2Skill 先让多个分析 agent 并行阅读不同执行轨迹,提取 trajectory-local lesson,再做分层归并,生成一份冲突较少的完整 skill directory。它强调不要按轨迹到达顺序逐条修补,因为顺序式更新容易被最近一次局部经验带偏。需要注意,2026 年还有一篇面向 EDA 的同名 Trace2Skill;本文引用的是 arXiv:2603.25158。
CoEvoSkills 将 Skill Generator 与独立的 Surrogate Verifier 隔离。Generator 负责修改多文件 skill package,Verifier 只看任务要求和产物,生成确定性断言并返回诊断。如果 surrogate test 通过但隐藏 oracle 仍失败,系统强化 verifier,而不是把隐藏测试内容泄露给 generator。这里演化的不只是 skill,也包括「如何检查 skill」。
SkillOpt 更像一个文本空间优化器:单独的 optimizer model 根据带分数的 rollout,对一份 skill 文档执行有边界的 add/delete/replace;只有 held-out validation 严格提升时才接受编辑。它还引入文本 learning-rate budget、rejected-edit buffer 和慢速 meta update。SkillGrad 则把失败诊断视为 text gradient,用 momentum memory 聚合重复出现的问题,再由 patcher 修改 skill package。
这些方法借用了梯度下降的语言,但不要把类比当成数学等价。文本编辑没有连续可微空间,LLM 产生的「梯度」也不是目标函数的解析导数。类比真正有用的部分是优化纪律:限制单次改动、保留拒绝历史、在独立验证集上验收、出现回归时回滚。
5.2 学习如何维护,而不是固定维护规则
SkillOS 冻结执行 agent,训练一个 curator 根据任务流和延迟反馈更新 SkillRepo。早期任务生成的技能要在后续相关任务中接受检验,这使维护动作获得长程信号。CODESKILL 面向 coding agent,把多粒度技能抽取和 skill-bank 维护建模成可学习策略,用 rubric 质量反馈与下游执行结果构成混合奖励,并约束技能库维持稳定规模。
技能维护的难点可以写成一个混杂的结果函数:
\[ R_t = F(\pi_t, x_t, H_t, \mathcal{S}_t, E_t, \xi_t), \]
其中 \(\pi_t\) 是当前模型,\(H_t\) 是 harness,\(\mathcal{S}_t\) 是本轮检索到的技能集合,\(E_t\) 是环境版本,\(\xi_t\) 表示采样随机性。任务成功并不能直接推出某个 skill 有效;失败也可能来自模型没有检索它、读了但没有执行、工具超时,或者环境已经变化。若维护器把所有结果都归因给 skill 内容,库会发生错误更新。
我的判断是,skill library 的核心数据结构不应只有正文和 embedding。至少还要保存来源轨迹、适用环境、依赖版本、使用次数、帮助/伤害的配对证据、最近验证时间和回滚点。否则「自动进化」很容易退化成自动追加。
6. SFT 与 RL:让模型学会选择、使用和内化技能
外部 skill 的好处是更新快,代价是每次推理都要检索、加载和解释。训练路线试图把这部分成本写入模型参数,但「skill-augmented RL」和「skill internalization」需要分开。
6.1 Skill 参与训练,不等于已经内化
SAGE 使用 Sequential Rollout,让 agent 在一串相似任务中逐步积累 skill,并设计 Skill-integrated Reward 鼓励技能生成和复用。在 AppWorld 上,论文报告 Scenario Goal Completion 提高 8.9%,交互步数减少 26%,token 减少 59%。技能仍然保存在外部库中,但 RL policy 开始学习如何在带技能的状态下行动。
SkillRL 从经验中蒸馏层级 SkillBank,区分通用启发式和任务特定技能,并让技能库与策略在 RL 中递归共同演化。它解决的主要问题是 raw trajectory 过长、噪声太多,而不是完全移除外部库。
这两类方法训练了 skill-aware policy,但推理时仍依赖 SkillBank。它们可能改善检索和使用,也可能把策略绑定到某种库结构。更换 backbone、harness 或 skill schema 后,迁移效果需要重新验证。
6.2 SKILL0:训练时给技能,推理时撤掉
SKILL0 对「内化」给出了更严格的定义:训练早期提供完整 skill context,随后通过动态 curriculum 逐步撤掉对当前 policy 仍有帮助的技能,直到模型在推理时不再检索 skill。论文在 ALFWorld 和 Search-QA 上分别报告相对标准 RL 基线提升 9.7% 和 6.6%,每步上下文控制在 0.5k token 以下。
该设计很像 privileged-information distillation:skill 在训练时充当脚手架,最终行为由参数承担。它降低运行时成本,却也失去外部文件的可编辑性。规则发生变化时,修改 Markdown 已经不够,需要重新训练或再蒸馏。哪些经验应进入权重,应该由稳定性决定,而不是由出现频率决定。用户偏好、业务规则和 API 细节变化快,长期外部化通常更安全;通用的分解策略、工具选择模式和错误恢复习惯更适合内化。
6.3 Skill1 与 SkillMaster:给 skill 生命周期分配训练信号
Skill1 用一个 policy 统一生成检索 query、重排并选择 skill、基于 skill 解题、再从轨迹中蒸馏新 skill。它试图从同一 task-outcome signal 中同时给选择、使用和蒸馏分配 credit,避免多个独立奖励把三个环节拉向不同方向。
SkillMaster 训练 agent 根据完整轨迹决定新建、更新或保留 skill,并用相关 probe task 上的 counterfactual utility 评价候选编辑。DualAdv-GRPO 分别估计任务动作和 skill-edit 决策的 advantage,减少两类时间尺度不同的更新互相干扰。
这两项工作抓住了 skill-centric RL 最难的一点:最终 reward 到底该奖励解题动作,还是奖励此前某次技能编辑?如果只在当前任务上验证,新 skill 可能记住实例;如果只看很久以后的任务,信号又太稀疏。counterfactual evaluation、配对 rollout 和分离 advantage 都是在缩短这条归因链。
7. 评测:分离技能质量、检索、使用与任务收益
早期论文往往比较「有经验模块」与「没有经验模块」的最终成功率。这个指标会把技能质量、检索、harness、模型能力和额外 token 混在一起。2026 年出现的一批 benchmark 开始拆开这些因素,结论比方法论文的单向提升更克制。
7.1 SkillsBench:人工技能有效,自生成技能未必
SkillsBench v4 当前包含 87 个任务、8 个领域和确定性 verifier,在 18 个 model–harness 配置上做 paired evaluation。curated skills 将平均通过率从 33.9% 提高到 50.5%,即 +16.6 个百分点;18 个配置都提升,但幅度从 +4.1pp 到 +25.7pp 不等。
这个正结果有三个重要限定:
- 87 个任务中有 13 个出现负增益,常见原因是 skill 指定了过重流程、挤掉模型本来更好的策略,或引入 agent 无法调试的 solver。
- 包含 2–3 个模块的 focused skill 优于大而全的文档,四个以上 skill 的平均增益明显下降。
- 在 Claude Code + Opus 4.7、Codex + GPT-5.5、Gemini CLI + Gemini 3.1 Pro 三个配置中,自生成 skill 分别比 no-skill 基线低 8.1、11.3 和 11.5 个百分点。审计发现一些 skill 根本没有被 solver 发现,另一些则固化了错误假设。
这组结果不支持「Agent 已经能稳定自己写 skill」。它支持的是更窄的结论:高质量、任务匹配的程序性指导可以显著帮助 agent;skill creation、discovery 和 applicability 仍是独立问题。
7.2 SWE-Skills-Bench:软件工程中的平均收益很小
SWE-Skills-Bench 将 49 个公开软件工程 skill 配对到固定 commit 的真实 GitHub 仓库,构造约 565 个带确定性验收测试的任务。论文报告平均提升只有 +1.2%,49 个 skill 中有 39 个没有带来通过率变化;token 开销最高增加 451%,还有三个 skill 因版本错配使结果下降,最大为 -10%。
软件工程任务已经被预训练数据、代码搜索和现有工具覆盖得较多,泛化的「先读代码、再写测试」未必提供增量信息。真正有效的往往是版本敏感、领域专用、能指出 verifier-facing 细节的 skill。这个结果也提醒我们:skill 的评测必须固定仓库版本和依赖,否则经验正确但环境过期,执行仍会失败。
7.3 SkillLearnBench、SkillRet 与 SRA-Bench:拆开生成、检索和使用
SkillLearnBench 包含 20 个经验证、依赖 skill 的任务,覆盖 15 个子领域,并在 skill quality、execution trajectory 和 task outcome 三个层级评估 continual learning。没有一种方法在所有任务和模型上领先;更强的 backbone 也不稳定地产生更好的 skill。多轮外部反馈能够带来真实改进,只依赖 self-feedback 则会出现 recursive drift。
当技能库进入万级规模,生成质量之外还有检索问题。SkillRet 收集 17,810 个公开 skill、63,259 个训练样本和 4,997 个评测 query,用 NDCG@10 等指标测试大规模路由。SRA-Bench 则把 pipeline 拆成 retrieval、incorporation 和 end-task execution。其分析发现,当前 agent 对「已经检索到 gold skill」和「任务是否真的需要外部能力」并不敏感,加载率相近。也就是说,召回正确 skill 以后,模型仍可能不会在正确时机使用。
7.4 GDPevo:评测跨任务规则归纳,而不是同题重试
GDPevo 面向 CRM、ERP 和 Finance,发布 12 个任务组、120 个真实业务任务。每组共享一个业务环境,包含 5 个训练任务和 5 个 held-out 测试任务。训练样本分散暴露元规则,测试样本重新组合这些规则,目的是区分规则归纳与答案记忆。评分使用确定性 rubric,同时报告 acc@3、token 和美元成本。
项目当前公开结果中,三套 agent 的 few-shot 或 reflection 设置都比 base acc@3 高约 18–20 个百分点,但成本变化从 -25.75% 到 +11.82% 不等。该项目不是同行评审 benchmark,结果也不能直接与 SkillsBench 对比;它有价值的地方是把「经验学习」定义成跨任务 transfer,并把成本放进同一张成绩表。
综合这些 benchmark,一套更完整的评测至少要覆盖:
| 层级 | 指标示例 | 需要隔离的问题 |
|---|---|---|
| 生成 | 事实正确性、流程覆盖、测试通过率 | 候选 skill 本身是否可靠 |
| 触发与检索 | Recall@k、NDCG、误触发率 | 是否找到该用的 skill,是否拒绝无关 skill |
| 使用 | invocation rate、步骤遵循、参数正确率 | 找到后是否真的正确执行 |
| 任务 | paired pass rate、reward delta | skill 对最终结果的边际贡献 |
| 成本 | token、时延、工具调用、训练算力 | 增益是否值得额外开销 |
| 迁移 | 跨任务、跨网站、跨模型、跨 harness | 学到的是规律还是实现细节 |
| 生命周期 | 回归率、库规模、陈旧率、回滚次数 | 长期积累是否持续改善而非逐步污染 |
| 安全 | 权限违规、恶意依赖、不可逆副作用 | 可执行经验是否扩大攻击面 |
8. 工程实现:构建可审计的经验学习闭环
论文方法常在干净 benchmark 中验证一个局部模块。真实系统需要把这些模块接成可审计的工程闭环。我更倾向于采用下面的约束。
首先,轨迹记录要保留因果上下文。只存最终回答和 reward 不够,还要记录环境版本、tool schema、加载过的 skill、模型与 harness 版本、关键中间产物,以及 verifier 的逐项反馈。没有这些元数据,后续很难区分 skill 错误与环境漂移。
其次,skill creation 应设置证据门槛。单条成功轨迹适合进入候选区,不适合直接成为全局规则。系统可以要求多条独立轨迹支持,或者至少在相关 held-out probe 上通过配对验证。失败经验同样要保留,但应写成「在条件 C 下策略 P 失败」,而不是泛化为「永远不要使用 P」。
第三,检索需要一个明确的 abstain 分支。很多实现默认 top-k 必须返回内容,结果是即使库里没有匹配 skill,agent 也会加载语义上最接近的错误流程。retriever 应同时估计相关性、前置条件、环境兼容性和预计成本;低于阈值时,no-skill 往往是更好的选择。
第四,技能更新要像软件发布。候选版本先在 shadow 或 canary 任务中运行,比较 no-skill、旧版本和新版本;通过后再提升为 active,出现回归可以回滚。对程序 skill 还要锁定依赖、限制权限并记录副作用。合并两个技能时,应重新验证组合,而不是假设局部正确能够相加。
第五,参数内化只处理稳定模式。模型权重适合吸收跨环境通用、调用频率高、外部加载成本大的行为,例如先检查工具返回、在不可逆操作前确认状态、根据任务类型选择搜索或代码执行。经常变化的政策、用户偏好和 API 细节继续保留在外部文件里。这样既能降低运行时上下文,又保留快速修订能力。
最后,维护器本身也要被评测。一个会不停生成 skill 的 agent 很容易在短期 demo 中显得勤奋,长期却让库规模、冲突和检索成本失控。真正有用的维护策略应该愿意删除、合并、拒绝和回滚。增长不是目标,经过成本与风险折算后的长期边际效用才是。
9. 结论
Agent 经验学习的研究确实正在转向 skill-centric 表示,但「skill-centric」还不能等同于「已经能够自我进化」。现有证据更接近下面的判断:
- 语言反思和 workflow 能以低成本保存经验,瓶颈在检索、上下文和适用边界。
- 程序技能提高了组合性与可测试性,也把接口漂移、执行安全和依赖管理带进系统。
- 技能库一旦持续增长,核心问题会从生成转向 credit assignment、版本化验证和回归控制。
- RL 可以训练模型选择、使用和编辑 skill;真正的参数内化还需要在推理时撤掉外部脚手架后保持能力。
- benchmark 已经证明 curated skill 能显著有用,也证明自生成 skill、错误检索和额外成本足以抵消收益。
因此,下一阶段更值得追踪的不是 agent 一次能写出多少 skill,而是它能否在稀疏反馈下回答四个具体问题:这条经验是否可迁移,应该在什么条件下触发,怎样证明它确实带来边际收益,以及环境变化后何时应当修订或删除。能稳定回答这些问题,经验才算真正积累下来。