flowchart TB
    L0["<b>L0 · 无自治</b><br/>智能体:不参与<br/>人:执行全部任务并承担责任"]
    L1["<b>L1 · 辅助</b><br/>智能体:无状态响应者<br/>人:执行并验证建议"]
    L2["<b>L2 · 部分自治</b><br/>智能体:程序执行器<br/>人:编排流程并负责结果"]
    L3["<b>L3 · 条件自治</b><br/>智能体:端到端编排器<br/>人:监督计划与结果"]
    L4["<b>L4 · 高度自治</b><br/>智能体:主动自治组件<br/>人:完全授权,不再监督"]
    L5["<b>L5 · 完全自治</b><br/>智能体:生成式数据科学家<br/>人:不再参与"]

    L0 -->|响应请求| L1
    L1 -->|感知环境并执行| L2
    L2 -->|接管流程编排| L3
    L3 -->|主动发现任务| L4
    L4 -->|发明方法与范式| L5

    classDef baseline fill:#f3f4f6,stroke:#6b7280,color:#111827,stroke-width:2px;
    classDef current fill:#e8f1ff,stroke:#2563eb,color:#172554,stroke-width:2px;
    classDef frontier fill:#fff3cd,stroke:#d97706,color:#451a03,stroke-width:3px;
    classDef vision fill:#f3e8ff,stroke:#9333ea,color:#3b0764,stroke-width:2px,stroke-dasharray:6 4;
    class L0 baseline;
    class L1,L2 current;
    class L3 frontier;
    class L4,L5 vision;
数据智能体:自治等级、研究现状与开放问题
基于 L0–L5 自治分级和数据生命周期视角,梳理数据智能体从响应式助手、程序执行器到受监督编排器的能力边界,并分析责任、治理与评测缺口。
如果把能生成 SQL 的聊天框、能运行 notebook 的执行器和能调整分析流程的 planner 都叫作 Data Agent,这个名称几乎失去了区分能力。用户看到的是同一个产品标签,系统实际承担的任务范围、失败后果和责任却完全不同:Data Agents: Levels, State of the Art, and Open Problems 要解决的正是这类术语混用。
论文借用了自动驾驶的分级思路,把数据智能体分为 L0–L5。真正有价值的部分不在六个等级本身,而在分级同时追问了三个问题:谁决定下一步做什么,谁能直接改变数据与系统,失败后责任仍由谁承担。沿这条线看,当前研究的主体仍在 L1 和 L2,少量系统开始表现出端到端编排能力,论文谨慎地称之为 Proto-L3。L4 和 L5 则是研究愿景,不是已经被基准验证的产品能力。
领读图:六个等级描述的是任务支配权如何从人转向智能体,依次跨过响应请求、环境交互、流程编排、任务发现和方法创新五道边界。蓝色表示已经形成稳定模式的 L1–L2,琥珀色表示 Proto-L3 研究前沿,紫色虚线表示论文对 L4–L5 的愿景。定义压缩自论文第 2.2.1 节。
图 1:论文标题与作者。Yuyu Luo、Guoliang Li、Ju Fan、Nan Tang 分别来自 HKUST(GZ)、清华大学和中国人民大学。来源:论文 PDF,第 1 页。
Warning证据范围
本文阅读的是 2026 年 2 月发布的 9 页 SIGMOD 2026 tutorial proposal。它给出课程结构、分类框架、代表系统和研究路线,没有提出一个统一新算法,也没有提供一组覆盖 L0–L5 的新实验。文中涉及 Data Interpreter、AgenticData 和 DeepAnalyze 的结果均来自各自论文,模型、任务、基线和成本口径不同,不能拼成跨论文排行榜。本文没有复现这些系统。
1. 先确定论文类型:这是教学框架,不是统一实证研究
这篇论文的形式很容易影响阅读判断。它描述的是一场三小时 tutorial:140 分钟讲授,40 分钟 playground。前四部分依次覆盖问题定义、L0–L2、Proto-L3、L4–L5 与开放问题;最后让参与者观察不同层级系统的工作过程。正文大量使用「we will」,说明其任务是组织材料和建立共同语言,而不是报告一项已经完成的大规模实验。
论文与 2025 年综述 A Survey of Data Agents: Emerging Paradigm or Overstated Hype? 的关系也需要说清。tutorial 摘要写道「提出首个层级 taxonomy」,但引言同时明确说明,近期工作已经给出了从 L0 到 L5 的分类,tutorial 建立在该综述之上,并将其转化为面向 SIGMOD 听众的教学框架。更稳妥的归因是:L0–L5 taxonomy 属于这条连续研究工作的核心产物,2025 年综述承担系统展开,2026 年论文负责教学化整理。不能因为只读到 tutorial 摘要,就把分类的全部原创性归给这 9 页文本。
这种文本仍然值得细读。Data Agent 的讨论长期被产品名称带着走:接上 LLM、加几个工具、再画一张多智能体架构图,系统就被描述成「AI data scientist」。tutorial 把争论从命名移到可检查的边界:环境是否可见、流程由谁设计、任务是否需要显式触发、人工处于执行者还是监督者位置。它提供的是分析坐标系。
2. 正式定义:对象不是聊天记录,而是 Data+AI 环境
论文把数据智能体写成一个抽象映射:
\[ \mathcal{A} : (\mathcal{T}, \mathcal{D}, \mathcal{E}, \mathcal{M}) \rightarrow \mathcal{O}, \]
其中 \(\mathcal{T}\) 是数据任务,\(\mathcal{D}\) 是原始数据,\(\mathcal{E}\) 是 DBMS、代码解释器、API 等运行环境,\(\mathcal{M}\) 是所使用的 LLM,\(\mathcal{O}\) 是输出。输出不只包括自然语言,也可能是配置、处理后的数据、可视化、分析报告,甚至对生产系统的修改。
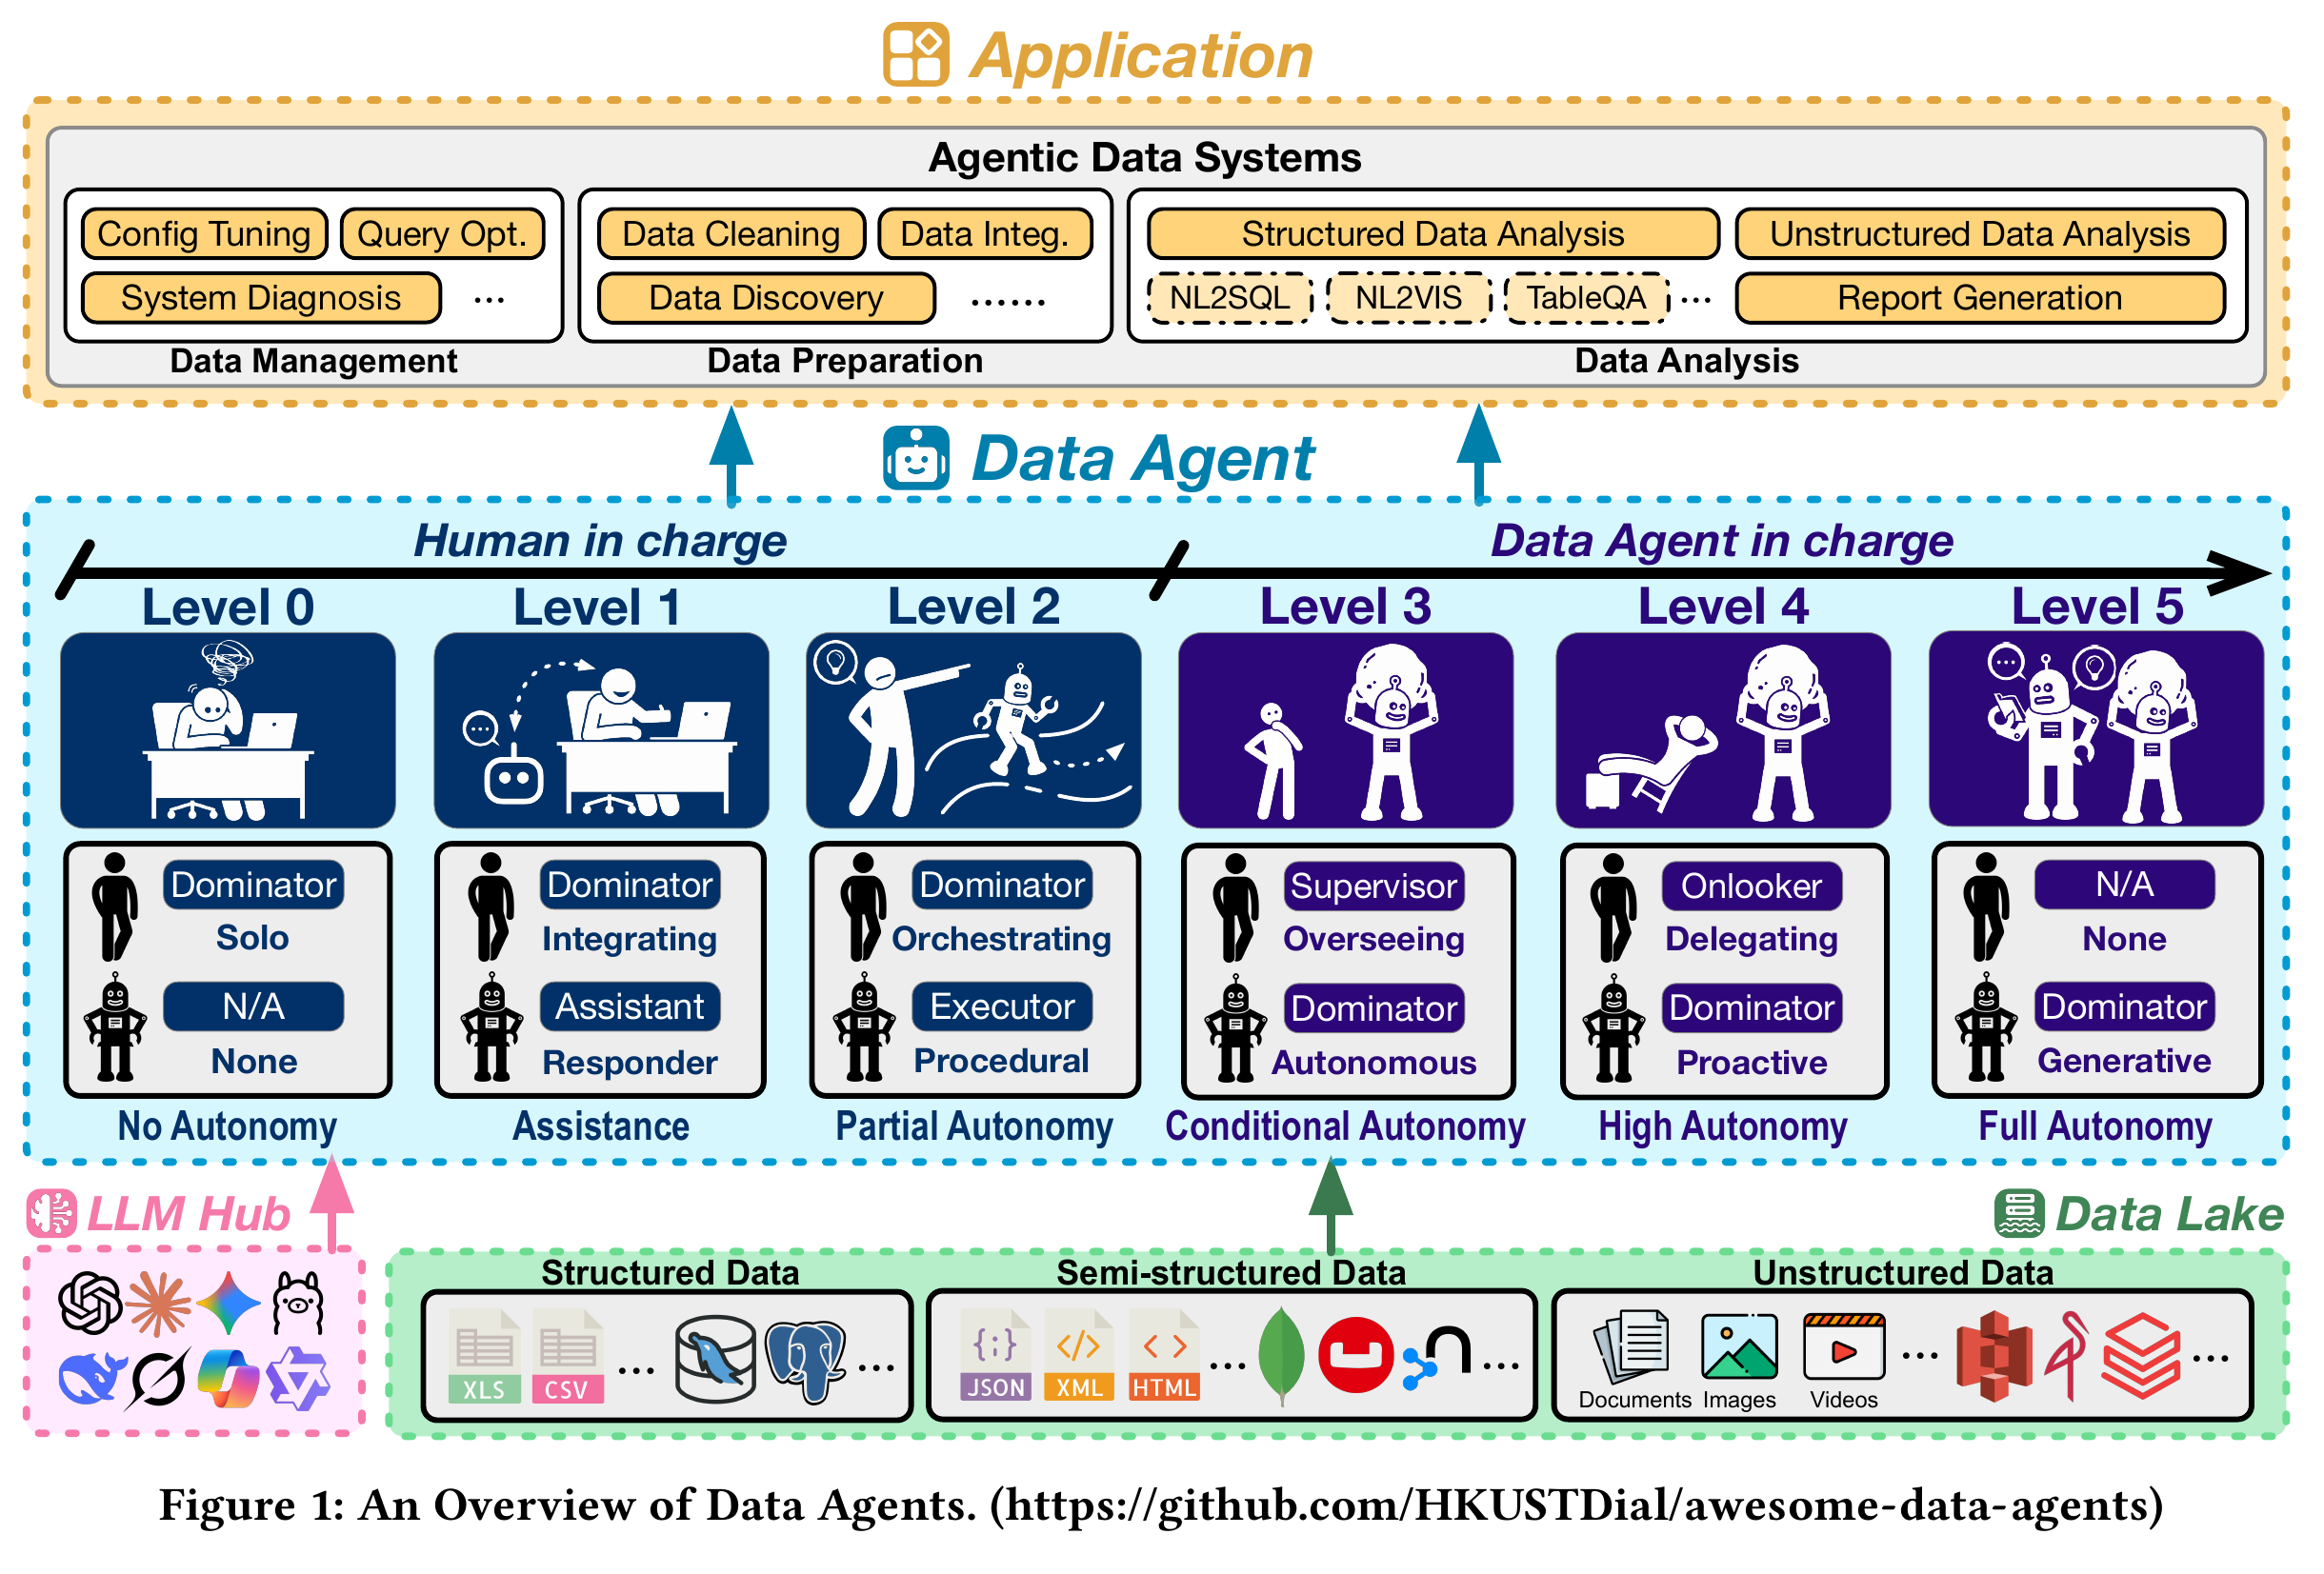
图 2:原论文 Figure 1。上方按数据管理、数据准备和数据分析划分应用,中间用 L0–L5 表示控制权从人转向智能体,下方连接 LLM Hub 与异构 Data Lake。来源:论文 PDF,第 1 页。
这个定义足够宽,可以容纳 SQL 助手和「生成式数据科学家」,但它不是一个可直接执行的测试。式子没有显式表示历史状态、策略约束、权限、人工审批和失败恢复;这些因素被折叠进 \(\mathcal{E}\) 或智能体实现。它回答的是「什么系统可以纳入讨论」,没有回答「某个系统究竟属于哪一级」。分级仍要观察控制流和责任。
论文对通用 LLM Agent 与 Data Agent 的比较比定义更具体。通用 agent 往往处理相对有限、已经整理好的输入,产物直接交给人阅读;Data Agent 面向数据生命周期,要在大规模、异构、动态且有噪声的数据中发现和处理对象,调用数据库加载器、SQL 等价性检查器、可视化库等专用工具。两者并非互斥集合。差别来自任务环境和后果,而不是模型架构换了一个名字。
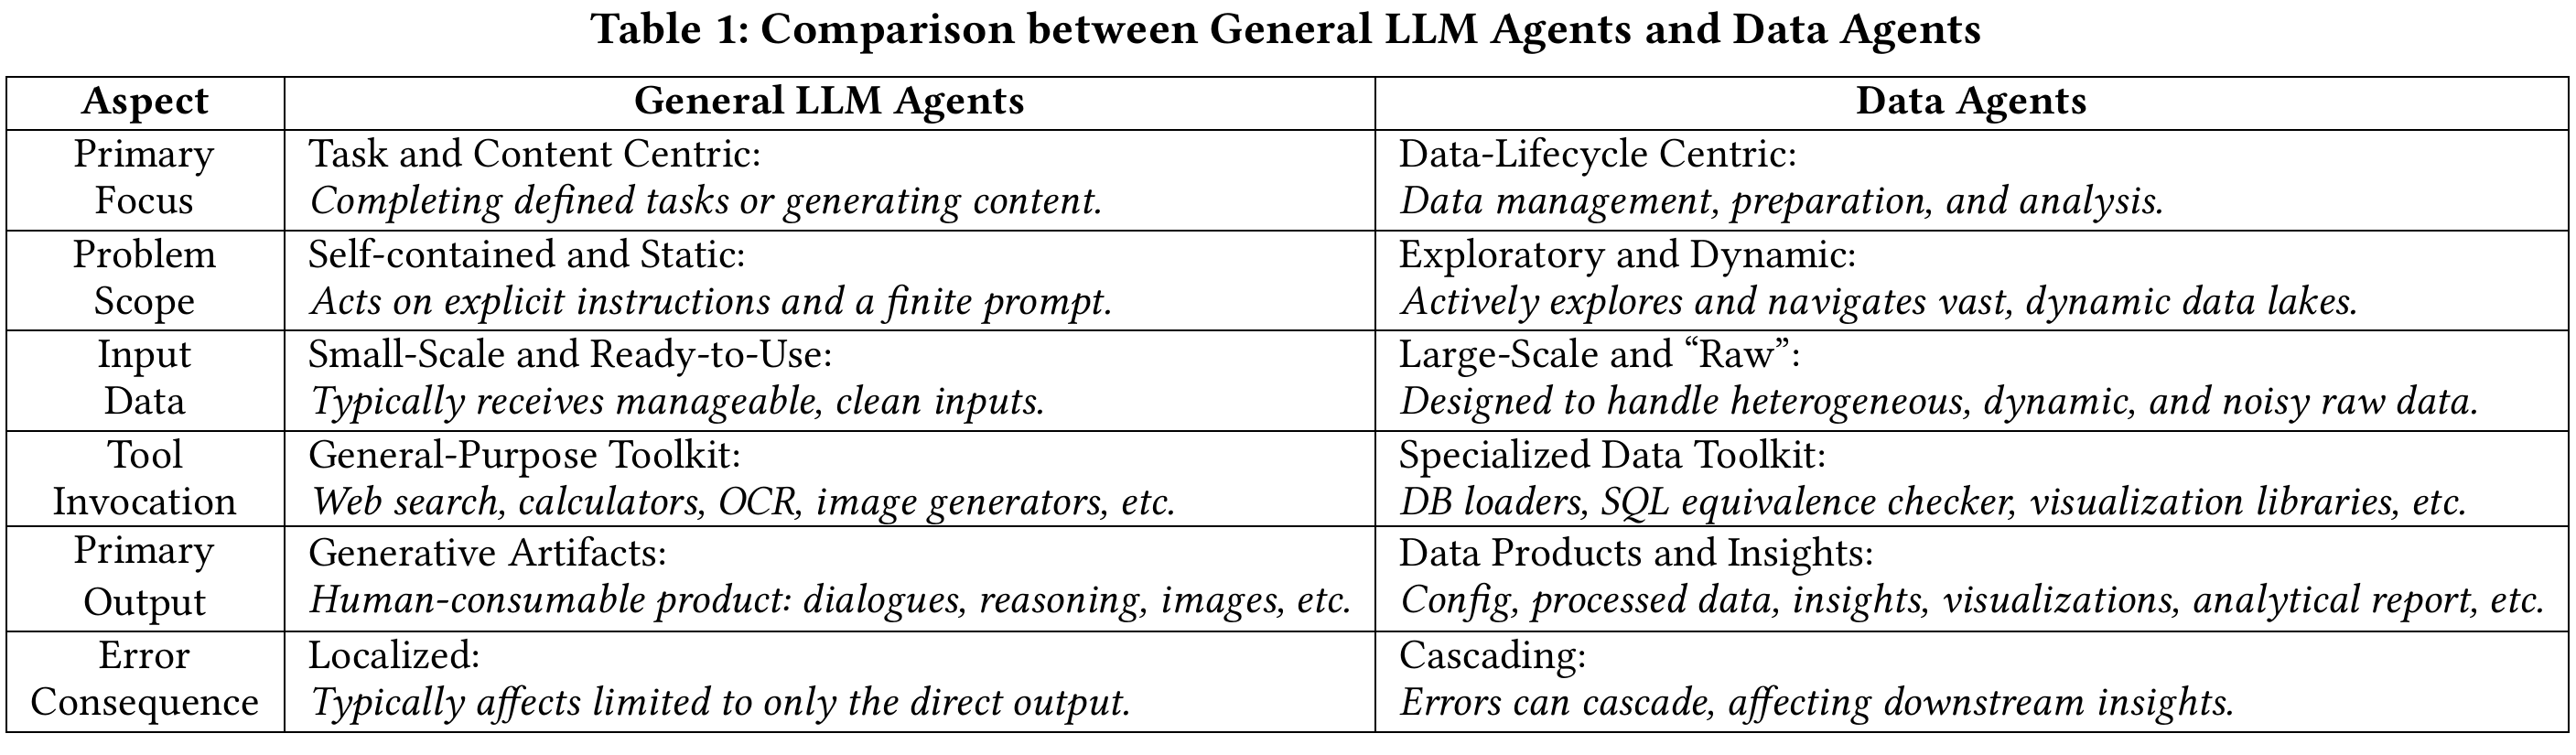
图 3:原论文 Table 1,从主要目标、问题范围、输入数据、工具、输出和错误后果比较两类 agent。来源:论文 PDF,第 3 页。
表中最需要保留的是 error consequence。聊天回答中的错误通常停留在当前输出;数据流程的错误会向下游传播。连接键选错可能让样本分布改变,错误样本进入模型训练,模型结果再被写进报告。最终文字即使流畅,证据链也可能已经断裂。Data Agent 因而不能只用「最终答案是否像对的」来评估。中间数据版本、执行计划、工具返回、约束检查和修改记录都进入系统边界。
我倾向于把数据智能体定义压缩成一句工程判据:它必须对数据对象和数据系统形成可观察的闭环。 只在 prompt 中阅读一小段 CSV 并回答问题,仍可算数据助手;只有当系统能读取环境状态、对数据或流程采取动作、根据反馈修改后续步骤时,「agent」才开始具有操作含义。至于是否达到 L3,还要看谁组织这条闭环。
3. L0–L5:等级改变的是任务支配权
论文借鉴 SAE J3016 的形式,把六级自治与 human/agent role 绑定。下面的表格按正文定义重写,不把产品宣传语作为分级证据。
| 等级 | 智能体角色 | 人的角色 | 可观察边界 |
|---|---|---|---|
| L0:No Autonomy | 不参与 | 完成全部工作并承担全部责任 | 手工脚本、规则和传统数据工具,不存在 agent 决策 |
| L1:Assistance | Stateless responder | 设计、执行并验证流程 | 根据 prompt 回答、生成代码或提出 SQL/清洗建议;不感知也不操作实时环境 |
| L2:Partial Autonomy | Procedural executor | 编排流程并负责结果 | 读取 DBMS、数据湖或代码环境,调用工具并利用执行反馈;任务步骤仍由人规定 |
| L3:Conditional Autonomy | Autonomous orchestrator | 监督计划与结果 | 理解高层意图,自行设计、执行、修正跨阶段流程;人在边界条件下介入 |
| L4:High Autonomy | Proactive component | 旁观或授权 | 持续监测 Data+AI 系统,主动发现问题与机会,不依赖显式任务请求 |
| L5:Full Autonomy | Generative data scientist | 不再参与 | 发现现有方法的缺口,提出、实验并迭代新算法或新范式 |
L1 与 L2 的分界是环境交互。L1 可以生成一段正确 SQL,但它不负责连接数据库、执行语句、检查返回结果;L2 可以完成这些步骤,维护一定状态,并在既定流程内依据错误信息重试。这里已有自动执行,却没有流程所有权。人仍决定「先查哪些表、什么时候做质量检查、失败后是否更换分析方法」。
L2 与 L3 的分界更难。论文将 L3 称为 conditional autonomy:用户给出高层目标,智能体据此编排覆盖数据管理、准备和分析的定制流程,并在中间结果发生变化时重新规划;人从 pipeline designer 退到 supervisor。由此可见,一次 function call、一个 ReAct 循环或固定 DAG 上的自动重试都不足以证明 L3。它们说明系统会执行,不说明系统能决定应该执行什么。
L4 又增加了任务发现。L3 仍由「帮我分析客户流失」之类的明确请求触发;L4 要持续观察数据漂移、性能退化、schema 变化、缺失索引或潜在分析机会,自行决定何时启动工作。L5 再把边界推到方法创新:智能体不只组合已有算子,还要判断现有方法为何不足,提出假设,设计实验并比较替代方案。
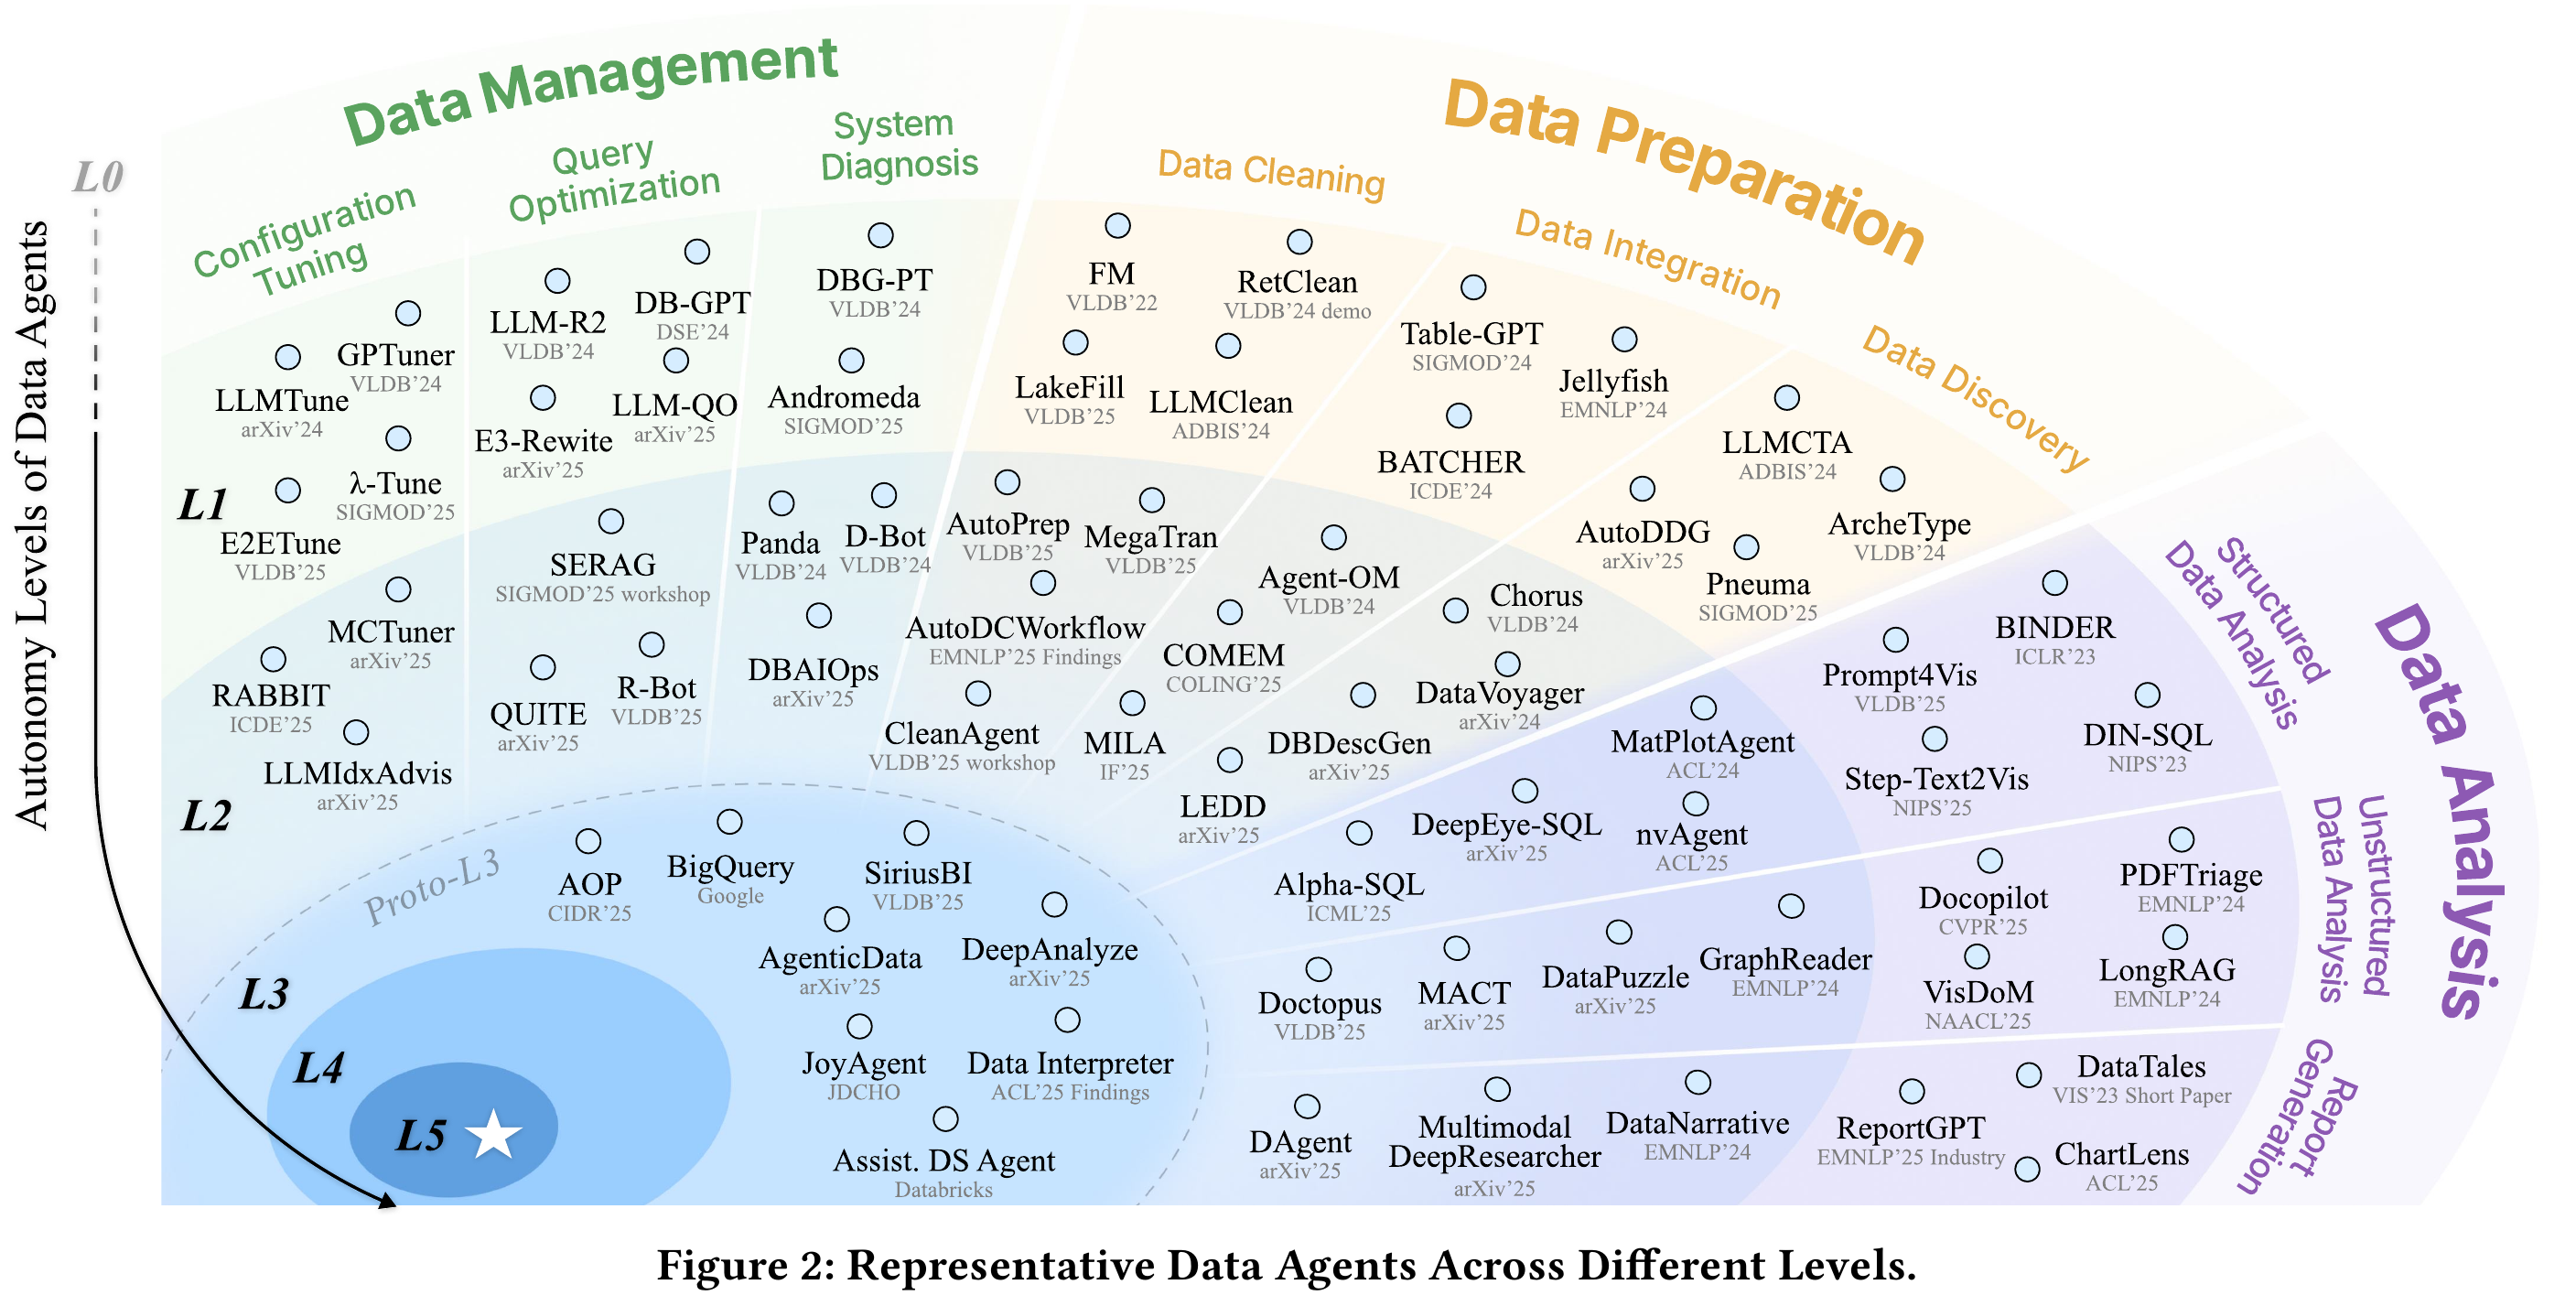
图 4:原论文 Figure 2。横向覆盖数据管理、准备与分析,纵向表示自治等级;当前系统密集分布在 L1、L2 和 Proto-L3。来源:论文 PDF,第 4 页。
这张图适合看研究分布,不适合当作精确 leaderboard。纵轴混合了环境感知、编排范围、主动性和责任四种属性,横向的不同任务也有不同风险:让 agent 生成一张可视化与让它改数据库配置,不能只按「自动完成多少步骤」比较。图中 L4/L5 的色块更接近方向标记。正文也明确说 fully realized L4/L5 remains speculative。
4. 从 L2 到 L3:编排、监督与责任必须同时变化
论文对 L3 的示意图给出了最小控制回路。用户提交任务并监督,L3 agent 拥有 perception、planning、memory、tool calling 等能力;它在工具和数据湖构成的环境中执行,循环优化 pipeline,最后返回答案。
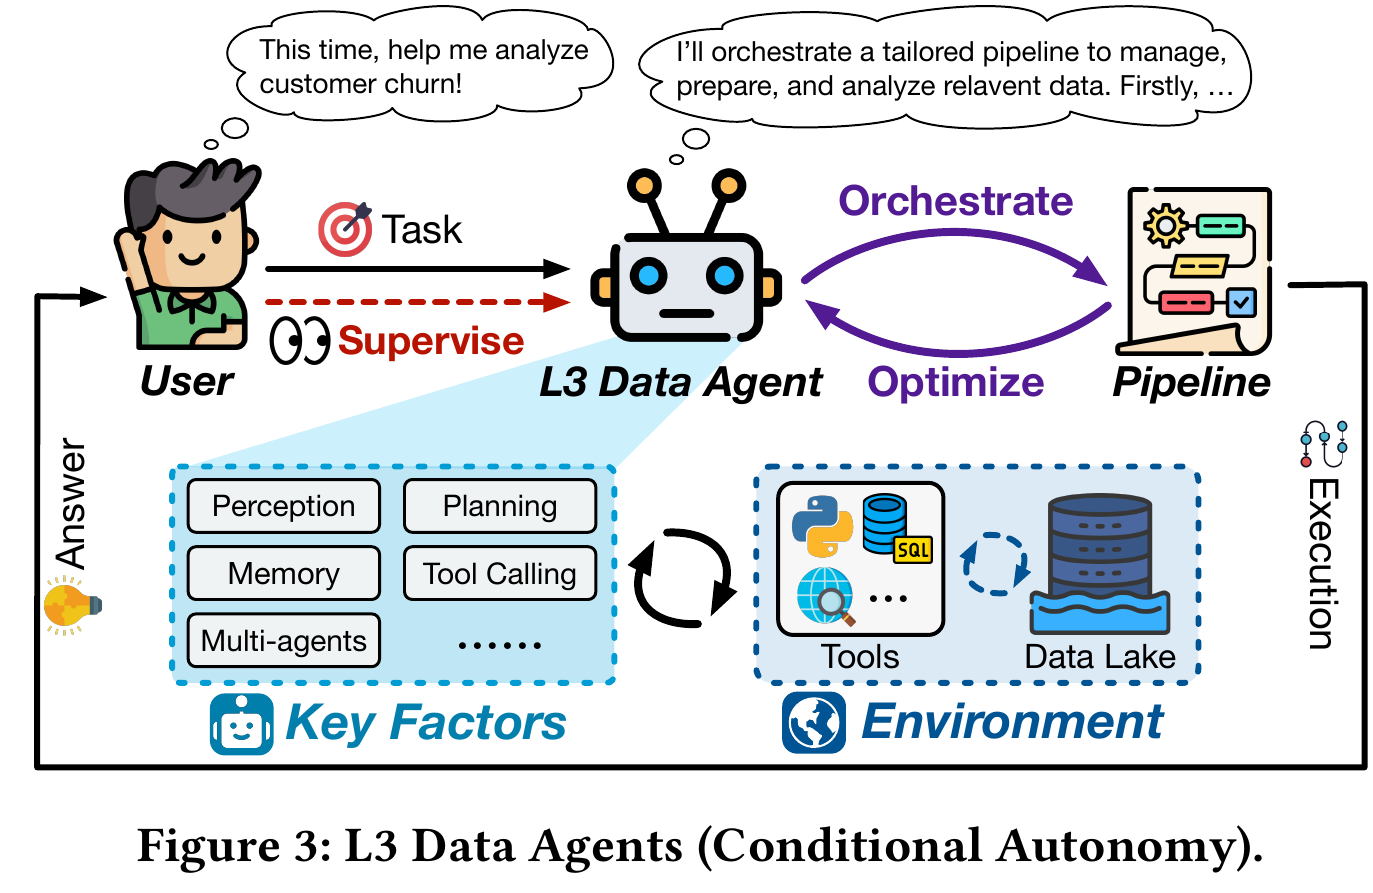
图 5:原论文 Figure 3。L3 agent 接受高层任务,在监督下编排并优化 pipeline,通过工具和数据湖形成执行反馈。来源:论文 PDF,第 5 页。
判断一个系统是否跨过 L2→L3,我会检查五类证据。
首先,输入是否只是高层目标,而不是人写好的步骤。其次,计划是否跨越数据发现、准备、建模和报告中的多个阶段。再次,中间结果失败时,系统能否改变任务图,而不是只重试同一段代码。第四,验证是否覆盖语义正确性和数据质量,而不只是程序退出码。最后,人工是否真的转为监督:如果每一步都要人选择工具、确认字段和决定后续路径,架构图即使写着 orchestrator,责任仍停在 L2。
4.1 用一个客户流失任务检查等级
同一条「分析客户流失」指令可以落在多个等级,区别不在报告长度。L1 接收人工准备好的表结构和字段样例,生成 SQL、Python 代码或分析建议;人选择数据、运行代码并解释结果。即使回答里包含十步计划,它仍未与环境闭环。
L2 可以连接仓库,读取客户、订阅和交互表,执行已注册的 profiling、join、训练和绘图工具。执行器发现列名错误后修复 SQL,模型训练失败后按既定 fallback 更换参数。这已经减少大量手工操作,但数据源、步骤顺序、目标变量、评测指标和停止条件仍由人写入 workflow。系统更像一台能看仪表盘的自动化设备。
Proto-L3 接收的是业务目标和约束,例如「解释过去一个季度高价值客户流失的变化,不得读取受限字段,不允许写回生产表」。它先检索可用数据和 lineage,判断订阅取消、客服记录与产品使用日志能否合法连接;随后自行安排数据质量检查、时间切分、泄漏检测、基线比较和报告生成。如果发现高价值标签只在流失后写入,它应当改变特征方案而不是让训练继续;若一项关键表无权限访问,则说明证据缺口、调整问题或请求批准。
完整 L3 的难点出现在最后一段:系统不只要产生新计划,还要对计划的适用性负责,并把高影响选择暴露给 supervisor。L4 会在没有分析请求时持续观察留存指标和 schema 变化,主动提出该任务;L5 则要在现有生存分析或因果方法不足时形成新假设并设计对照实验。由此可见,最终报告可能完全相同,自治等级却取决于报告之前的任务发现、计划控制和责任链。
这五项不必同时以相同强度出现。也正因为如此,论文使用 Proto-L3,而没有把新系统直接标为完整 L3。Proto-L3 表示它已经提供某些编排证据,同时仍依赖受限工具集、精心准备的数据、人工规则或较窄任务分布。
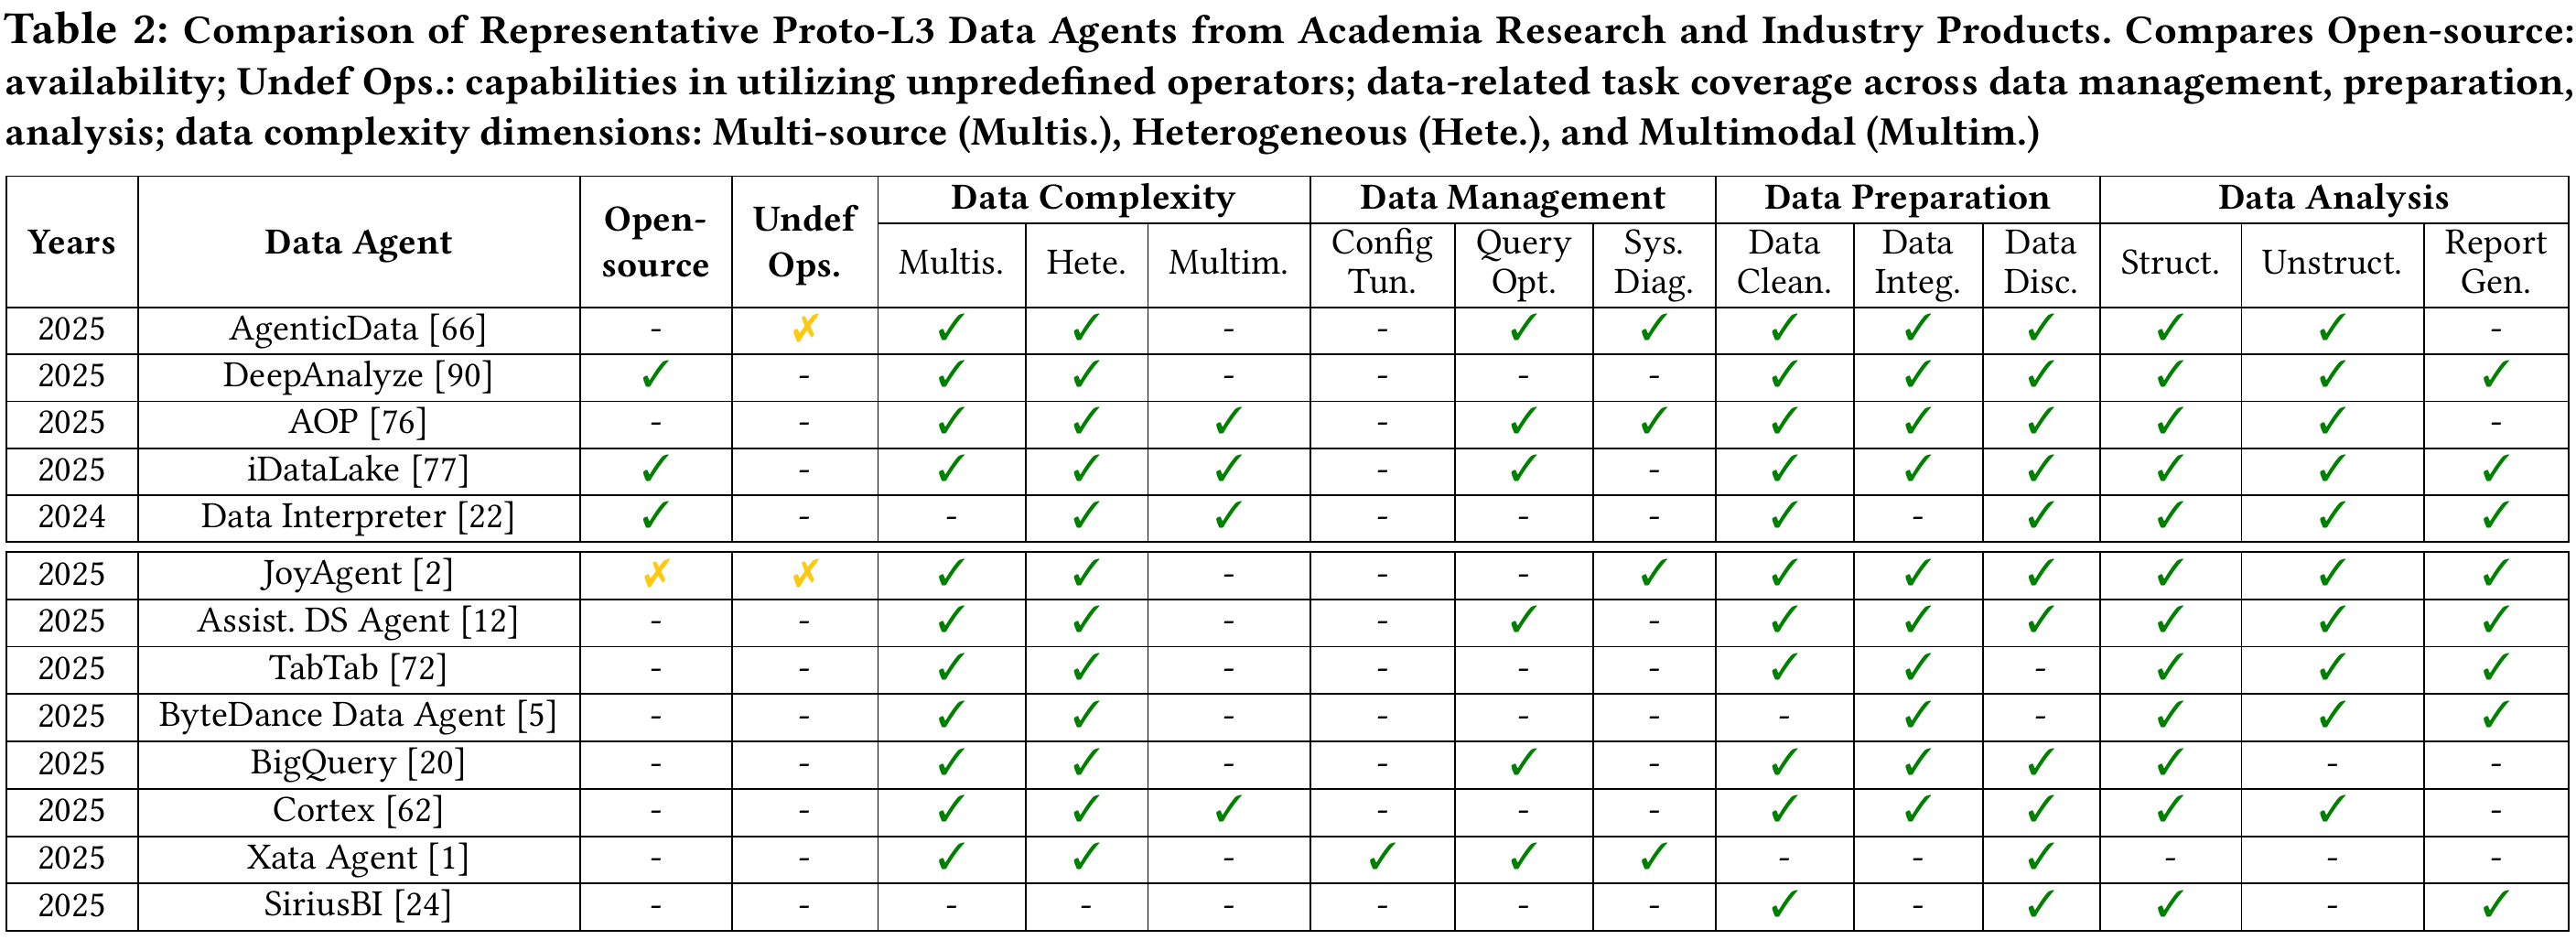
图 6:原论文 Table 2,比较开源情况、未预定义算子、数据复杂度与生命周期任务覆盖。上半部分是学术系统,下半部分是行业产品。来源:论文 PDF,第 6 页。
Table 2 提供了一个广度视图:系统能否处理多源、异构、多模态数据,覆盖配置、查询优化、清洗、集成、发现、结构化和非结构化分析。它没有直接测量责任转移。一个系统勾选了十个任务,仍可能靠固定 router 把请求分发给十个专家;另一个系统覆盖面较窄,却能自行重构任务图。任务覆盖和自治等级相关,但不是同一个量。
5. 三个 Proto-L3 样本:能力究竟落在哪里
5.1 Data Interpreter:任务图与动作图分层
Data Interpreter 把数据科学项目分成两层图。Task graph 表达数据探索、相关性分析、特征工程、训练、评估和可视化等高层依赖;每个 task 再被拆成可执行 action graph。Task Graph Generator、Action Graph Generator 和 Graph Executor 分别负责规划、代码化和执行。
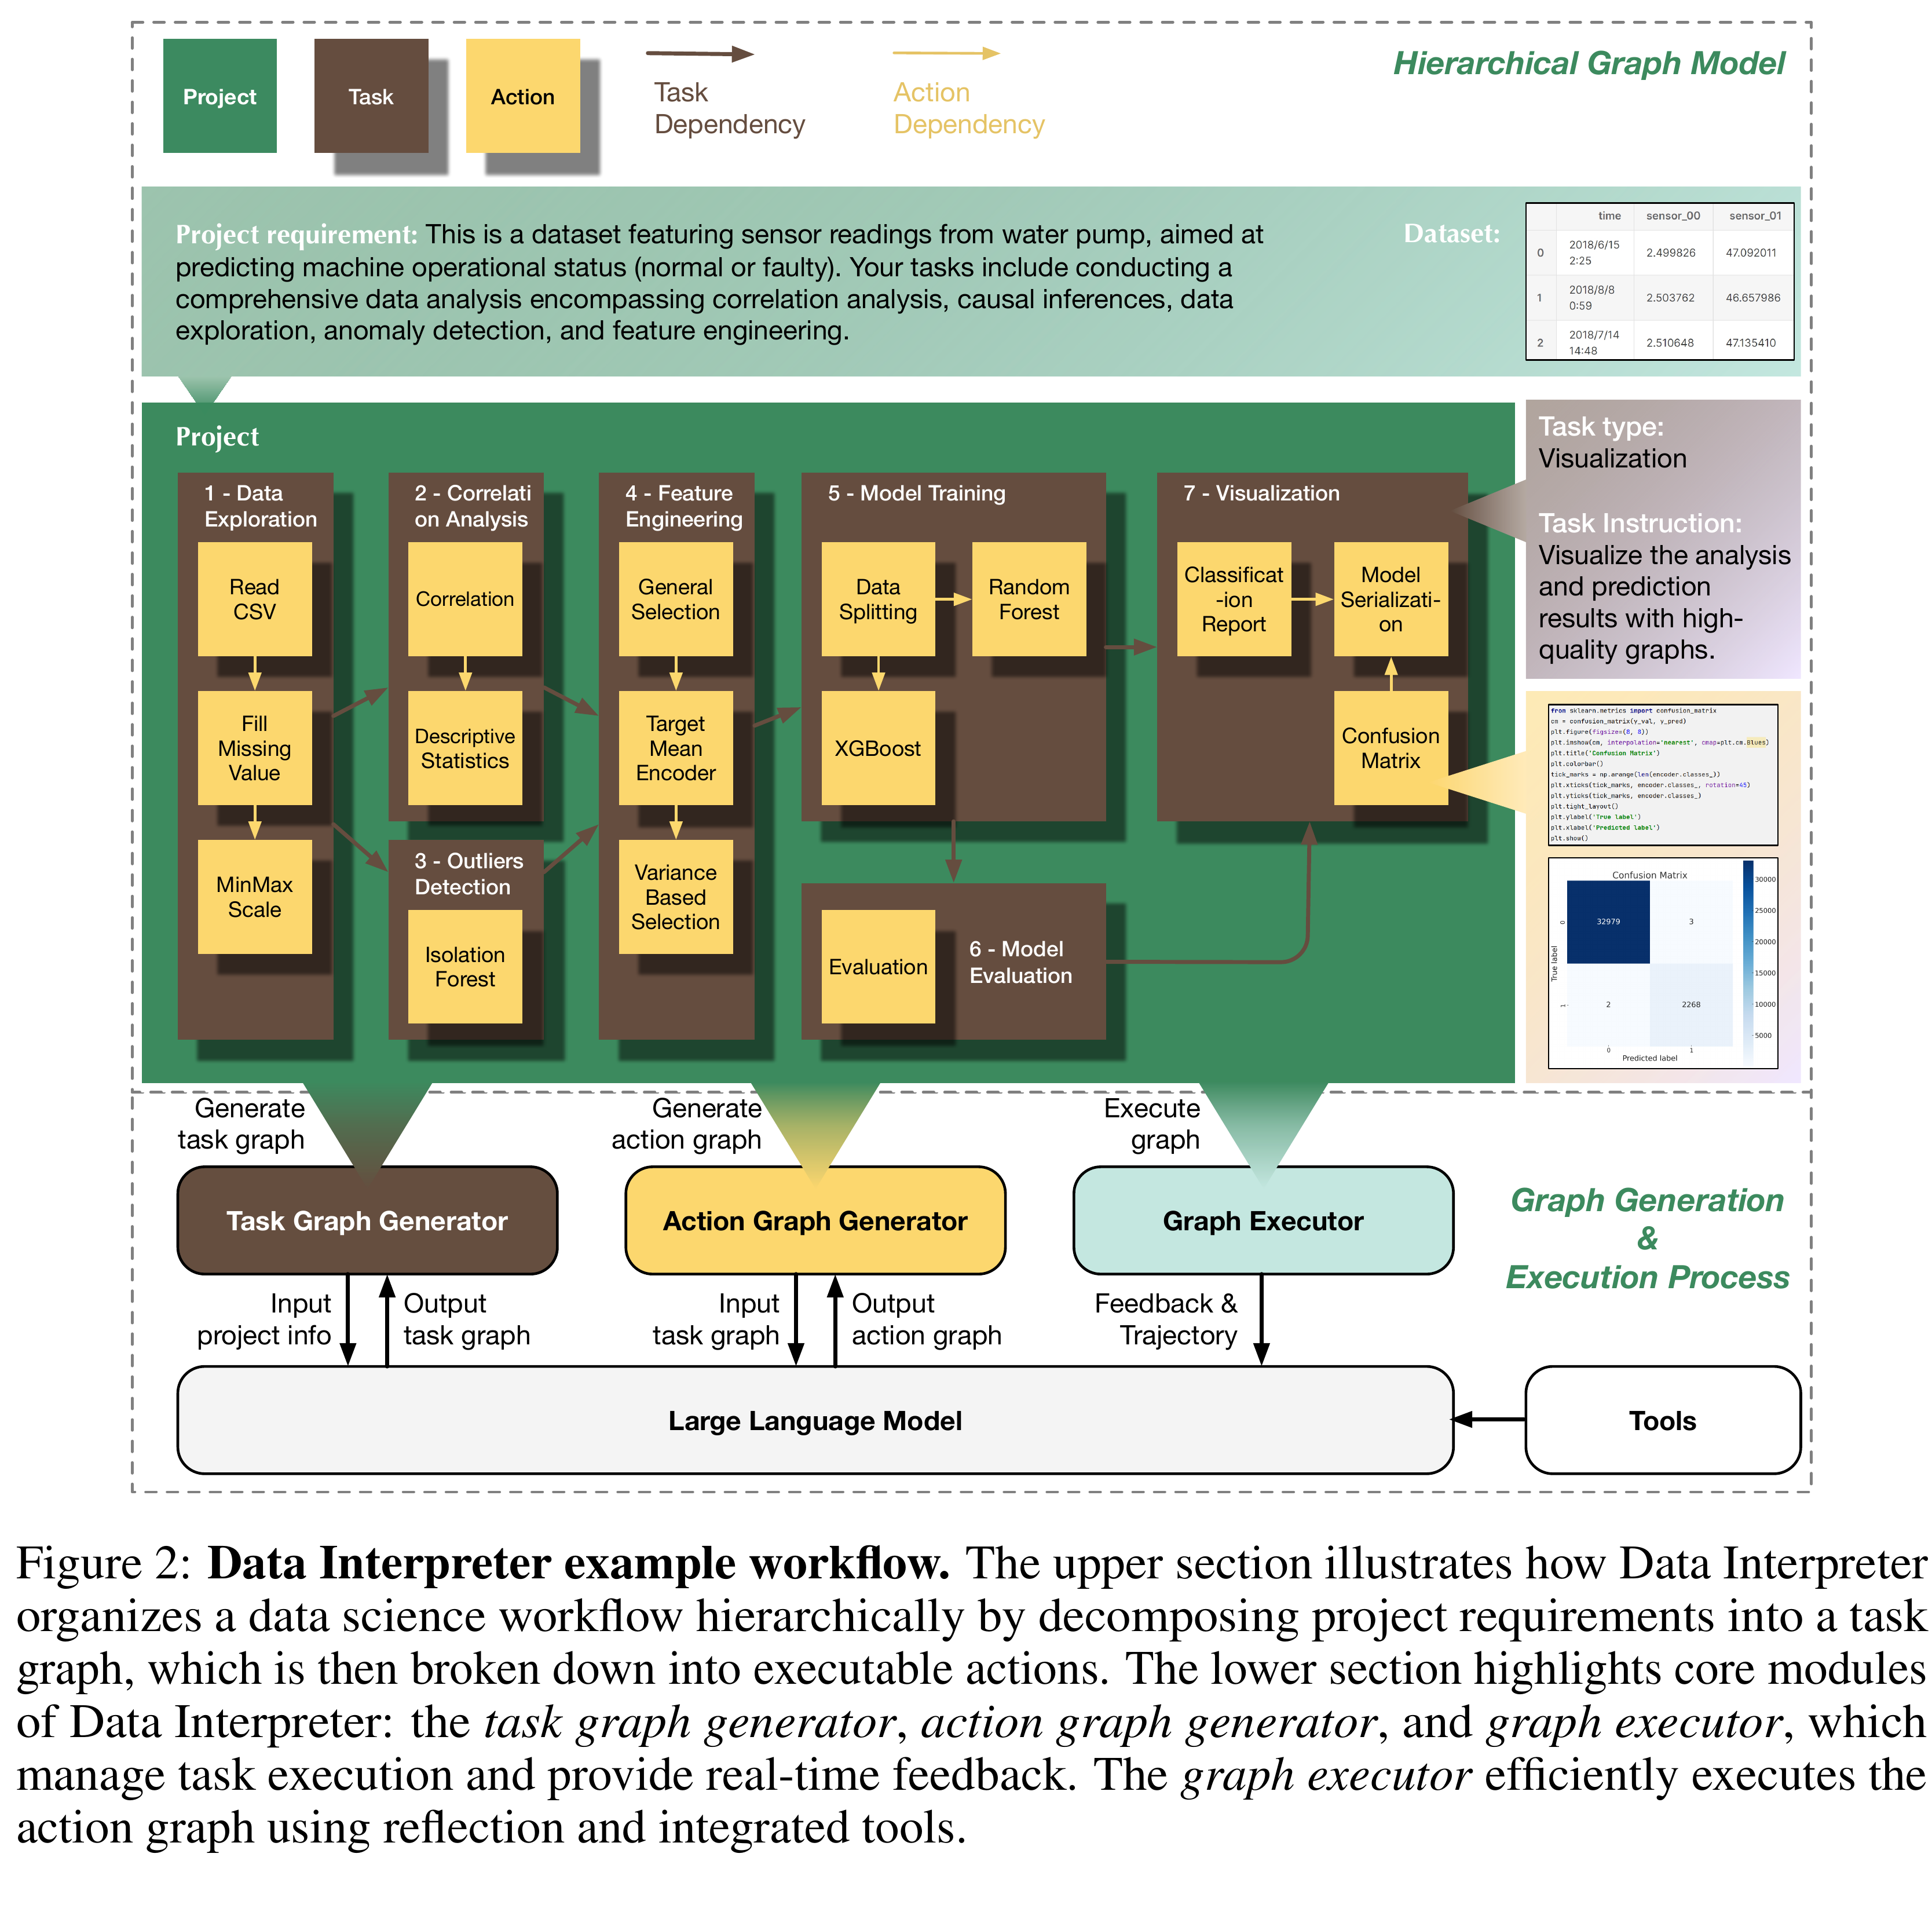
图 7:Data Interpreter Figure 2。项目要求先被拆成 task graph,再细化为 action graph,Graph Executor 根据工具与反馈执行。来源:Data Interpreter 论文。
这套结构提供了比单段 ReAct 更强的编排证据。论文还描述了失败后的 graph refinement:代码执行失败时先按预设次数调试;任务仍失败,则结合 episodic memory 和当前上下文重新生成 task graph,通过前缀匹配保留失败分叉前的成功节点,再替换后续任务。这里已经出现「改变计划」而非「重复动作」。
边界同样清楚。系统从用户给出的 project requirement 开始,运行在可用工具和执行器已经准备好的环境里。失败主要通过运行时错误和局部任务状态暴露;如果代码顺利执行、统计假设却不成立,graph executor 未必能察觉。Data Interpreter 因而证明了层级规划、状态保持和失败重规划,不等于证明了跨组织权限、业务约束和最终责任已经交给 agent。
5.2 AgenticData:把语义验证和成本优化放进计划回路
AgenticData 面向结构化与非结构化数据查询。架构把系统拆成 data profiling、query planning、memory、validator、semantic optimizer 和 semantic executor。计划层生成树结构的 semantic plan;validator 检查 grammar、semantic error 和 data missing;memory 保存错误、转移和跨任务反馈;optimizer 再估算成本、改写查询并选择计划。底层通过定制 MCP server 接数据库、文件和 Web server。
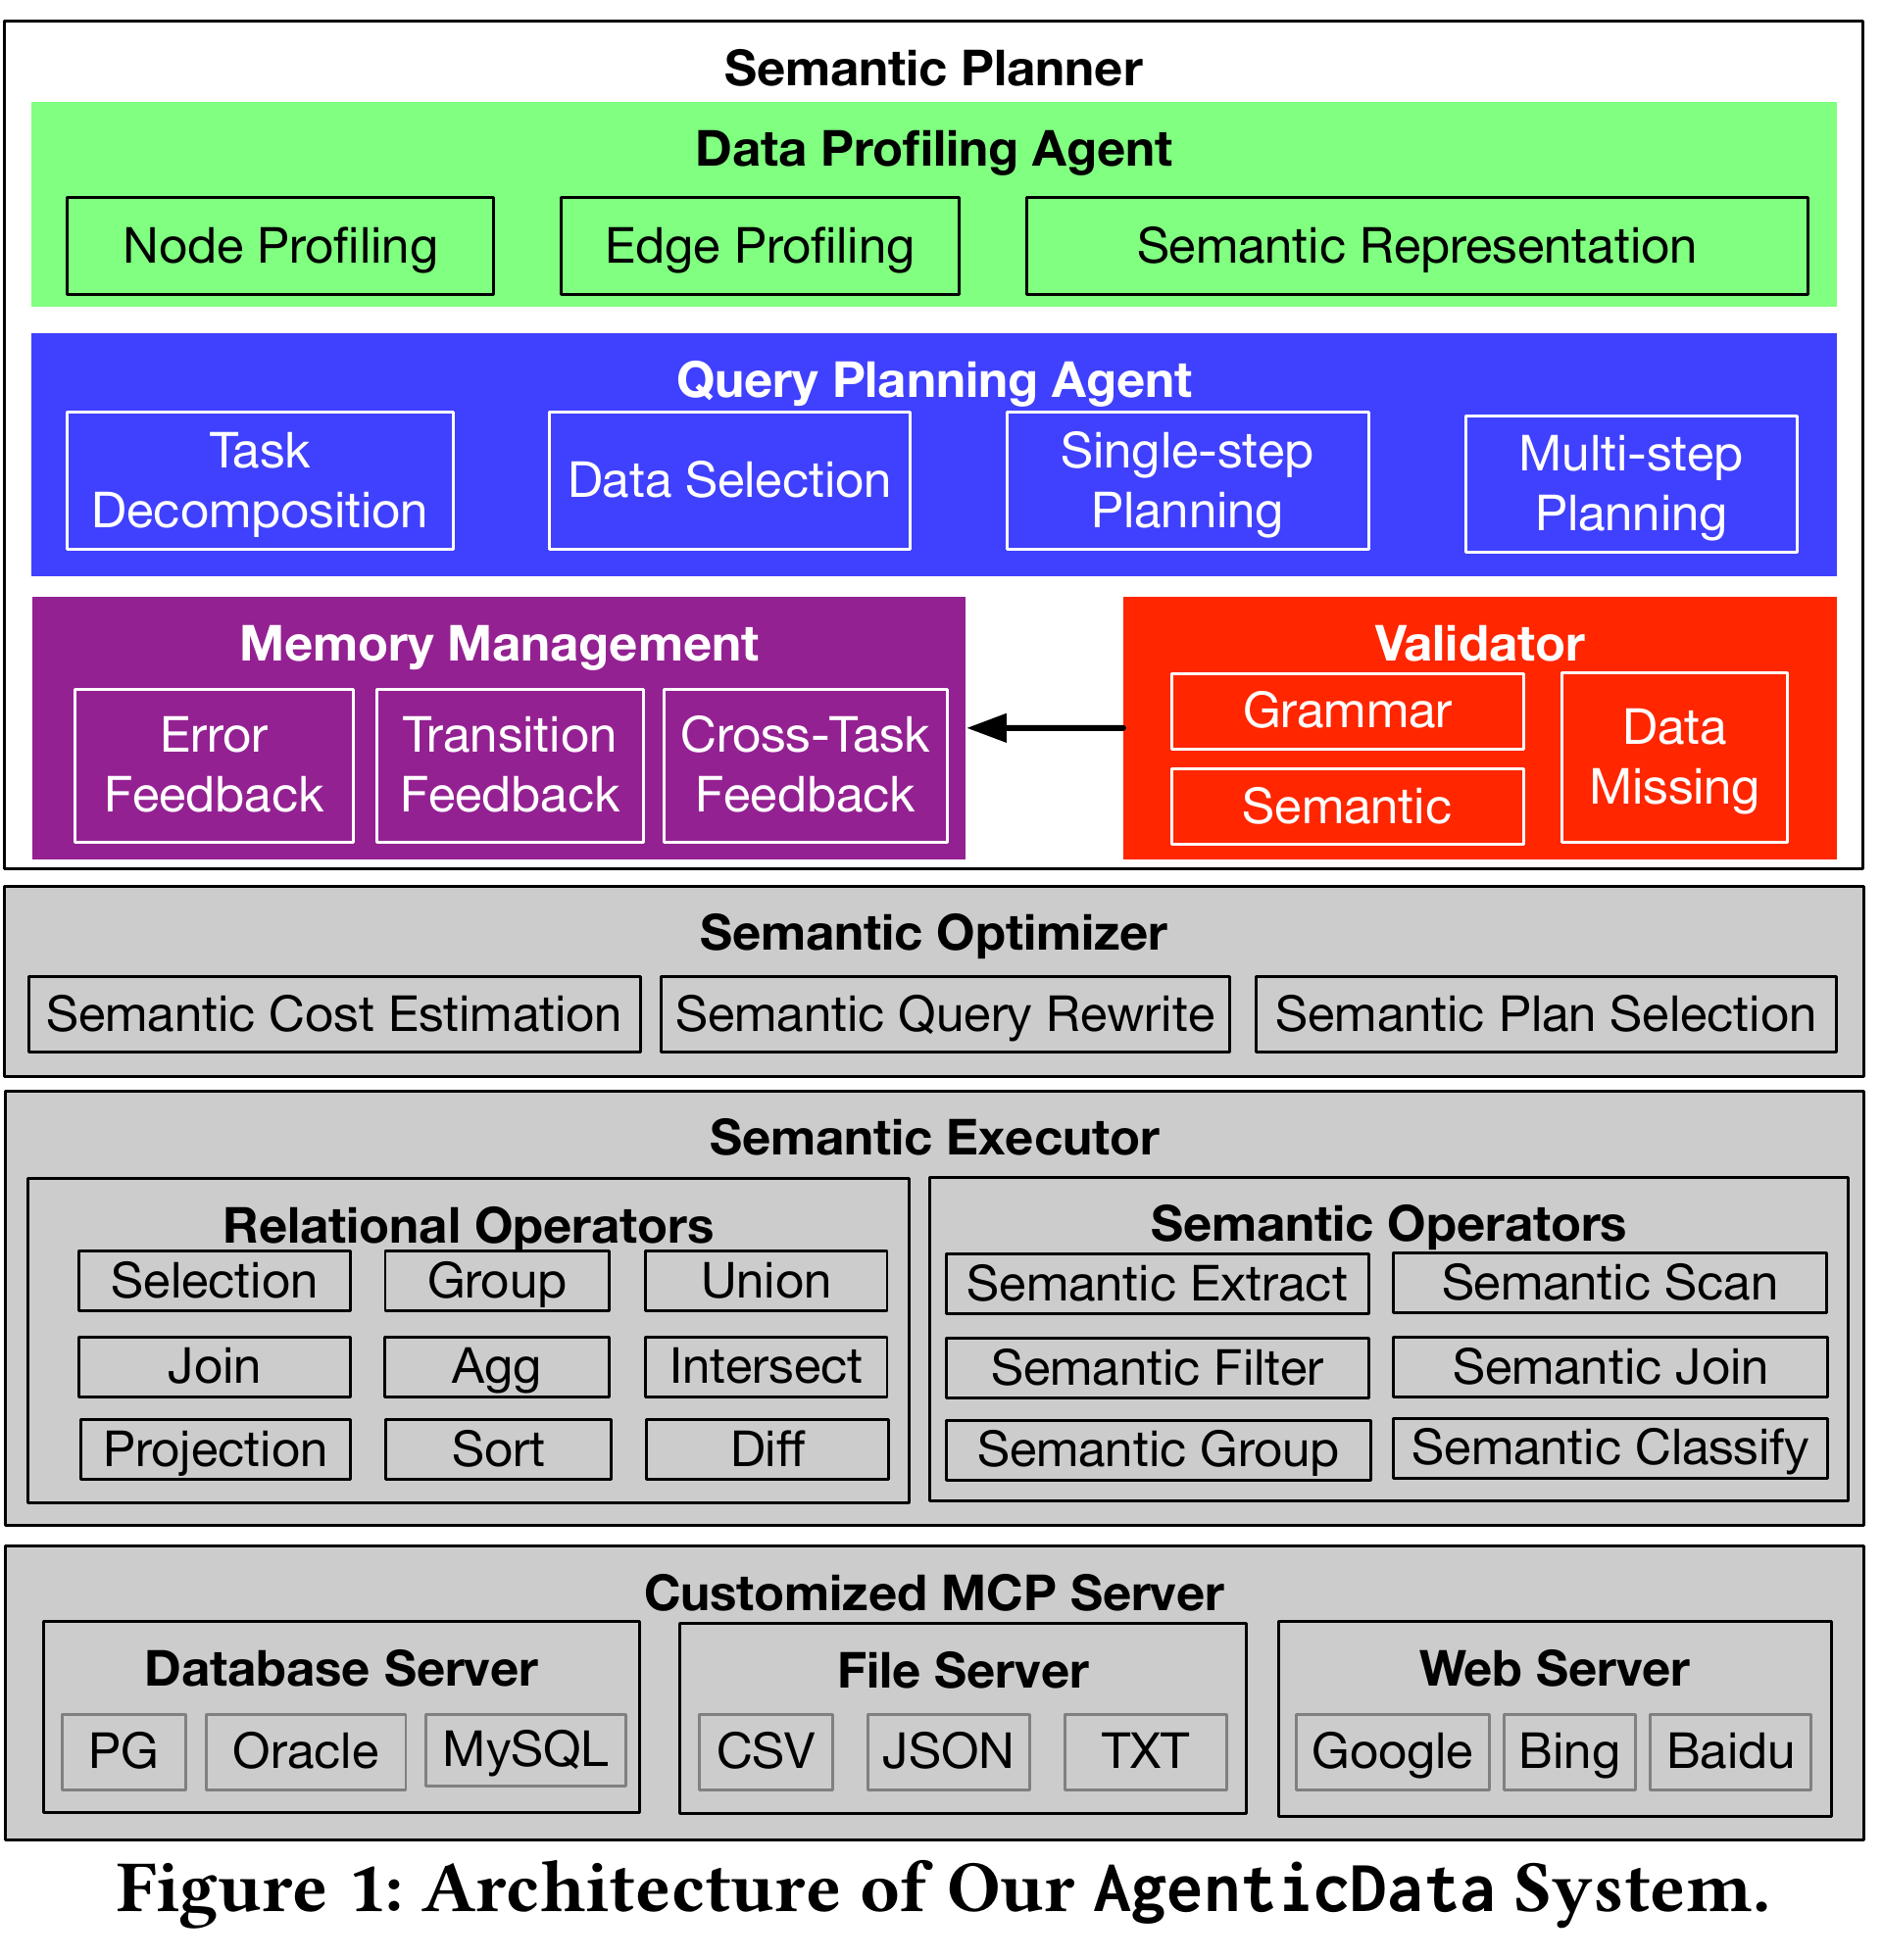
图 8:AgenticData Figure 1。语义 planner 之下分离 optimizer、executor 与 MCP server,validator 将错误反馈写入 memory。来源:AgenticData 论文。
这项工作的增量不只是「多 agent」。它给计划增加了 data profile 和 semantic validator,让系统有机会在执行前发现字段缺失或逻辑错误;它也把成本优化与任务规划放在同一条反馈链里。相较只看 Python 是否报错,这更接近数据系统需要的验证。
论文 Figure 8 报告了 DABStep-easy、DABStep-hard、DABench、Spider-2.0-Lite、Real-Bank 和 Wikipedia 六个面板。严格说这是五个 benchmark 家族,DABStep 被拆成 easy/hard 两个设置。图中 AgenticData 在作者选用的基线与模型配置下取得较高 accuracy,但同一系统在不同 backbone 上也有明显差异。
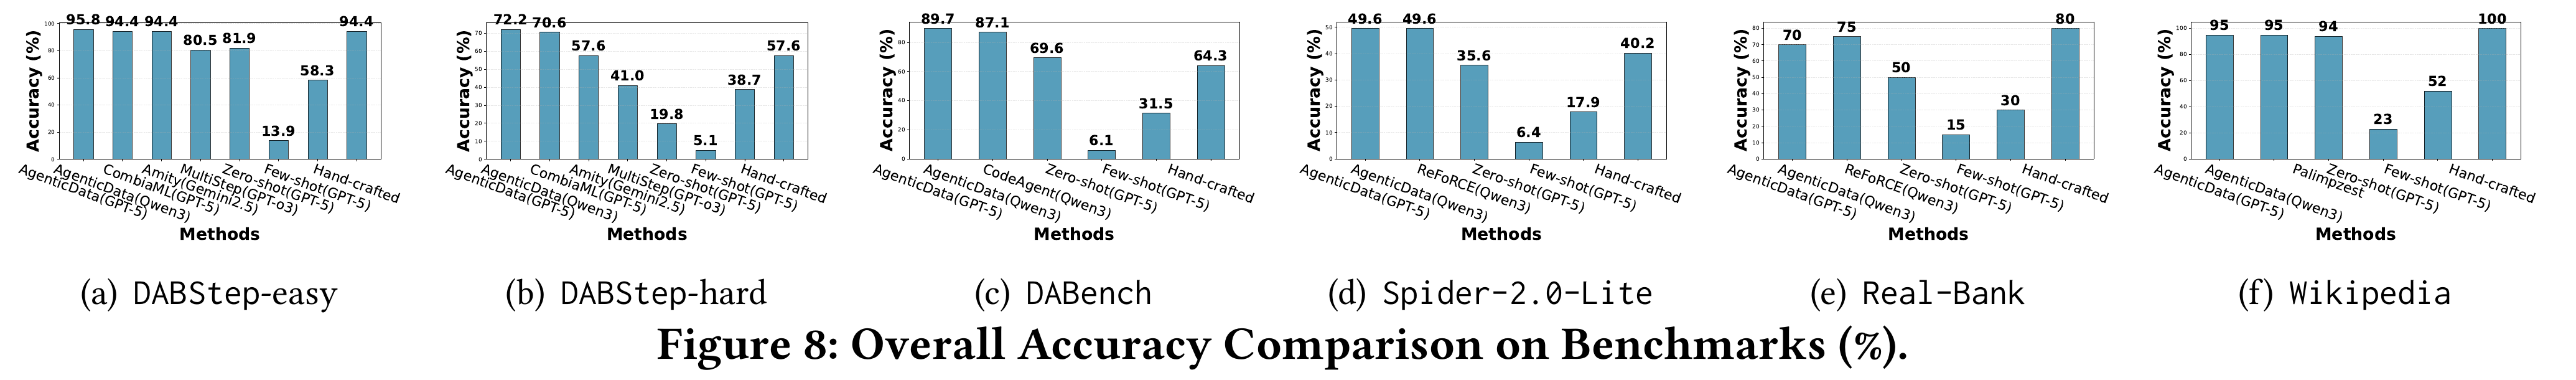
图 9:AgenticData Figure 8,展示六个设置下的总体准确率。该图是原论文报告,不构成对自治等级的直接验证,也不宜与其他论文的数字横向拼接。来源:AgenticData 论文。
准确率能支持「该架构在这些任务上有效」,不能单独支持「该系统更接近 L3」。自治还需要测计划由谁提供、人工介入多少、遇到未见 schema 或权限拒绝时能否安全改道、失败后是否知道停止。Table 2 也把 AgenticData 的 undefined operators 标成受限状态:系统拥有一组丰富的关系与语义算子,也允许用代码补充非预定义操作,但工具空间仍由设计者塑形。
5.3 DeepAnalyze:把编排行为写进训练
DeepAnalyze 的差异在训练侧。它定义 Analyze、Understand、Code、Execute、Answer 五类动作 token,让模型在推理时自行切换思考、读取结构化数据、生成代码、执行和回答。训练先强化推理、结构化数据理解、代码生成等单项能力,再用多能力 agentic training 学习数据准备、分析、建模、可视化、洞察和报告的组合流程。
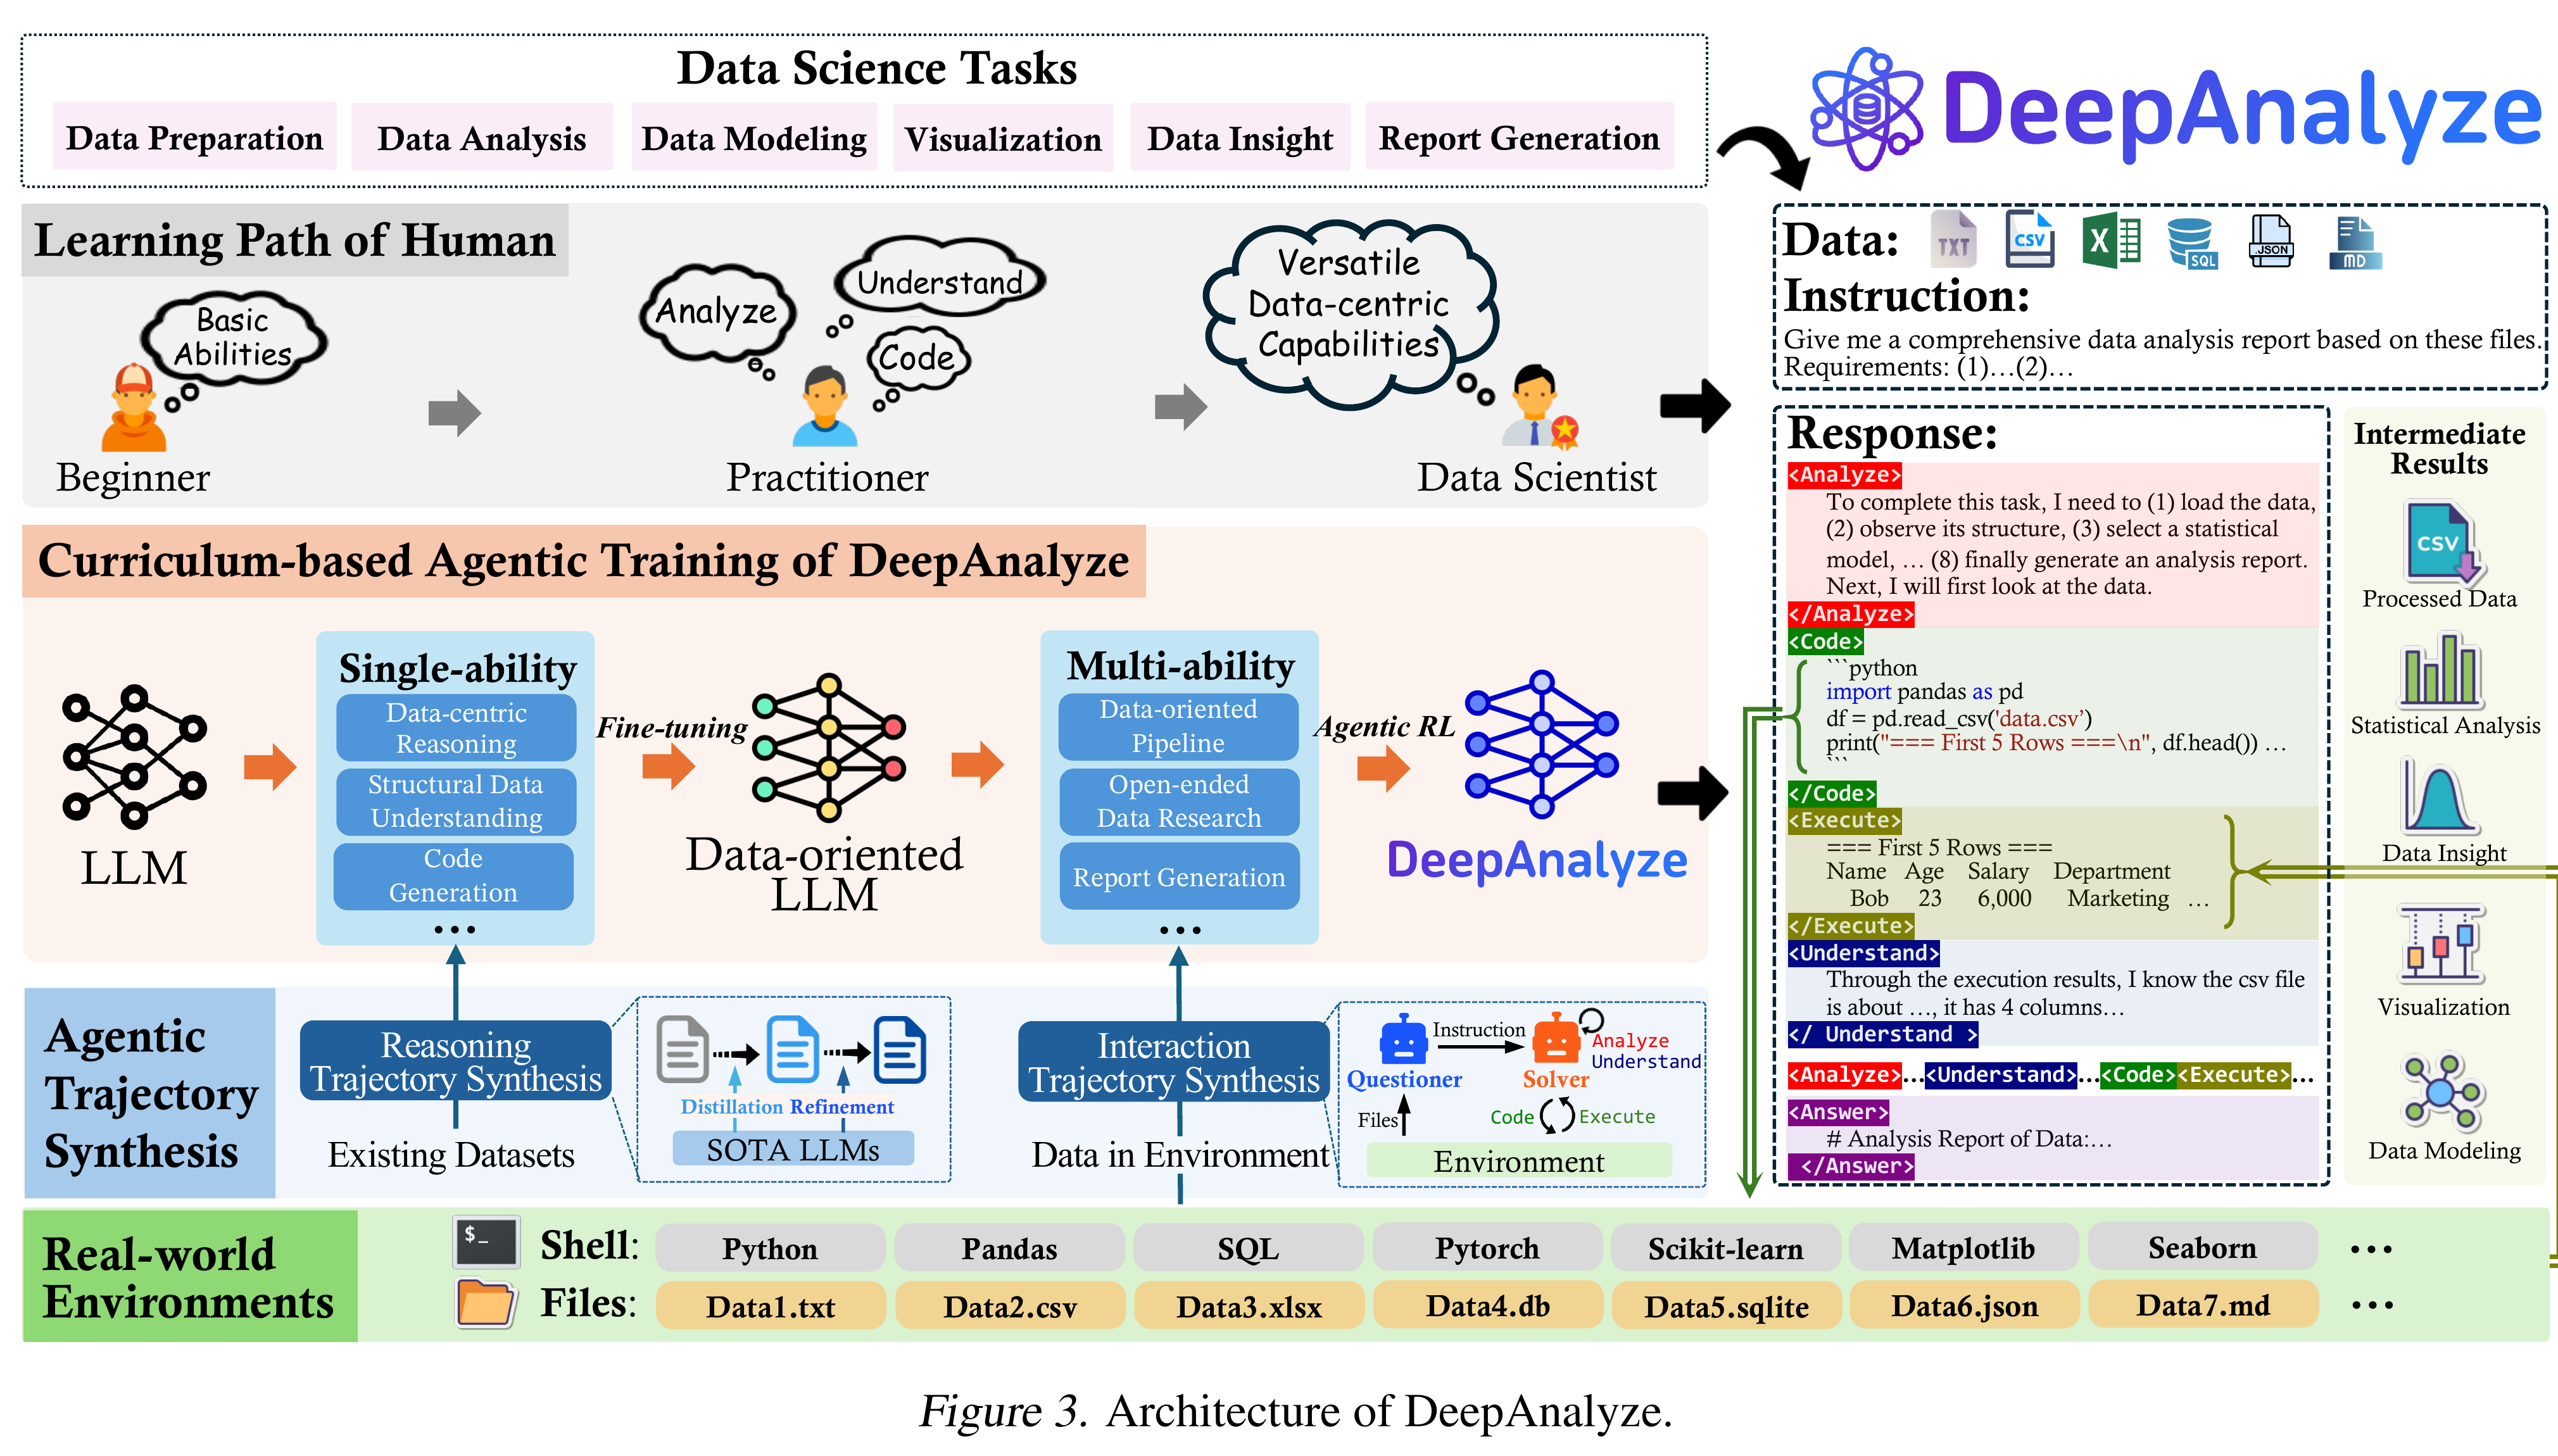
图 10:DeepAnalyze Figure 3。左侧把人类学习路径映射为单能力微调与多能力 agentic training,下方从真实文件环境合成轨迹,右侧展示模型在一个响应中交替生成动作并接收执行结果。来源:DeepAnalyze 论文。
论文强调 inference 不依赖人工定义的 workflow 或规则,动作由模型生成。这比外部固定 DAG 更接近「策略内化」:模型不只在 planner prompt 中列步骤,还在训练中学习什么时候读取数据、什么时候执行代码、什么时候继续分析。数据 grounded trajectory synthesis 用现有数据集和环境构造 reasoning/interaction 轨迹;多能力阶段使用 agentic RL,开放式研究任务的奖励还包含 LLM-as-a-judge。
这里仍要区分动作自主与任务自主。动作语法、训练任务、环境接口和奖励由研究者预先定义;用户仍提交明确任务和文件。模型能自主编排一次数据科学工作,不代表它会主动发现组织中的数据问题,更不代表它能发明一套新统计方法。开放式报告采用 LLM judge 也带来证据上限:写作完整性与方法正确性并不总能由同一 judge 稳定识别。DeepAnalyze 支持 Proto-L3 的主要证据是跨步骤编排和训练内化,不是 L4 的主动任务发现。
5.4 三个系统放在一起
三项工作分别把 Proto-L3 的不同部分做实:
| 系统 | 最强证据 | 仍未充分覆盖 |
|---|---|---|
| Data Interpreter | 分层 task/action graph;失败后重构任务图 | 语义失败、权限治理、跨生命周期责任 |
| AgenticData | 数据画像、语义验证、记忆、计划优化组成反馈回路 | 未定义工具的普适性、动态环境和责任转移 |
| DeepAnalyze | 通过课程训练与 agentic RL 内化多动作编排 | 主动任务发现、开放式结果的可靠验证、生产治理 |
它们说明 L3 不会由一个单独模块带来。planner 没有 verifier,会把错误流程执行到底;verifier 没有可修改的计划,只能反复拒绝;memory 没有来源和版本,会把旧环境经验带进新任务;训练内化了行为,却可能降低规则更新和审计的可见性。Proto-L3 的「proto」不是客气修辞,而是对这些缺口的准确保留。
6. 真实系统还要处理身份、网络与服务边界
论文中的学术系统主要讨论任务能力。部署环境还多出网络、身份、区域、密钥、数据驻留和服务责任。Google Cloud 的跨云开放湖仓参考架构把这些约束画得很直观:AWS S3 中的 Parquet、Databricks Unity Catalog 元数据、Google Cloud 区域内的湖仓表与 operational database 通过受控网络和 catalog federation 连接;Secret Manager、服务身份和验证凭据位于数据路径旁边,而不是藏在 agent prompt 里。
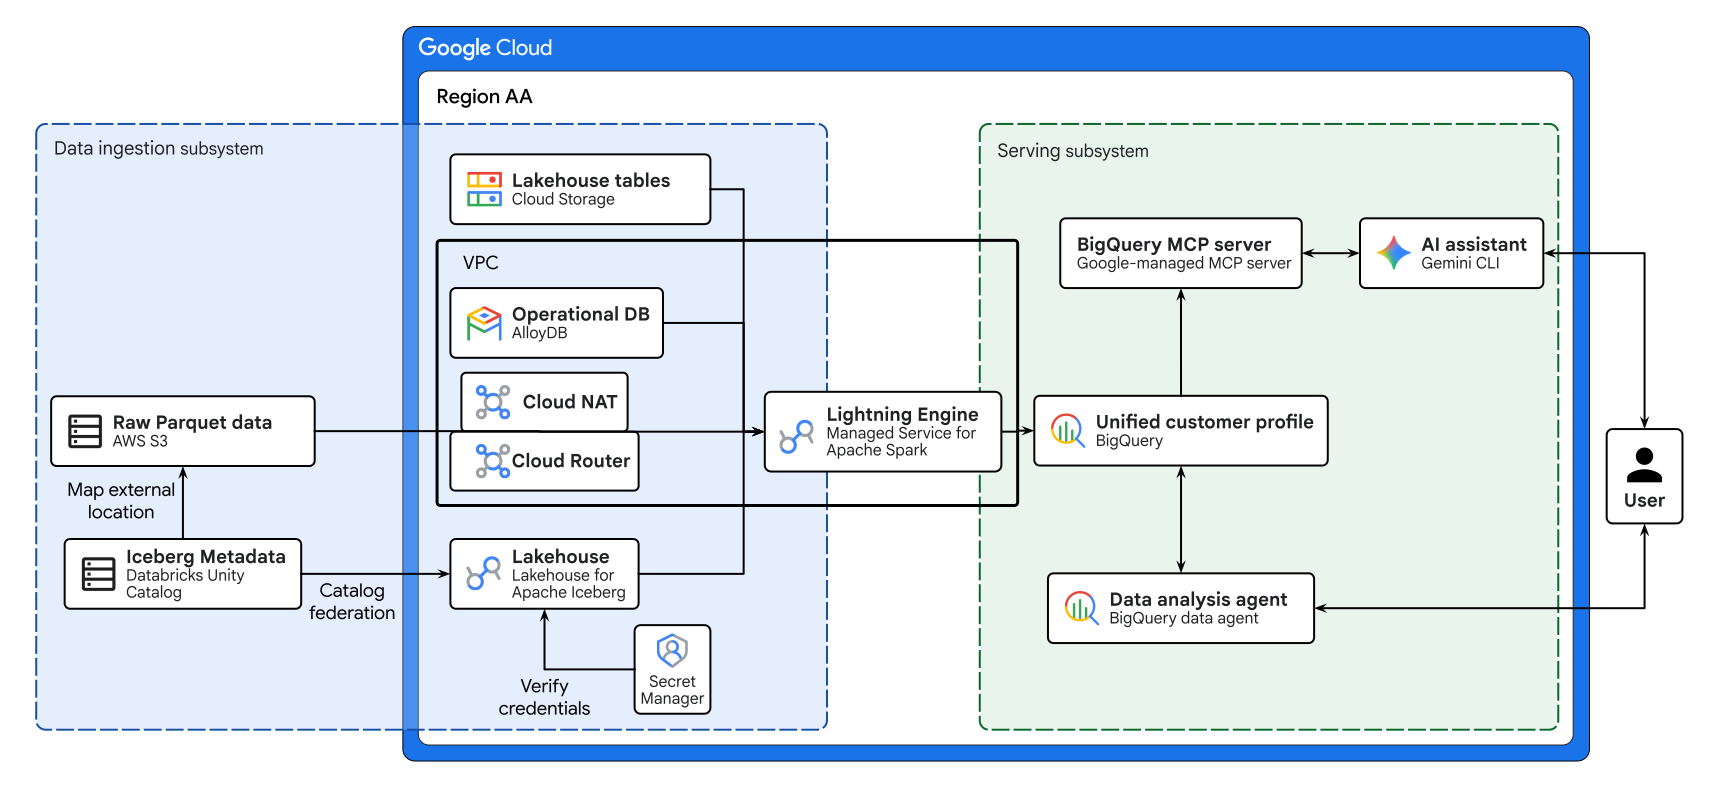
图 11:Google Cloud 官方跨云开放数据湖仓架构。图中把数据接入、VPC、凭据验证、湖仓服务与数据智能体服务放在明确边界内。来源:Google Cloud Architecture Center。
这张图不能证明某个云产品达到 L3,它说明的是另一件事:越接近生产环境,智能体越不可能成为绕过平台治理的超级用户。它应当通过受限接口读数据,用短期凭据调用工具,在 VPC、IAM 和审计策略允许的范围内行动。数据系统的高自治不是「权限越大越好」,而是能在明确定义的 operating envelope 内自行完成更多决策,越界时稳定停下并说明原因。
7. Taxonomy 更适合作为能力与责任标签
我的判断是,L0–L5 不宜被压成单一成熟度分数。它把至少四次性质不同的跃迁排列在同一轴上:L1→L2 增加环境感知,L2→L3 转移流程编排,L3→L4 增加主动任务发现,L4→L5 要求生成新方法。每一次变化都扩大能力,也扩大出错半径。
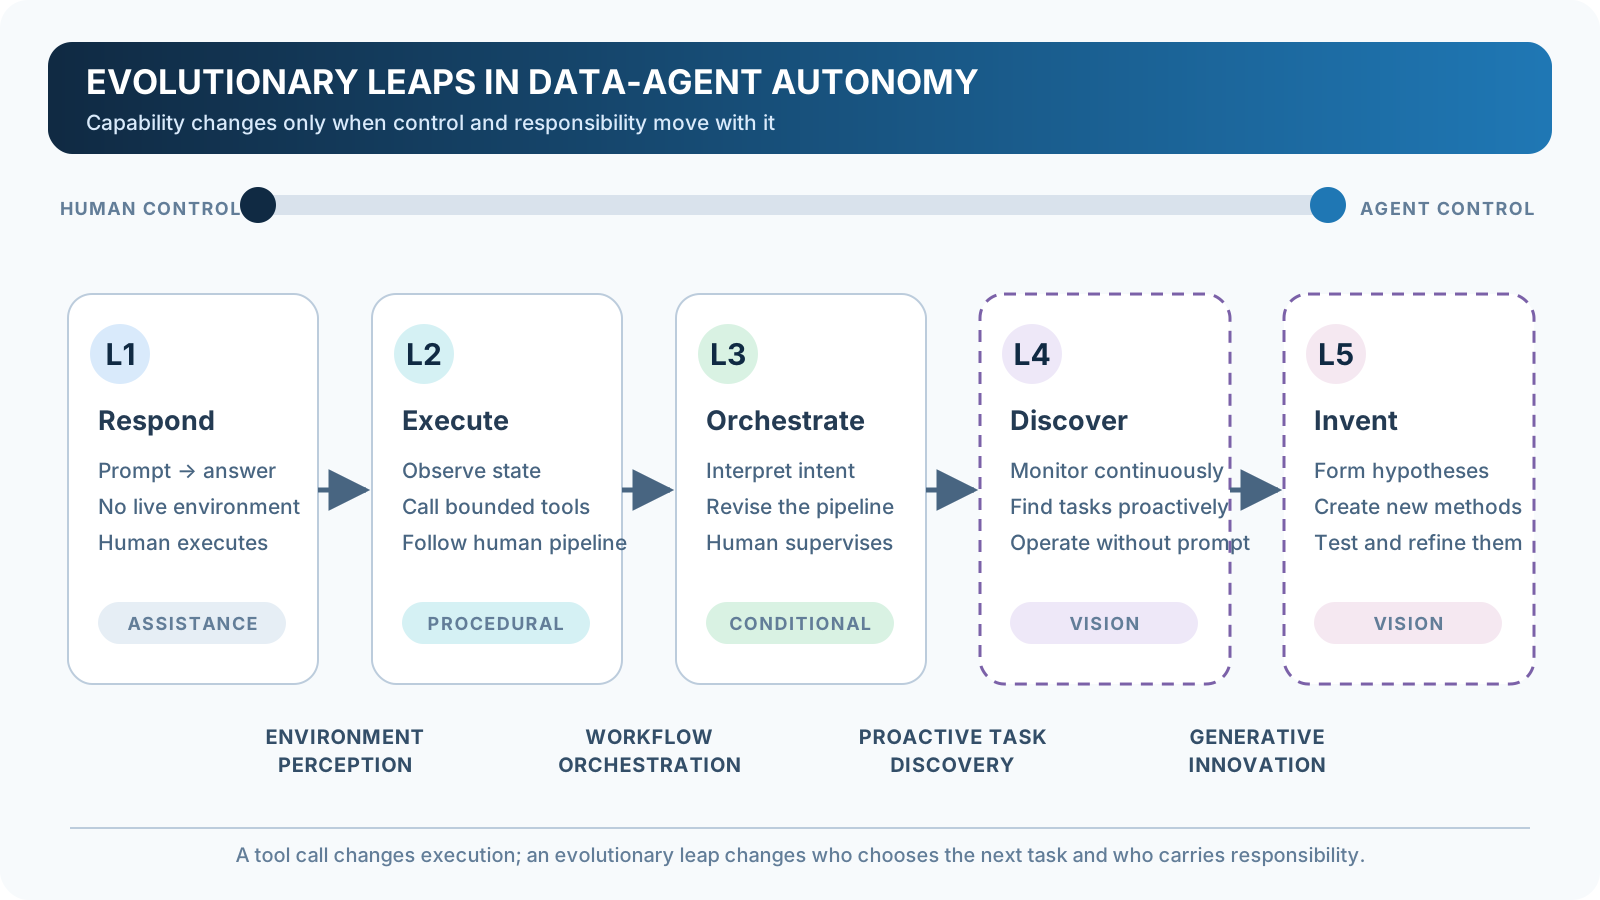
图 12:本文整理。工具调用改变执行方式;只有当下一步决策权与相应责任一起移动时,才构成自治等级的跃迁。L4、L5 以虚线标记为愿景。
线性分数会掩盖两个事实。第一,某个系统可能在分析阶段具有 Proto-L3 编排,在数据库配置阶段却只能停留在 L1,因为后者风险更高。第二,能力更强不自动意味着部署更好。对 payroll、医疗或财务数据,一条审批明确的 L2 流程可能比无法审计的 L3 更合理。自治等级应该由任务和风险共同选择,而不是产品版本必须逐级升级。
将生命周期与等级交叉后,边界会更清晰。L1 的数据准备助手提出清洗规则;L2 执行已知算子并根据质量检查调整;Proto-L3 才负责发现数据、选择算子、组成 pipeline,并在失败时改写流程。同一个「自动清洗」标签可以落在三种完全不同的控制结构上。
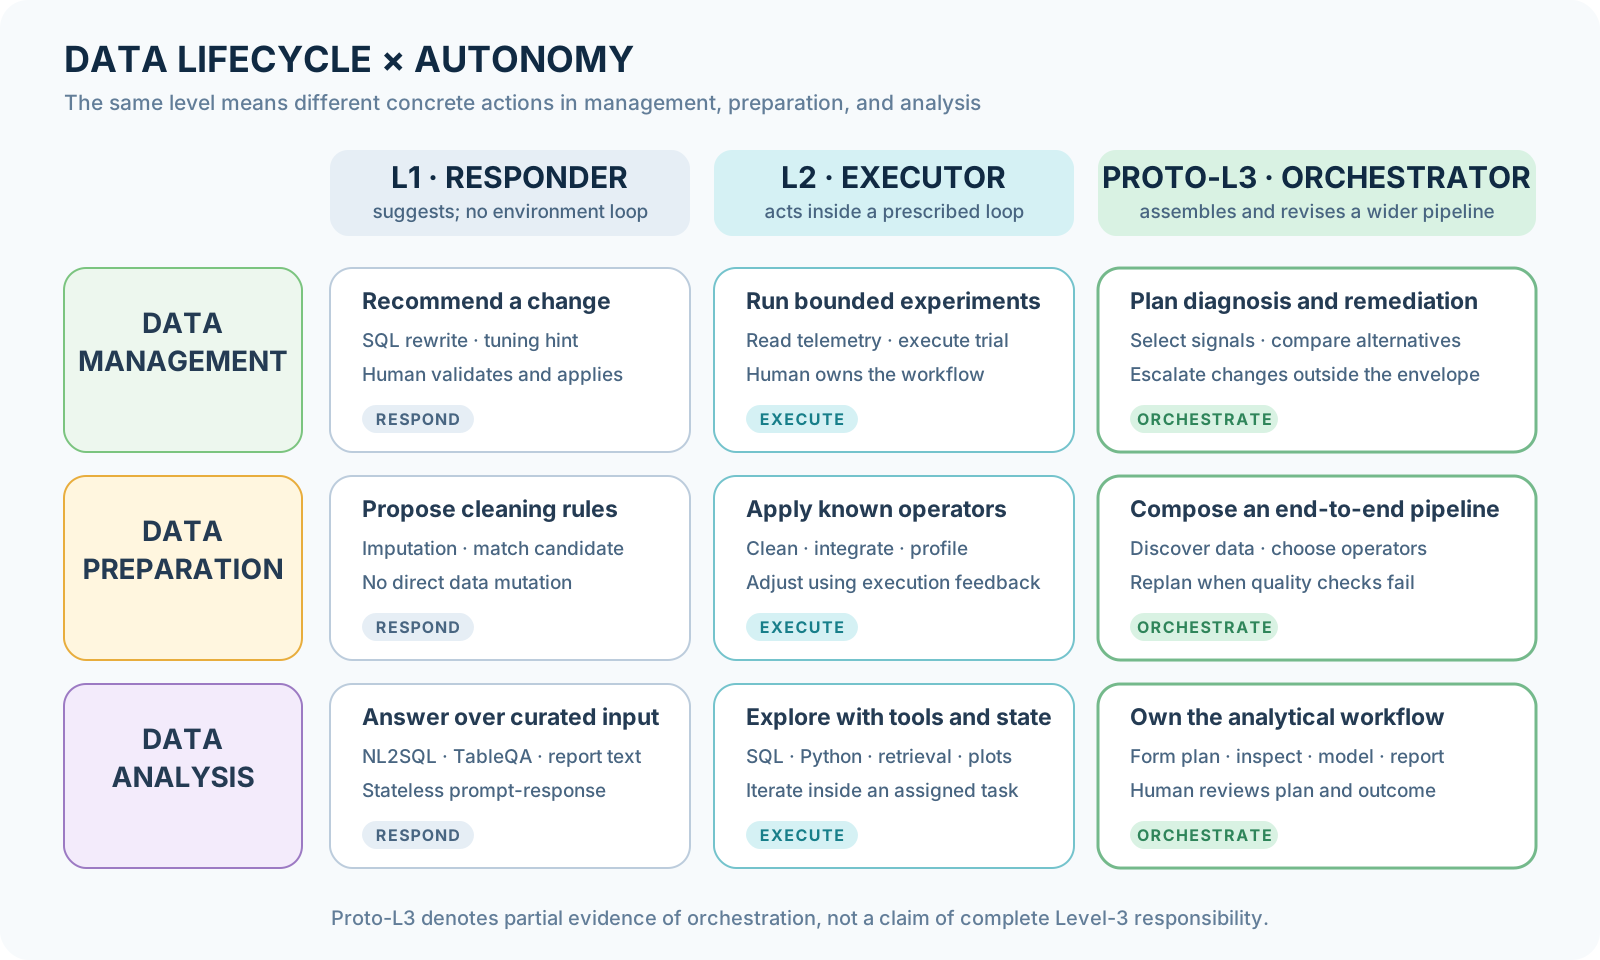
图 13:本文整理。矩阵用 management、preparation、analysis 三个阶段比较 L1、L2 与 Proto-L3;最后一列只表示部分编排证据,不宣称完整 L3 责任。
因此,描述系统时最好同时报告 level、scope 和 operating envelope。例如「在单一只读仓库的探索性分析中表现为 Proto-L3;写操作需人工批准;跨区域数据不可访问」。这比只写「L3 Data Agent」多几个限定词,却能直接告诉用户系统可以做什么、哪里必须停。
8. 治理不是附加模块,而是控制回路
Data Agent 的错误具有级联性,治理也必须进入执行过程。来源追踪应在数据发现时建立;策略校验要在读取敏感字段或调用写接口前发生;高影响动作需要人工批准;审计日志要记录计划、参数、数据快照和工具返回;出现错误时还要能回滚到已知状态。把这些记录留到最终报告生成之后,已经太晚。
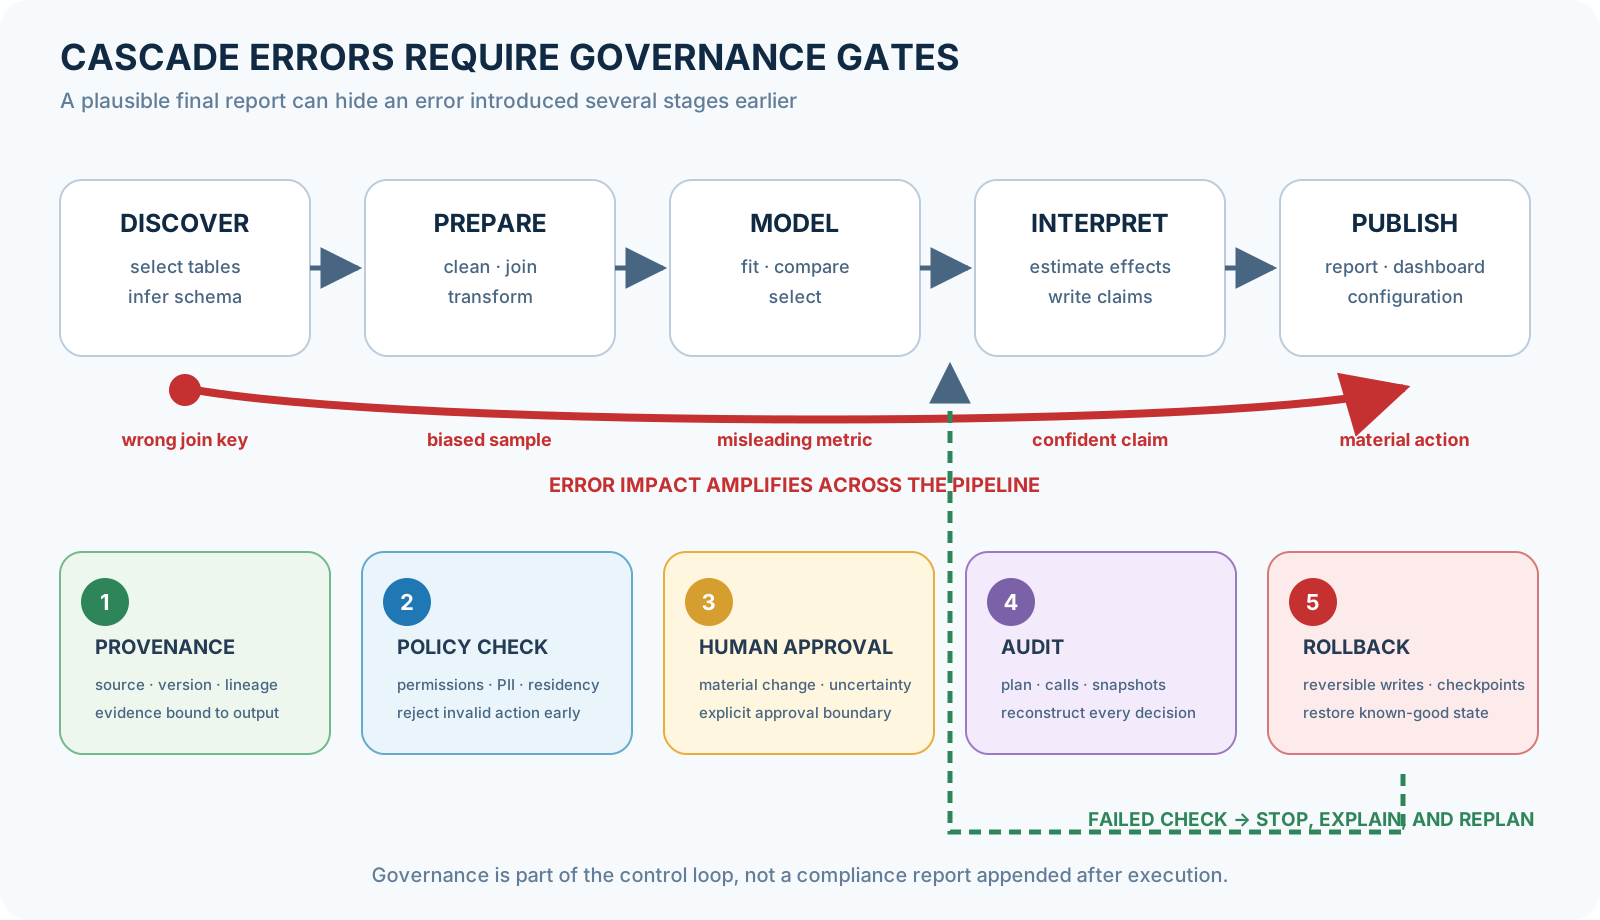
图 14:本文整理。一个错误 join key 可以沿准备、建模、解释和发布放大;provenance、policy check、human approval、audit 与 rollback 应在流程中形成可阻断、可重规划的 gate。
责任转移需要可操作的定义。若系统可以自行写回数据库,至少要说明:哪些表和列可写,单次修改规模上限是多少,哪些检查失败会触发停止,谁能批准越界动作,如何重建本次决定,以及怎样撤销。没有这些字段,「人在回路中」只是模糊承诺。人可能被要求在几十秒内批准一份无法读完的计划,也可能在错误已经传播后才收到通知。
更可靠的 supervisor interface 应提供差异而不是摘要:本次计划相对基线改了什么,读取了哪些数据版本,哪些假设未通过验证,预计成本和影响范围是多少。只有这样,人类监督才是控制机制,而不是替 agent 在最后一页签字。
9. 高自治评测需要六维证据
现有 benchmark 多数以最终 accuracy、completion rate 或报告质量为中心。这些指标对 L1/L2 已经有用,但随着智能体获得流程控制权,评测边界必须扩张。本文建议至少分开报告六个维度:
\[ \mathbf{E} = (Q, A, R, D, G, C), \]
其中 \(Q\) 表示正确性和数据质量,\(A\) 表示实际自治度,\(R\) 表示对工具错误、缺失数据和 schema drift 的鲁棒性,\(D\) 表示依据反馈重规划和迁移的适应性,\(G\) 表示权限、来源、审计、审批与回滚,\(C\) 则覆盖 token、延迟、数据扫描、工具调用和人工复核成本。
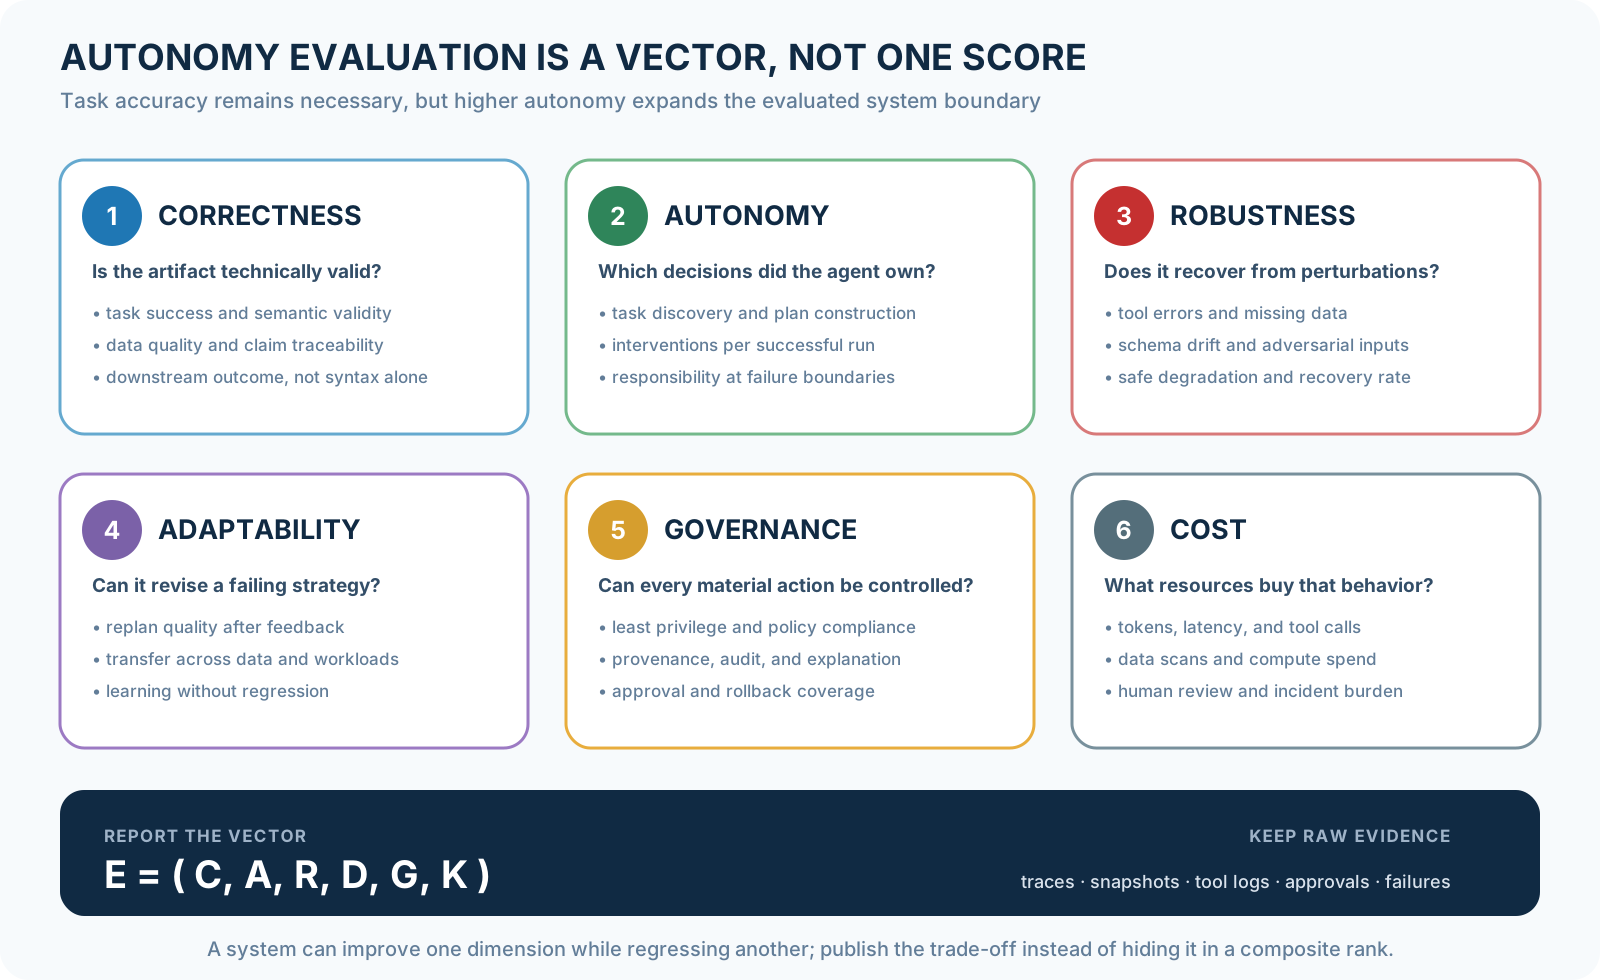
图 15:本文整理。正确性、自治、鲁棒性、适应性、治理与成本应分别保留原始证据;一个综合分数无法说明系统在哪个维度退化。
自治度不能只统计 agent 生成了多少步骤。更可复核的指标包括:高层计划中由 agent 首次提出的决策比例、每个成功任务所需人工干预次数、失败后改变策略而非重复动作的比例、越权请求被正确拒绝的比例。它们仍可能被游戏化,因此必须与轨迹和任务结果一起发布。例如减少人工干预很容易通过少问问题实现,却可能让错误率和事故成本上升。
鲁棒性测试也不能只随机删几行数据。真实扰动包括字段改名、表关系变化、权限撤销、工具版本升级、数据延迟、分布漂移和中途服务不可用。评测应检查系统能否识别不可恢复状态、选择降级路径并保留此前有效产物。一个持续重试直到 token 用尽的 agent 不算鲁棒。
治理维度尤其不能用「有日志」代替。日志是否包含输入数据版本、执行计划、工具参数、验证结果、人工批准和写操作差异,决定了事故能否重建。成本也应包含人的时间。某个系统减少 token,却把每一步都变成人工复核,不能简单称为更高效。
10. 开放问题:缺口主要在控制与验证
论文列出的研究问题可以归到几条相互依赖的技术链上。
大规模数据感知。 Data Agent 不可能把整个 lakehouse 塞进上下文。它需要用 catalog、profile、sample、索引、lineage 和 learned representation 建立「可查询的感知」,决定先看哪些结构,再按需下钻。感知层若丢失关键表或误判字段语义,后续规划再强也无法补救。
未定义算子与工具演化。 当前系统擅长组合预先注册的 SQL、Python、检索和绘图工具。遇到没有现成算子的任务,它们需要生成新代码、验证副作用、决定是否保留为工具,并处理版本和依赖。真正困难的不是写出函数,而是证明它在当前数据、权限和成本约束下可以安全加入 pipeline。
因果与 meta reasoning。 运行成功不代表分析成立。智能体要区分相关性与因果性,识别数据泄漏、选择偏差和不恰当的指标,还要判断自己为何失败:是数据不足、工具错误、假设不成立,还是计划结构有问题。没有这种 diagnosis,所谓重规划只是换一种方式试错。
动态适应与长时域权衡。 L4 愿景要求系统长期监测 workload、质量、延迟和成本。一次局部优化可能让后续维护更贵,今天创建的 materialized view 可能在 workload 改变后成为负担。agent 需要处理累计成本、数据质量、性能和治理之间的多目标权衡,而不是为当前请求贪心优化。
训练数据与真实评测。 人工编写的成功轨迹和固定 sandbox 难以覆盖生产故障。配置历史、查询日志、质量告警和 incident report 可以提供训练信号,但它们包含敏感信息、选择偏差和组织特有规则。如何脱敏、归因、构造反事实并避免把历史坏习惯写入策略,是训练问题的一部分。
安全与责任。 越高级别越不能靠 prompt 中的一句「be safe」。权限、政策、审批、审计和回滚需要由外部系统强制执行,agent 只能在接口授予的范围内行动。评测也要覆盖「正确拒绝」和「在不确定时请求监督」,否则 benchmark 会奖励冒进。
这些问题解释了为什么 L4/L5 仍是愿景。主动发现任务需要长时监测和组织目标;生成新方法还要求可靠的实验设计、因果判断、比较与自我纠错。把一份自动生成的 EDA 报告叫作「AI data scientist」,只是把尚未解决的控制问题藏进名称。
11. 结论
这篇 tutorial 最有用的贡献是重新安排提问顺序。面对一个 Data Agent,不要先问它接了多少模型、多少工具,也不要先看 demo 是否能生成完整报告。应先问环境是否真实可见,流程由谁设计,失败时能否改变计划,哪些动作需要批准,错误能否被追踪和撤销。
按这组问题,当前系统的状态相当清楚。L1 已经广泛存在;L2 在 SQL、数据清洗、检索、代码执行与可视化中形成了稳定模式;Data Interpreter、AgenticData、DeepAnalyze 等工作让分层规划、语义验证、记忆和训练内化开始汇合,提供了 Proto-L3 证据。完整 L3 仍缺少跨生命周期、动态环境、治理和责任上的统一验证。L4/L5 则应继续作为研究假设接受检验。
我会把 L0–L5 当作能力与责任标签,而不是营销意义上的升级路线。一个受约束、可审计、会在边界处停下的 L2,通常比一个声称全自治却无法解释数据来源的「L4」更可信。数据智能体的下一步,不是让 pipeline 里出现更多自动箭头,而是让每一次控制权转移都有相应的验证、权限和责任证据。
参考资料
- Yuyu Luo, Guoliang Li, Ju Fan, Nan Tang. Data Agents: Levels, State of the Art, and Open Problems, 2026.
- Yuyu Luo et al. A Survey of Data Agents: Emerging Paradigm or Overstated Hype?, 2025.
- Sirui Hong et al. Data Interpreter: An LLM Agent For Data Science, Findings of ACL 2025.
- Ji Sun et al. AgenticData: An Agentic Data Analytics System for Heterogeneous Data, 2025.
- Shaolei Zhang et al. DeepAnalyze: Agentic Large Language Models for Autonomous Data Science, 2025.
- Google Cloud Architecture Center. Build a cross-cloud open data lakehouse with agentic AI.
- HKUSTDial. Awesome Data Agents.