OPD:后训练中的能力整合接口
大模型开发看起来是模型架构和训练算法的竞争,落到后训练现场,更多时候是在处理数据来源、阶段衔接和能力冲突。
尤其是多人协作的后训练流程。最朴素的办法,是每个人负责一个能力方向,各自准备 SFT 数据,最后合到一个训练集里统一训练。再往前一步,是各自训练 adapter 或专家模型,再尝试做权重平均、adapter 叠加或混合训练。
这些办法简单,也确实有效过一段时间。但它们很容易遇到一个典型问题:
单项能力在独立训练时表现不错,一旦进入合版流程,整体结果开始互相挤压。
最近读各家大模型技术报告时,我注意到一个变化:很多团队开始把同一个技术放到后训练的关键位置。
- Qwen3 用 OPD 训练轻量模型,把旗舰模型的推理能力压缩到小模型里。
- GLM-5 用 OPD 修复多阶段 RL 后的能力遗忘。
- 小米 MiMo-V2 用多教师 OPD 整合数学、代码、通用对话等专家能力。
- DeepSeek-V4 更激进,直接把传统 mixed RL 阶段替换成 OPD。
不同团队、不同场景,最后都指向同一个关键词:OPD,On-Policy Distillation。
这篇笔记主要梳理三件事:
- OPD 解决的后训练问题。
- Qwen3、GLM-5、MiMo-V2、DeepSeek-V4 的具体用法。
- OPD 作为能力整合接口的价值。
OPD 之所以重要,是因为它同时拿到了 on-policy 的分布匹配、蒸馏的密集监督,以及 logit 空间的能力整合优势。
换句话说,它绕开了很多参数空间里难处理的能力干扰问题。我的核心判断是:语言模型的能力,在 logit 空间里比在参数空间里更容易合并、迁移和保留。
大模型训练的三层结构
在聊 OPD 前,先把大模型训练的几层关系理一下。这里可以粗略分成三层。
最底层是 Pre-training。这是消耗大量 GPU、喂入万亿级 token 的阶段。它为模型提供语言能力、世界知识和基础推理模式,相当于把通用底座先建起来。
中间层是 Mid-training。这一层负责注入更明确的领域知识。代码、医疗、金融、企业知识库,都可以在这个阶段继续强化。
最上层是 Post-training,也是这篇笔记的重点。它负责把底座模型塑造成可用系统:指令遵循、数学推理、代码生成、对话风格、工具调用、agent 行为,基本都在这一层被校准。
小模型如果后训练做得好,在某个专长领域里完全可能打过更大的通用模型。这也是大家愿意投入后训练的原因:部署更便宜,迭代更快,隐私也更容易控制。
但前提是,后训练的方法得选对。
后训练的两条老路
后训练大体有两条路:on-policy training 和 off-policy training。
On-policy training 是让模型根据当前策略生成轨迹,再根据结果给奖励。比如在数学任务里,模型完整生成推理过程和答案,系统根据最终答案或过程评分返回 reward。
它的优点是训练分布来自模型自己,训练状态和真实推理状态更接近。问题也很明显:反馈太稀疏。
模型生成了 1000 个 token 的解题过程,最后只收到一个“错了”。错误可能来自早期建模、某一步代数变换,也可能只是最后的算术失误,但最终 reward 很难直接指出责任位置。纯 RL 的样本效率低,很大一部分原因就在这里。
Off-policy training 则是使用外部现成答案,让模型模仿高质量样本。最典型的是 SFT:参考数据已经写好,模型只需要拟合这些轨迹。
它的优点是信号密集,训练稳定。问题是模型学到的是参考轨迹上的上下文,不是自己生成时会遇到的上下文。一旦模型早期产生偏差,后续状态就会逐步偏离训练分布,这就是 exposure bias。长序列任务里,这个问题尤其明显。
可以换成一个代码审查的例子:
- 纯 RL 像只看 CI 最终状态。测试挂了,但很难知道是哪一行引入了问题。
- Off-policy 蒸馏像直接阅读一份已经通过审查的标准 PR。样例很漂亮,但未必覆盖自己真实开发时会走到的中间状态。
- OPD 更接近在当前 PR 上做逐行 review。轨迹来自当前模型,反馈也落在当前轨迹上。
这就是 OPD 的核心:让模型从自己的分布采样,再让参考模型对这条轨迹上的每一步给出密集反馈。
OPD 的关键:on-policy + dense signal
OPD 把两条老路的优点拼到了一起。
它沿用 RL 的 on-policy 采样,让模型从当前分布生成轨迹,从而缓解分布错位。它又保留蒸馏的密集监督,由参考模型对每个 token 给出概率反馈。
可以把三种方法放在一起看:
| 方法 | 采样分布 | 反馈密度 | 主要问题 |
|---|---|---|---|
| SFT / Off-policy 蒸馏 | 参考数据分布 | 密集 | 推理时可能偏离训练分布 |
| RL | 当前模型分布 | 稀疏 | 样本效率低,reward 容易被利用 |
| OPD | 当前模型分布 | 密集 | 依赖参考模型质量,额外需要教师 forward |
训练时,当前模型先生成自己的轨迹。然后参考模型在这条轨迹上计算每个 token 的概率分布。当前模型通过最小化与参考模型之间的 reverse KL 来更新:
\[ D_{\mathrm{KL}}\left(\pi_{\theta} \parallel \pi_{\mathrm{teacher}}\right) = \sum_i \pi_{\theta}(x_i) \log \frac{\pi_{\theta}(x_i)}{\pi_{\mathrm{teacher}}(x_i)} \]
这里的 \(\pi_{\theta}\) 是当前模型策略,\(\pi_{\mathrm{teacher}}\) 是参考模型策略,\(x_i\) 表示候选 token。直观理解就是:模型在自己会生成的 token 上,持续把概率分布往参考模型认可的方向拉近。
Reverse KL 的选择
KL 有两个方向。Forward KL 更偏向覆盖参考模型的所有可能输出,会鼓励当前模型把参考模型的多种模式都学一点。这个目标更全面,但对小模型不一定友好:容量有限,什么都想学,最后可能什么都不精。
Reverse KL 则有 mode-seeking 的性质。当前模型会更集中地学习参考模型最认可的高概率模式。
这对推理任务很合适。很多数学题并不需要模型平均模仿所有推导风格,而是需要找到一条教师认可的路径,然后坚定走下去。
MiniLLM 这篇论文较早系统地把 reverse KL 用到 LLM 蒸馏里,实验结论也很符合直觉:目标模型越小,reverse KL 的优势越明显。
小模型不是小号大模型,它的容量预算更紧。与其让它平均覆盖参考模型的所有可能性,不如让它先学会参考模型最确定、最稳定、最有价值的那几条路径。
OPD 还有一个很有吸引力的地方:它不像普通 RL 那样容易 reward hacking。KL 信号来自参考模型分布,当前模型要么靠近它,要么远离它,很难通过奇怪策略“骗分”。
如果已经有一套 RL 框架,接入 OPD 的成本也不高。核心改动可以理解成:把 group-normalized advantage 换成参考模型和当前模型的 log ratio。
# Initialize teacher client.
teacher_client = service_client.create_sampling_client(
    base_model = teacher_config.base_model,
    model_path = teacher_config.load_checkpoint_path,
)

# Sample trajectories.
trajectories = do_group_rollout(student_client, env_group_builder)
sampled_logprobs = trajectories.loss_fn_inputs["logprobs"]

# Compute reverse KL signal.
teacher_logprobs = teacher_client.compute_logprobs(trajectories)
reverse_kl = sampled_logprobs - teacher_logprobs
trajectories["advantages"] = -reverse_kl

# Train with the existing RL path.
training_client.forward_backward(trajectories, loss_fn = "importance_sampling")
OPD 的效率来源
这里有三组相关但不能混用的数据。第一组来自 Thinking Machines Lab 的独立复现实验:Qwen3-8B-Base 在 40 万条 OpenThoughts-3 样本上完成 off-policy 蒸馏后,full finetuning checkpoint 的 AIME’24 约为 60%;随后使用 OPD,约 150 个训练 step 后达到 70%。
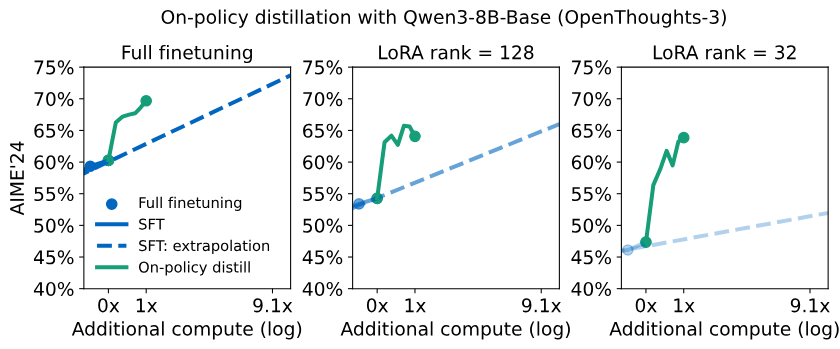
来源:Thinking Machines Lab, On-Policy Distillation 中的无编号网页图;网页无页码。横轴是作者按 FLOPs 折算的附加计算量;9–30 倍是该文相对 SFT 外推得到的条件性估算,不是 OPD 的通用加速比。
第二组来自 Qwen3 Technical Report Table 21。它比较 Qwen3-8B 学生阶段的 off-policy 蒸馏、直接 RL 与 OPD;这里的 GPU hours 是该表报告的学生训练成本,不能与上图的 FLOPs 横轴直接换算。
| 方法 | AIME’24 | GPU hours |
|---|---|---|
| Off-policy 蒸馏 | 55.0 | 未报告 |
| 直接 RL | 67.6 | 17,920 |
| OPD | 74.4 | 1,800 |
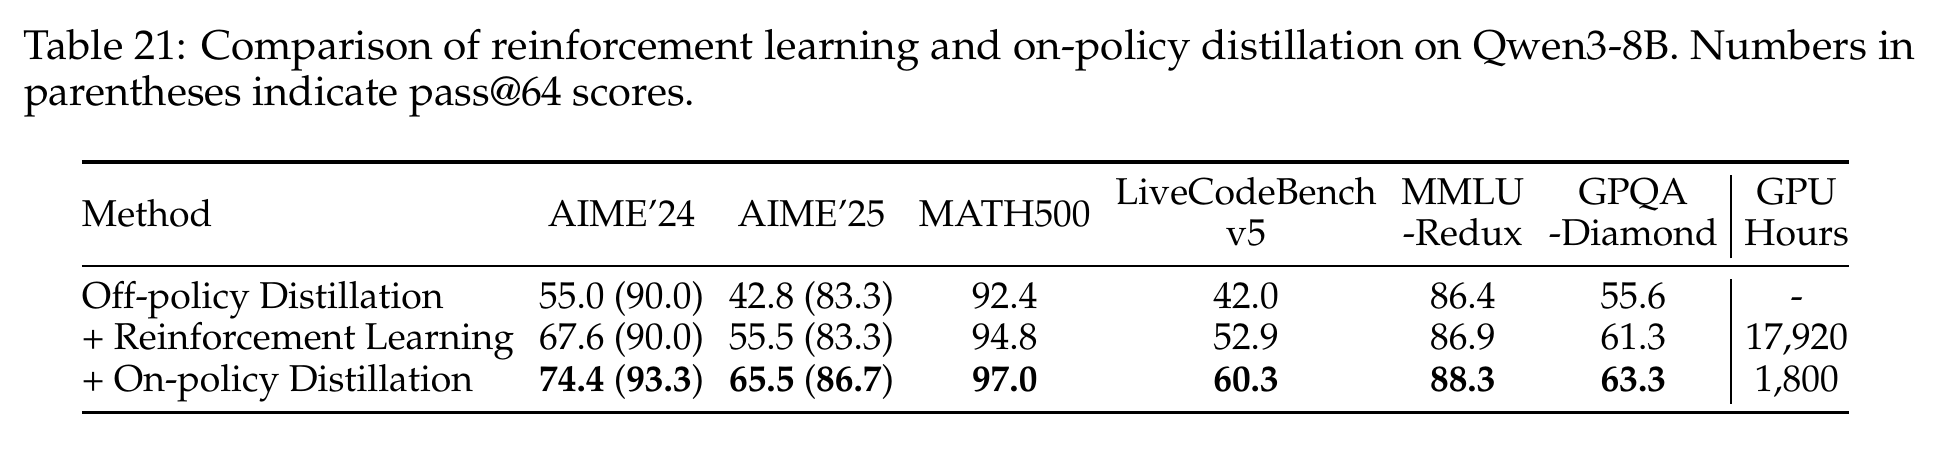
来源:Qwen3 Technical Report,Table 21,第 21 页。括号内为 pass@64;表中的 1,800 GPU hours 不包含训练强教师所需的前置成本。
我的判断是:OPD 的效率优势主要来自训练信号密度。
第三组是 Thinking Machines Lab 的 matched self-distillation 实验:先用 RL 训练 Qwen3-8B-Base,再把得到的策略作为教师蒸馏回同一个 base 初始化。该设置下,OPD 在不到 10 个梯度 step 内恢复教师的 AIME’24 水平,而 RL 约用了 70 个 step;作者据此估算该实验的累计计算量降低约 50–100 倍。
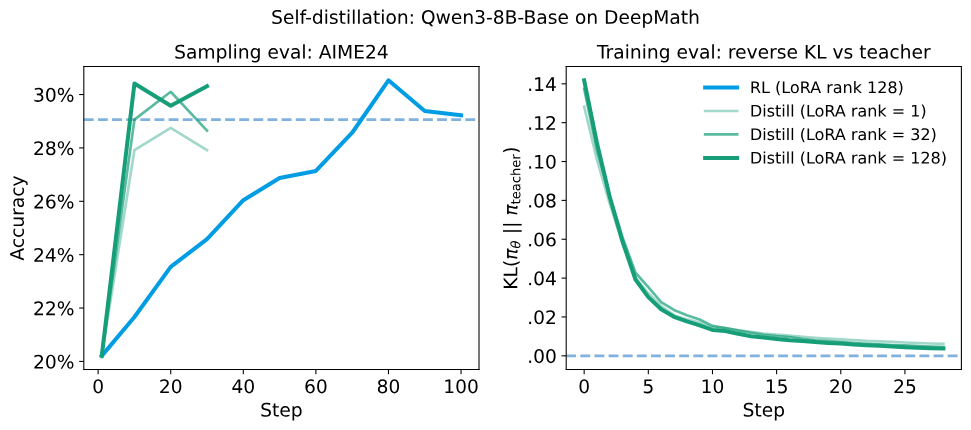
来源:Thinking Machines Lab, On-Policy Distillation 中的无编号网页图;网页无页码。这组 50–100 倍估算来自同架构 self-distillation 设置,与 Qwen3 Table 21 不是同一次实验。
纯 RL 可能要生成很多条轨迹,才从最终奖励里估计出一点有用方向。OPD 则能让一条序列中的大量 token 都贡献教师条件概率信号。三组结果都支持“密集监督提高迁移效率”这一解释,但具体倍数取决于初始化、教师、batch、rollout 长度和成本统计方式。
在 Qwen3 Table 21 的特定 8B 学生训练对比里,OPD 报告的 GPU hours 约为直接 RL 的十分之一。这个结果说明已有强教师时,能力迁移可以明显便宜于重新探索;它不证明教师的训练成本消失,也不能推出所有 OPD 配方都有相同收益。
四家团队的四种用法
OPD 的基本思想并不复杂,但落地时,各家的选择很不一样。这些差异恰好说明 OPD 不是单一配方,而是一组可以组合的后训练工具。
Qwen3:把旗舰能力压进轻量模型
Qwen3 的场景很务实:旗舰模型走完整后训练流程,轻量模型不再重复执行同样昂贵的 RL,而是通过 OPD 吸收旗舰模型能力。
它采用两阶段设计:
- 先做 off-policy 蒸馏,让轻量模型具备基本解题模式。
- 再做 on-policy 蒸馏,让轻量模型在自己的轨迹上被参考模型纠偏。
这个顺序很关键。OPD 的信号质量依赖当前模型自己生成的轨迹。如果模型一开始太弱,参考反馈主要是在修噪声,不是在传能力。
Qwen3 的定位可以概括成:OPD 是轻量模型训练的效率替代方案。
GLM-5:用 OPD 修复多阶段 RL 的遗忘
GLM-5 面对的是另一类问题:多阶段 RL 之间会互相冲突。
Reasoning RL、Agentic RL、General RL 顺序执行后,后面的 general 能力增强可能会侵蚀前面积累的 reasoning 能力。这就是后训练里的灾难性遗忘。
GLM-5 的做法,是把 OPD 放到最终收尾阶段,用前序阶段的 checkpoint 当参考模型,让当前模型从自己的分布采样,再把丢掉的能力补回来。
这里有个很精巧的工程点:GRPO 通常需要较大的 group size 做组内比较;但 OPD 的 advantage 直接来自教师 log ratio,不需要组内对比,所以 group size 可以降到 1,batch size 可以做大,吞吐也更好。
GLM-5 的定位可以概括成:OPD 是多阶段后训练后的能力修复器。
MiMo-V2:在 logit 空间整合多教师能力
MiMo-V2 解决的是 see-saw effect:数学变强,代码可能变弱;代码变强,通用对话又可能受损。
本质上,这是多个目标在同一个参数空间里互相拉扯。不同任务的梯度方向不一致,mixed RL 很容易顾此失彼。
MiMo-V2 的路线是:
- 通用 SFT 打底。
- 各领域专家独立 RL,避免训练阶段互相干扰。
- 用多教师 OPD 在 logit 空间完成能力整合。
它还在 KL 信号之外加入 ORM(Outcome Reward Model)。KL 负责提供 token 级别的方向,ORM 负责确保最终答案对齐可验证结果。
最有意思的是,最终模型在部分基准上超过了单个专家。原因也不玄学:多教师融合后,模型学到的是多个专家的合成能力,而不是某一个专家的上限。
MiMo-V2 的定位可以概括成:OPD 是多专家能力融合器。
DeepSeek-V4:用 full-vocabulary KL 做大规模统一化
DeepSeek-V4 的场景更重:要整合 10 个以上独立训练的专家模型,而且每个领域还有不同推理强度的变体。
参数合并会稀释能力,mixed RL 会遇到 see-saw effect。DeepSeek-V4 的选择是更彻底地把统一化阶段交给 OPD。
它和多数团队最大的差异,是使用 full-vocabulary KL,而不是只在采样 token 上做 token-level KL 近似。
token-level KL 计算便宜,但方差更高。教师数量一多,噪声叠加后,loss 会变得更不稳定。full-vocabulary KL 给出更精确的梯度,但显存和计算压力巨大:词表大小、序列长度、教师数量都会一起放大成本。
所以 DeepSeek-V4 配套做了教师权重调度、hidden state 缓存和专用 kernel。工程复杂度明显更高,但在超大规模多教师蒸馏场景下,这类投入是合理的。
DeepSeek-V4 的定位可以概括成:OPD 是大规模专家知识压缩器。
分歧背后的设计哲学
把四家放在一起看,可以看到几个关键分歧。
| 维度 | 轻量路线 | 重工程路线 | 我的判断 |
|---|---|---|---|
| KL 粒度 | token-level KL | full-vocabulary KL | 小规模先追效率,大规模多教师更需要稳定梯度 |
| 奖励信号 | 只用 KL | KL + ORM | 教师足够可靠时纯蒸馏即可,需要外部验证时叠加 reward |
| 教师选择 | 单教师 / 同架构 checkpoint | 多教师 / 专家集合 | 单教师简单稳定,多教师更适合能力融合 |
| 流水线位置 | 轻量模型子流程 / 收尾阶段 | 主体整合阶段 / 统一化阶段 | OPD 可以是降本工具,也可以是能力整合工具 |
这也是 OPD 值得关注的地方:它不是某个团队的一招鲜,而是可以嵌入不同后训练流水线的一种基础能力。
Logit 空间作为整合接口
传统知识整合经常在参数空间里做:weight merge、adapter 叠加、mixed RL。问题是参数空间里的能力很难拆开,专家之间的干涉几乎不可避免。
OPD 换了一个角度。专家模型可以独立存在,知识以 logit 分布的形式流入目标模型。目标模型仍然只更新自己的参数,但学习信号来自参考模型在当前轨迹上的判断。
这更像多个评审系统同时作用在一条正在生成的轨迹上。每个专家不需要参与参数合并,只需要在自己擅长的分布上提供判断。最后真正完成整合的,是目标模型自己的参数。
所以我认为 OPD 的价值不只是“更省 GPU”。它更像是在提示一个训练设计方向:
后训练里的能力整合,不一定非要在参数空间完成。很多时候,logit 空间可能是更自然、更稳定、也更可扩展的接口。
OPD 的边界
当然,OPD 也有很明确的边界。
第一,它强依赖教师质量。教师如果有系统性缺陷,OPD 会忠实传递,甚至放大这些缺陷。选教师、筛数据、定任务域,仍然是核心工作。
第二,它缺少探索能力。OPD 本质上是模仿,不是发现。纯 RL 可能探索出教师没有覆盖的新策略,OPD 更擅长把已有强能力稳定转移出来。所以现实里更合理的方式通常是:RL 负责探索,OPD 负责压缩和整合。
第三,长序列成本会变高。OPD 需要参考模型在当前模型轨迹上做 forward。序列越长,参考模型计算和显存压力越大。分段采样可以缓解,但不是根治。
第四,它对模型初始化敏感。模型太弱时,on-policy 轨迹质量差,参考反馈就更像是在纠正噪声。Qwen3 先 off-policy 蒸馏再 OPD,本质上就是在解决这个冷启动问题。
写在最后
OPD 的崛起不是偶然。
它同时踩中了后训练里的三个痛点:信号密度低、分布错位、能力干扰。更关键的是,它提供了一套可复制、可扩展的能力整合思路。
我现在会把 OPD 理解成一句话:
轨迹来自当前模型,方向来自强参考模型。
这句话听起来朴素,但放到后训练里非常有力量。它解释了 OPD 相比纯 RL 的效率优势,也解释了它对 off-policy 蒸馏 exposure bias 的缓解作用,还解释了多教师知识可以绕开参数合并的混乱,转而在 logit 空间完成整合。
如果正在做模型后训练,OPD 值得认真研究。它不一定适合所有场景,但理解它背后的取舍,会让人重新审视后训练的目标:训练的不只是一个模型,也是一套能力流动的接口。
参考文献
- Qwen3 Technical Report (arXiv 2505.09388)
- GLM-5: from Vibe Coding to Agentic Engineering (arXiv 2602.15763)
- MiMo-V2-Flash Technical Report (arXiv 2601.02780)
- DeepSeek-V4 Technical Report
- On-Policy Distillation, thinkingmachines.ai
- MiniLLM: Knowledge Distillation of Large Language Models via Reverse KL Divergence (ICML 2024)
- DAGGER: An Algorithm for Reduction of Expert Failures
- Process Reward Modeling: Learning to Verify without Multi-Agent Oracles
- thinkingmachines.ai/blog/on-policy-distillation/