CapRL:用强化学习激发视觉语言模型的描述能力
- 论文:CapRL: Stimulating Dense Image Caption Capabilities via Reinforcement Learning(CVPR 2025)
- 作者:Xing et al.
- 总结:CapRL 用 vision-free LLM 的 MCQ 答题准确率评价 caption,将主观的描述质量评分改造成可验证奖励,并据此训练图像描述模型。
1. 引言:图像描述的奖励定义问题
图像描述的训练目标容易定义,评价标准却很难写清。只描述主体,信息量不够;继续补充细节,又会提高幻觉概率。对于 dense caption,实际需要优化的是信息覆盖与事实准确性的组合,而不是长度或语言风格。
传统方法通常先用 SFT 模仿人工 caption。高质量 dense caption 的标注成本高,训练数据也只能覆盖有限的描述方式;BLEU、ROUGE 等文本重叠指标则难以判断描述是否完整、事实是否准确。
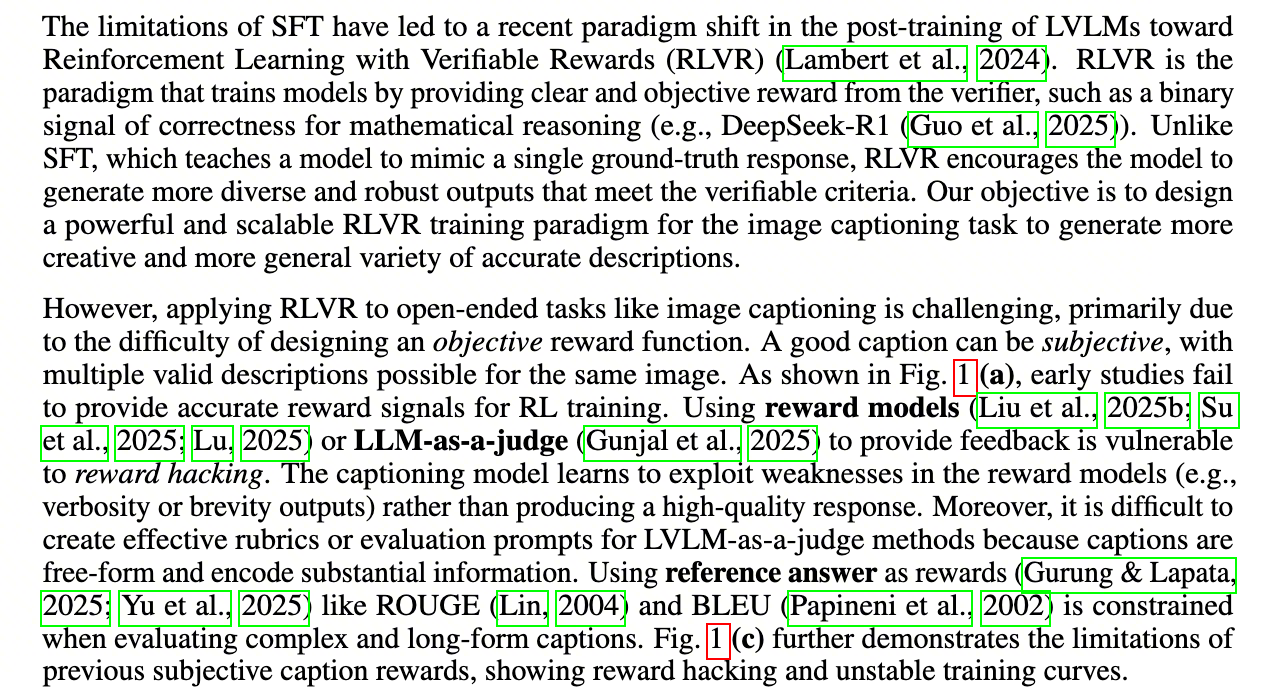
RL 允许模型探索人工标注之外的描述方式,但没有自动解决评价问题。只要奖励仍来自另一个模型的主观评分,策略模型就可能优化评估器偏好,而不是 caption 本身的质量。CapRL 的工作重点正是重新定义这部分奖励。
2. 现有 RL 方法的困境:Reward Hacking
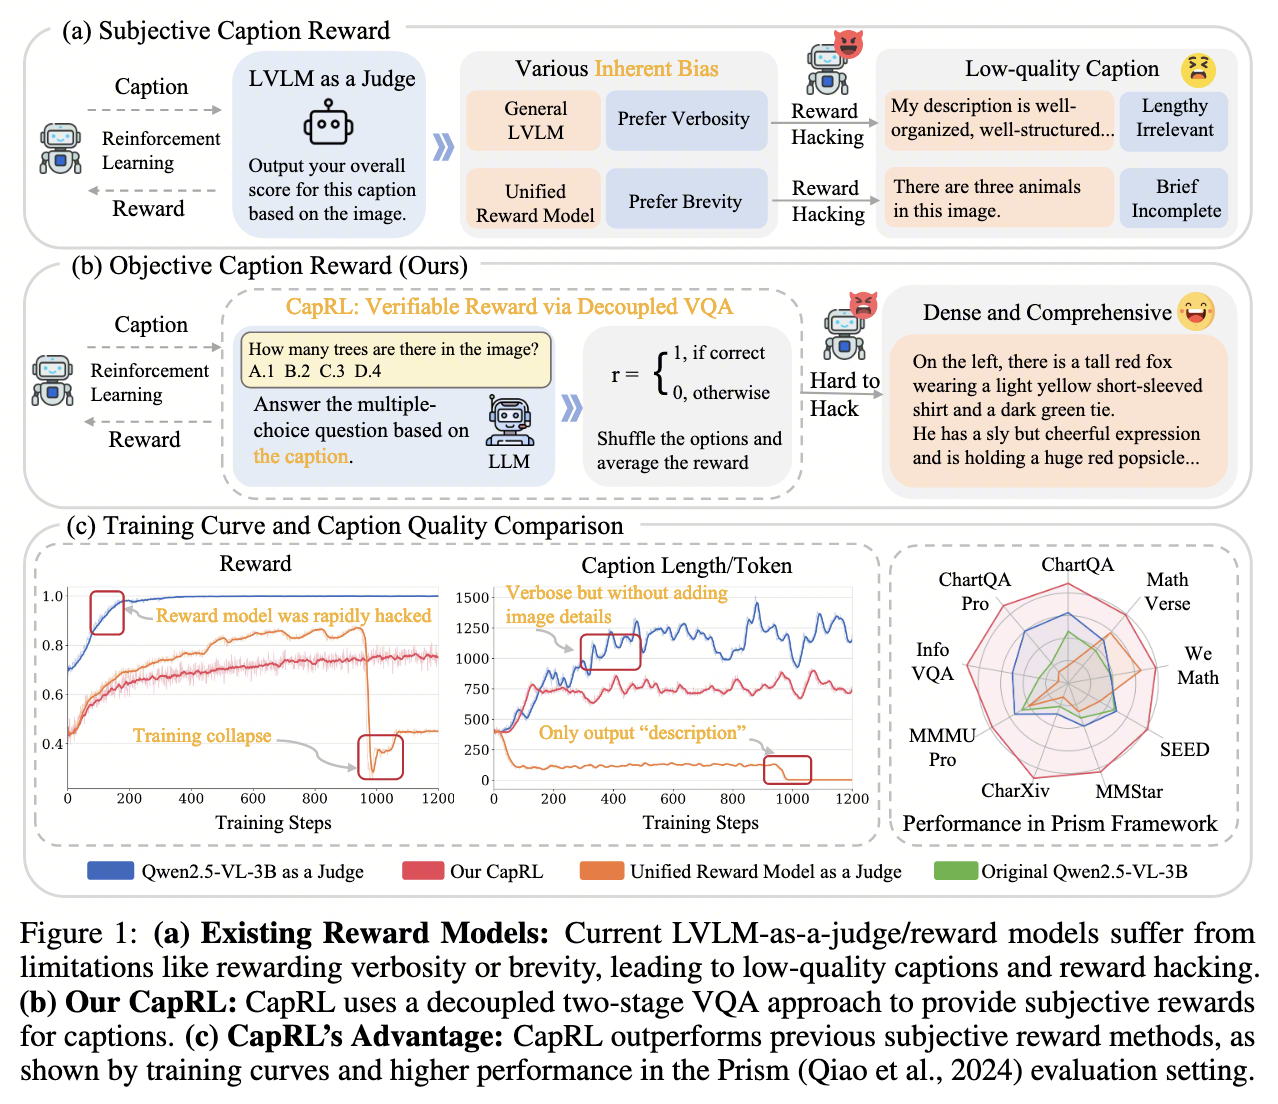
现有方法常用另一个 LVLM 作为 judge,根据图像和 caption 给出分数。但这个分数同时混入了内容覆盖、长度、语言风格和组织方式。通用 LVLM 可能偏爱更长、更详细的回答,某些 reward model 则偏好简短、干净的输出。policy model 一旦找到这些偏好,就能在没有改善图像描述的情况下提高奖励。
2.1 「裁判」的偏见
LVLM-as-a-Judge 的奖励不是纯粹的事实校验。它会把内容覆盖、语言风格、长度、组织方式混在一个分数里。这个分数一旦进入 RL,模型就会优先优化最容易被 judge 捕捉到的特征。
论文对比了两类方向相反的偏差:Qwen2.5-VL-3B 作为 judge 时偏爱冗长描述,Unified Reward Model 则偏爱简洁输出。偏好方向不同,问题相同:综合分数没有把事实覆盖与表达风格分开。
2.2 策略模型的「钻空子」
这种偏差会被 policy model 利用。面对偏爱冗长的 judge,模型可能输出大量看似结构完整、实际与图像无关的文字:
# 面对偏爱冗长的裁判
输出: "我的描述组织得很好,结构很完善,首先我要说明..."
结果: 高分,但没有描述图像内容

# 面对偏爱简洁的裁判
输出: "图中有三只动物"
结果: 高分,但信息量极低
这类输出构成 Reward Hacking:奖励持续上升,目标任务却没有改善。进一步训练还可能发生 collapse,表现为 caption 长度快速膨胀,或缩短到几乎不含信息。CapRL 因此不再直接评价 caption 的整体质量,而是检查 caption 能否支持一个可判定对错的任务。
3. CapRL 的奖励设计
CapRL 对「好描述」采用功能性定义:
一段高质量 caption 应该让看不到图像的纯文本 LLM,仅凭 caption 回答图像相关问题。
MCQ 把开放式评价压缩成了可判定的答题结果。无关的长文本无法提供答案,遗漏颜色、数量或位置关系则会直接失分;调整问题分布,还可以改变奖励关注的视觉信息。这里需要注意,所谓「可验证」只针对问题集覆盖到的内容,并不等价于 caption 的所有质量维度都得到了验证。
3.1 Subjective Caption Reward:主观描述奖励
图中左侧对应传统的主观奖励流程。policy model 生成 caption 后,caption 和图像会一起交给 LVLM-as-a-Judge,由 judge 输出一个综合分数作为 RL 奖励。
这个流程能够打分,但分数含义不够单一。judge 会把「详细」「简短」「结构清楚」等风格特征一并计入奖励,policy model 随后沿着这些偏好优化。论文中的结果很直接:偏爱冗长的 judge 诱导出「Lengthy Irrelevant」文本,偏爱简洁的 reward model 则诱导出「Brief Incomplete」描述。
3.2 Objective Caption Reward:CapRL 的做法
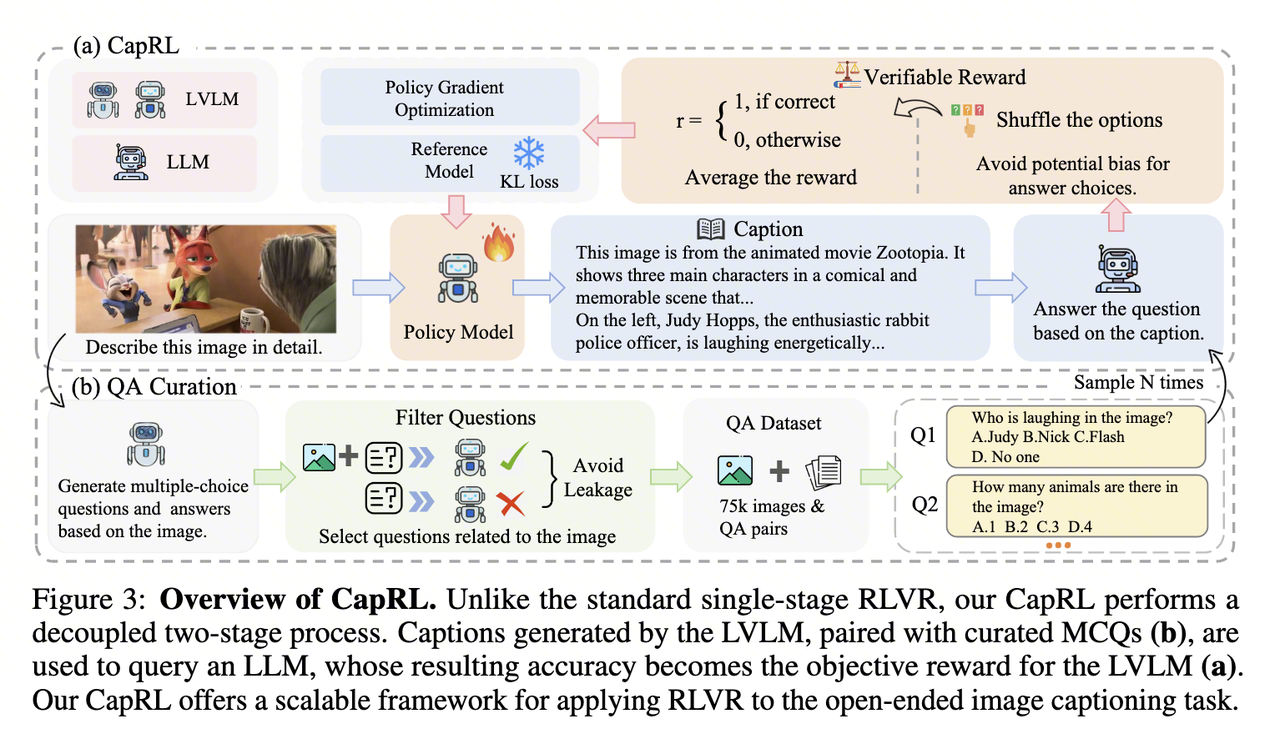
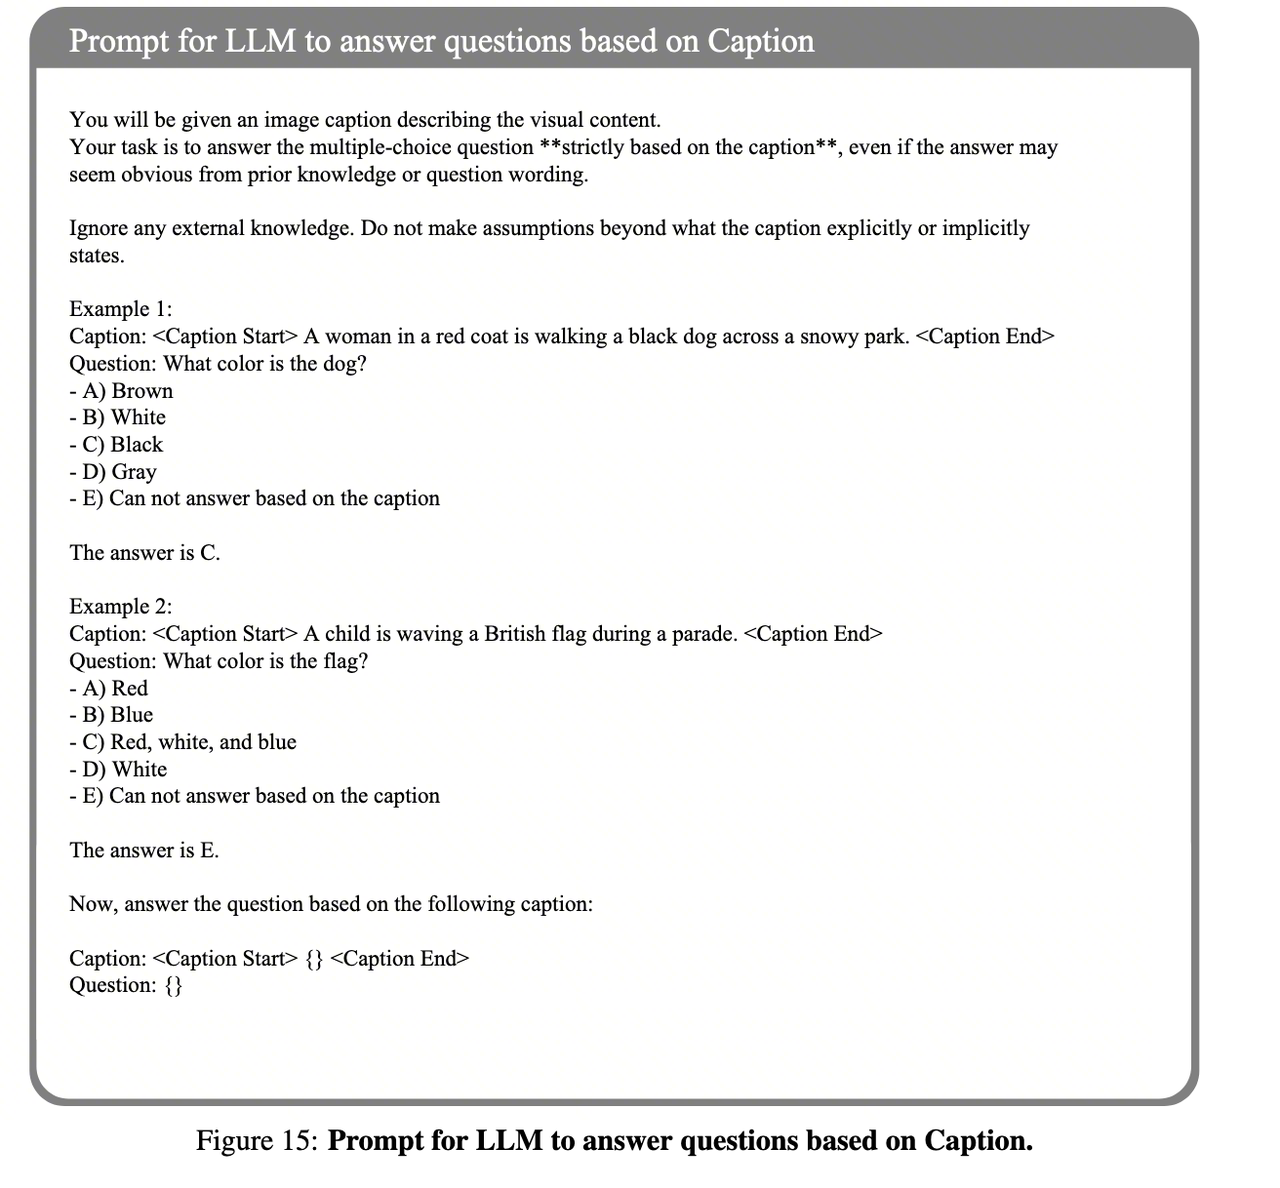
CapRL 使用解耦 VQA 来计算奖励。流程是:policy model 先根据图像生成 caption;随后,一个看不到图像的纯文本 LLM 读取 caption 和该图像对应的 MCQ,并尝试回答问题。答对越多,caption 奖励越高。
vision-free 是该设计成立的前提。评估模型看不到原图,无法绕过 caption 直接回答视觉问题。caption 缺少颜色、数量、位置关系或可见文字时,LLM 会在对应问题上失分。
3.3 训练曲线与描述质量对比
图中左侧的 reward 曲线和中间的 caption length 曲线主要反映训练稳定性。
- 蓝色曲线使用 Qwen2.5-VL-3B 作为 judge。reward 很快达到 1.0,同时 caption 长度快速增加,符合「用冗长输出攻击奖励」的模式。
- 橙色曲线使用 Unified Reward Model 作为 judge。reward 上升后出现 training collapse,caption 长度也下降到接近零。
- 红色曲线对应 CapRL。reward 变化更平滑,caption 长度没有出现极端膨胀或坍缩。
右侧雷达图报告了 Prism Framework 下 ChartQA、MathVerse、SEED 等 benchmark 的结果。CapRL 在多数维度上优于原始模型和另外两类 reward 训练结果。仅凭这张图还不足以说明 MCQ reward 普遍优于主观 reward,但至少可以确认:在论文给定的训练与评测设置中,CapRL 避免了明显的 reward hacking,且没有以牺牲下游多模态任务表现为代价。
4. 高质量 MCQ 数据集构建
MCQ 数据决定了 CapRL 奖励的有效范围。如果问题不看图也能回答,再差的 caption 也可能获得奖励;如果图片本身不支持答案,奖励就会变成噪声。论文为此构建图像相关的 MCQ,并专门筛除存在信息泄露的样本。
4.1 第一阶段:图像收集
图像来源包括 ShareGPT4V-1M、DenseFusion-1M 等开源数据集,也包括网络搜集的自然照片、文档、图表、用户界面等类别。
收集完成后,数据会经过质量和安全过滤,去除低分辨率、过于简单,以及涉及暴力或色情内容的样本。研究团队还移除了与常见评测基准高度相似的图片,以降低 benchmark leakage 风险。
4.2 第二阶段:问答对生成
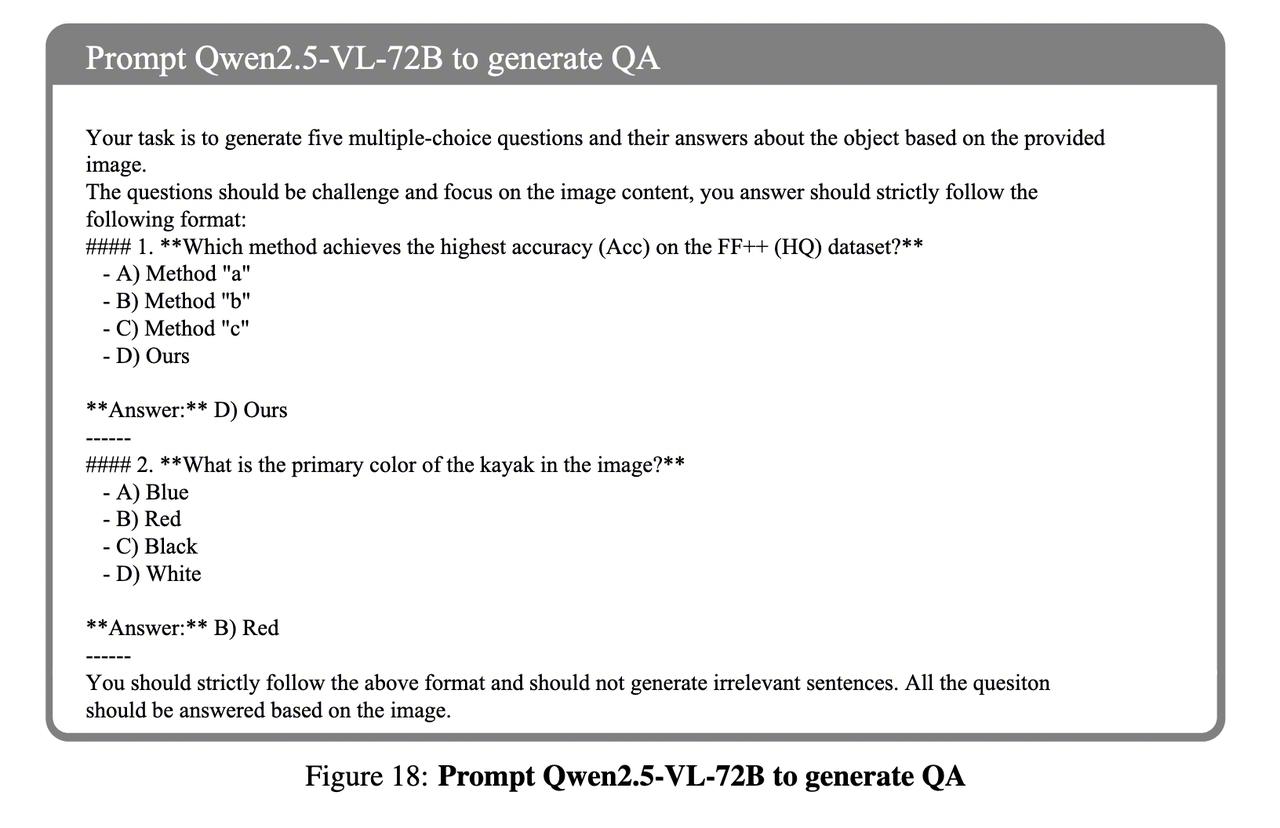
对每张图片,论文使用 Qwen2.5-VL-72B 生成多个与图像内容相关的 MCQ 及正确答案。
4.3 第三阶段:问答对筛选
筛选阶段要排除不依赖视觉信息的问题。例如,一张图片中出现「Eiffel Tower」标志,如果问题是「What is the capital of France?」,模型仅凭常识就能回答「Paris」。这类问题无法检验 caption 是否保留了图像信息。
论文采用一正一反的双重验证机制:
- 正向验证:把「图片 + 问题」输入 LVLM,要求模型能答对。论文中筛选阶段为了节省成本使用 Qwen2.5-VL-3B。这个条件保证问题确实和图像内容相关,答案能从图像中得到。
- 反向验证:只把「问题」输入同一个 LVLM,不提供图片,要求模型答错。这个条件排除仅靠语言逻辑或常识就能回答的问题。
问答对 (q, a) 只有同时满足这两个条件才会被保留。论文中的筛选公式如下:
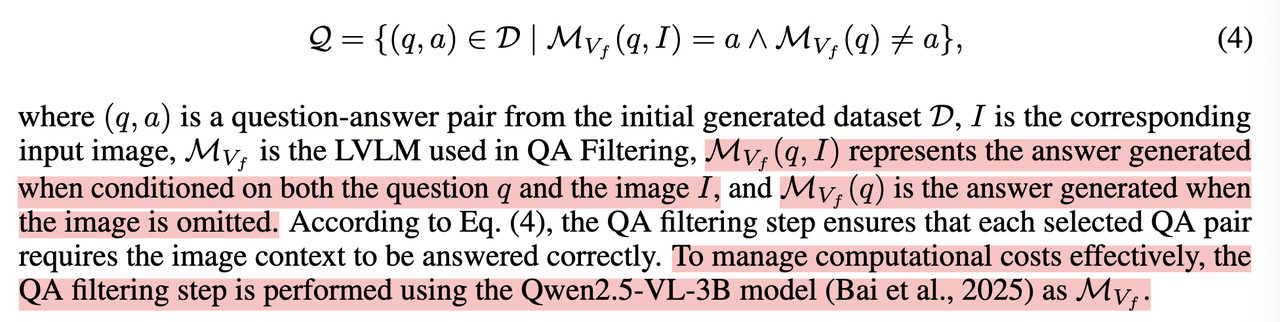
Q是最终筛选出的数据集。(q, a)是一个问答对。D是初始生成的数据集。Mv(q, I) = a表示模型看到图片I和问题q时能答对答案a。Mv(q) ≠ a表示模型只看到问题q时答不对答案a。
5. 方法详解
CapRL 将 caption 生成与奖励计算拆成两个模型:LVLM 根据图像生成 caption,vision-free LLM 再根据 caption 回答问题。reward 由答题结果计算,不再来自裁判对 caption 的整体印象。
5.1 第一阶段:LVLM 生成图像描述
需要训练的策略模型是 Qwen2.5-VL-3B。模型接收图像和描述指令,例如「详细描述这张图片」,并生成候选 caption。
5.2 第二阶段:Vision-Free LLM 回答问题
候选 caption 和该图像对应的 MCQ 会一起输入到独立的纯文本 LLM,即 Qwen2.5-3B-Instruct。这个模型无法访问图像,只能依赖 caption 中的信息回答问题。
5.3 奖励计算
纯文本 LLM 根据 caption 回答每个问题:答对记为 1,答错记为 0;所有问题的平均准确率即为该 caption 的奖励。
对于生成的描述 \(c\) 和问题集合 \(\{q_1, q_2, ..., q_n\}\):
\[ R(c) = \frac{1}{n}\sum_{i=1}^{n}\mathbb{1}\left[\text{LLM}(c, q_i) = a_i\right] \]
其中:
- \(c\) 是生成的图像描述。
- \(q_1, q_2, ..., q_n\) 是对应的问题集合。
- \(a_i\) 是第 \(i\) 个问题的正确答案。
- \(\mathbb{1}[\cdot]\) 是示性函数,条件为真时取 1,否则取 0。
该奖励直接检查 caption 是否包含答题所需的信息。caption 对物体数量、空间关系、图表内容或可见文字的描述越准确,vision-free LLM 的答题准确率通常越高。
5.4 模型优化与训练
得到奖励后,CapRL 使用 GRPO 更新第一阶段的 LVLM。模型反复生成 caption,经由第二阶段奖励机制得到反馈,再根据奖励优化参数。
整个闭环是:
生成描述 -> 客观评估 -> 获得奖励 -> 优化模型 -> 生成新的描述6. 方法价值与成本转移
CapRL 最有价值的部分不是使用 GRPO 训练 caption 模型,而是给开放式描述任务构造了一个可分析的 reward 接口。问答准确率并不等于完整的 caption 质量,但它比「judge 给几分」更容易定位失败原因,也更难被无关套话直接攻击。论文图 2 中,CapRL 训练后的模型对图表和复杂场景覆盖得更充分,生成结果也更接近可供问答使用的中间表示。
该方法缓解了 SFT 对固定 caption 标注的依赖,但没有消除数据成本。成本从人工撰写 dense caption 转移到了图像收集、MCQ 生成、正反验证,以及训练期间的额外推理。问题质量和筛选模型能力会直接影响 reward;每个 caption 还需要触发多道 MCQ 推理。因此,「流程可以自动化」与「训练成本低」是两回事。
7. 方法分析
7.1 有效性来自哪里
CapRL 有效的原因不在于「用 RL 做 caption」,而在于 reward 与 caption 的功能更接近。图像描述本质上是将视觉信息压缩为文本。传统 judge 判断「写得好不好」,其中混合了风格、长度、完整性和准确性;CapRL 检查「这段文本能否支持回答图像问题」,判定标准更窄,也更容易用于训练。
开放式生成任务很难直接评价,封闭式验证则相对容易。MCQ 的答案非对即错,奖励信号比主观评分更清晰。代价在于,奖励只能覆盖问题集涉及的内容;未被问题覆盖的视觉信息不会自然进入优化目标。
生成 caption 的 LVLM 与回答问题的纯文本 LLM 相互解耦后,评估器只能从 caption 中取证,视觉无关的套话很难直接得分。reward 因而更接近检查「图像信息是否真正写进 caption」。
7.2 从描述奖励到功能性验证
CapRL 的思路可以抽象成一句话:直接评价质量困难时,改用下游任务表现定义上游产物的质量。
| 任务 | 类比应用 |
|---|---|
| 文档摘要 | 好的摘要应能支持回答关于原文的问题 |
| 知识图谱构建 | 好的 KG 应能支持多跳推理查询 |
| 代码文档生成 | 好的文档应能帮助开发者正确使用 API |
| 数据标注 | 好的标注应能支持下游模型的准确预测 |
这一思路适用于「生成物本身难以评分,但可以通过功能性测试验证」的任务。风险也很明确:代理任务一旦偏离原任务,模型仍会 reward hacking,只是攻击目标从 judge 的风格偏好换成了问题集的分布。
7.3 局限性与后续问题
MCQ 覆盖决定模型学到什么。如果问题集偏向物体识别,模型可能更关注类别、数量和位置,而忽略氛围、叙事关系或细粒度风格信息。问题生成策略本身就是新的 inductive bias。
caption 质量也不等于问答准确率。可读性、逻辑组织、冗余控制和语言流畅性很难由 MCQ 完整捕捉。若只优化答题结果,模型仍可能生成信息齐全但阅读体验很差的描述。
评估 LLM 的能力也是方法上限之一。如果纯文本 LLM 推理能力不足或指令遵循不稳定,奖励就会带有噪声;如果它能够利用问题选项的模式猜测答案,奖励又会受到污染。正反验证可以缓解部分问题,但无法完全消除它们。
计算开销同样不可忽视。每个 caption 都会触发多道 MCQ 推理,训练成本高于普通 SFT。实际使用时需要在问题数量、评估模型大小和 reward 稳定性之间取舍。
8. 总结
CapRL 用一个具体的功能性测试替代了 caption 的主观综合评分:纯文本 LLM 能否只根据 caption 回答图像问题。训练曲线表明,该 reward 在论文设置中避免了两类 judge 引发的长度崩溃。
它的实现依赖两项配套设计:一是通过「看图能答对、不看图答不对」筛选 MCQ,减少常识和语言线索泄露;二是使用 GRPO,让 VLM 学习生成更能支持问答的 dense caption。
我的判断是,CapRL 更适合作为奖励设计案例来阅读,而不是把它简单归类为 caption 模型训练方法。数学题的 reward 天然可验证,caption 的 reward 则需要人为构造问题集。这个接口确实比 LVLM-as-a-Judge 更清晰,但它的边界同样清晰:问题集覆盖什么,模型才会稳定优化什么。
9. 延伸阅读
如果你对 RLHF 和奖励模型设计感兴趣,以下工作值得进一步了解:
- RLAIF:Constitutional AI,Anthropic 2023:使用 AI 反馈替代人类反馈。
- RLVR:DeepSeek-R1:基于可验证奖励的强化学习。
- Self-Rewarding LM:Meta 2024:让模型自我评判以实现迭代改进。
本文为个人论文阅读笔记整理,如有疏漏欢迎指正。