SAPO:用连续软门控替代策略比率的硬截断
- 论文:Soft Adaptive Policy Optimization
- 作者:Chang Gao、Chujie Zheng、Xiong-Hui Chen 等,Qwen Team
- 相关报告:Qwen3-VL Technical Report
- 核心问题:如何在抑制高方差 off-policy 更新的同时,避免硬截断直接丢弃仍有价值的 token 级梯度。
SAPO(Soft Adaptive Policy Optimization)处理的是 group-based RL 中一个很具体的优化问题:同一批 rollout 被重复更新后,当前策略与采样策略之间会产生偏移,token 级重要性采样比率随之偏离 1。GRPO 用 hard clip 阻断危险方向上的大幅更新,GSPO 则把约束提升到序列级;二者都可能在越过固定边界后直接移除梯度。
SAPO 没有重新设计 reward 或 advantage estimator。它替换的是代理目标中作用于策略比率的函数:hard clip 改为以 \(r=1\) 为中心的 sigmoid soft gate。真正进入梯度的门控权重是一条平滑钟形曲线,偏移越大,权重越小;正、负 advantage 还使用不同温度,以更快抑制负向更新造成的全词表扩散。
本文重点核对四件事:soft gate 如何进入目标函数,梯度权重为什么在 on-policy 点等于 1,非对称温度的依据是什么,以及论文中的稳定性证据支持到什么范围。
1. Hard clipping 丢失了哪些梯度
1.1 GRPO 的 token 级截断
对查询 \(q \sim \mathcal{D}\),旧策略 \(\pi_{\theta_{\mathrm{old}}}\) 采样 \(G\) 个回答 \(\{y_i\}_{i=1}^{G}\)。GRPO 使用 token 级重要性采样比率
\[ r_{i,t}(\theta) = \frac{ \pi_\theta(y_{i,t}\mid q,y_{i,<t}) }{ \pi_{\theta_{\mathrm{old}}}(y_{i,t}\mid q,y_{i,<t}) }, \]
并通过组内奖励标准化得到序列 advantage:
\[ \widehat{A}_{i,t} = \widehat{A}_i = \frac{ R_i-\operatorname{mean}(\{R_j\}_{j=1}^{G}) }{ \operatorname{std}(\{R_j\}_{j=1}^{G}) }. \]
其 clipped surrogate objective 为
\[ \begin{aligned} \mathcal{J}_{\mathrm{GRPO}}(\theta) = \mathbb{E} \Bigg[ \frac{1}{G}\sum_{i=1}^{G} \frac{1}{|y_i|}\sum_{t=1}^{|y_i|} \min\Big(& r_{i,t}(\theta)\widehat{A}_i,\\ &\operatorname{clip} \left(r_{i,t}(\theta),1-\varepsilon,1+\varepsilon\right) \widehat{A}_i \Big) \Bigg]. \end{aligned} \]
这里需要避免一个常见的简化:并不是 \(r\) 越过任一边界,梯度都会归零。门控方向取决于 advantage 的符号。对 \(r\) 求导后,GRPO 的有效 gate 为
\[ f_{\mathrm{GRPO}}'(r;\widehat{A}) = \begin{cases} 1, & \widehat{A}>0\ \text{且}\ r\le 1+\varepsilon,\\ 0, & \widehat{A}>0\ \text{且}\ r>1+\varepsilon,\\ 1, & \widehat{A}\le 0\ \text{且}\ r\ge 1-\varepsilon,\\ 0, & \widehat{A}\le 0\ \text{且}\ r<1-\varepsilon. \end{cases} \]
这种二值 gate 能阻止策略继续沿危险方向移动,但代价也很直接:刚越过边界的 token 和严重偏离旧策略的 token 都拿到 0 权重。收紧 \(\varepsilon\) 会丢失更多样本,放宽又会引入高方差更新。
1.2 GSPO 的序列级截断
GSPO 把 token ratio 的几何平均作为长度归一化后的序列级比率:
\[ s_i(\theta) = \left( \frac{\pi_\theta(y_i\mid q)} {\pi_{\theta_{\mathrm{old}}}(y_i\mid q)} \right)^{\frac{1}{|y_i|}} = \exp\left( \frac{1}{|y_i|} \sum_{t=1}^{|y_i|}\log r_{i,t}(\theta) \right). \]
序列级比率更贴近序列级 reward,也降低了单个 token ratio 的高方差影响。问题在于,一旦少数 outlier token 把 \(s_i\) 推出 hard-clipping band,整条序列中的近 on-policy token 也会一起失去梯度。SAPO 试图同时保留 GSPO 的序列一致性和 GRPO 的 token 粒度。
2. SAPO 的代理目标与梯度权重
2.1 温度可调的 soft gate
SAPO 最大化以下目标:
\[ \begin{aligned} \mathcal{J}_{\mathrm{SAPO}}(\theta) = \mathbb{E} \Bigg[ \frac{1}{G}\sum_{i=1}^{G} \frac{1}{|y_i|}\sum_{t=1}^{|y_i|} f_{i,t}\!\left(r_{i,t}(\theta)\right) \widehat{A}_{i,t} \Bigg], \end{aligned} \]
其中
\[ f_{i,t}(x) = \frac{4}{\tau_{i,t}} \sigma\!\left(\tau_{i,t}(x-1)\right), \qquad \sigma(x)=\frac{1}{1+e^{-x}}, \]
\[ \tau_{i,t} = \begin{cases} \tau_{\mathrm{pos}}, & \widehat{A}_{i,t}>0,\\ \tau_{\mathrm{neg}}, & \widehat{A}_{i,t}\le 0. \end{cases} \]
\(4/\tau_{i,t}\) 不是装饰性的缩放。它保证 soft gate 在 \(r=1\) 处的导数等于 1,使 on-policy 更新与未截断的 policy gradient 对齐。目标函数本身在 \(r=1\) 处不需要等于 \(r\);对优化方向起作用的是导数。
2.2 从代理目标到加权 policy gradient
记
\[ p_{i,t}(\theta) = \sigma\!\left( \tau_{i,t}\left(r_{i,t}(\theta)-1\right) \right). \]
对 \(f_{i,t}\) 求导:
\[ \begin{aligned} f_{i,t}'\!\left(r_{i,t}(\theta)\right) &= \frac{4}{\tau_{i,t}} \cdot \tau_{i,t} p_{i,t}(\theta)\left(1-p_{i,t}(\theta)\right)\\ &= 4p_{i,t}(\theta)\left(1-p_{i,t}(\theta)\right). \end{aligned} \]
论文将其记为梯度权重
\[ w_{i,t}(\theta) = 4p_{i,t}(\theta)\left(1-p_{i,t}(\theta)\right) = \operatorname{sech}^{2}\!\left( \frac{\tau_{i,t}}{2} \left(r_{i,t}(\theta)-1\right) \right). \]
又因为
\[ \nabla_\theta r_{i,t}(\theta) = r_{i,t}(\theta) \nabla_\theta \log\pi_\theta(y_{i,t}\mid q,y_{i,<t}), \]
最终梯度为
\[ \begin{aligned} \nabla_\theta\mathcal{J}_{\mathrm{SAPO}}(\theta) = \mathbb{E} \Bigg[ \frac{1}{G}\sum_{i=1}^{G} \frac{1}{|y_i|}\sum_{t=1}^{|y_i|} &w_{i,t}(\theta)r_{i,t}(\theta)\\ &\cdot\nabla_\theta\log\pi_\theta(y_{i,t}\mid q,y_{i,<t}) \widehat{A}_{i,t} \Bigg]. \end{aligned} \]
这组公式里最容易混淆的是 \(f\) 和 \(w=f'\):\(f\) 构成代理目标,真正缩放 token 梯度的是 \(w\)。
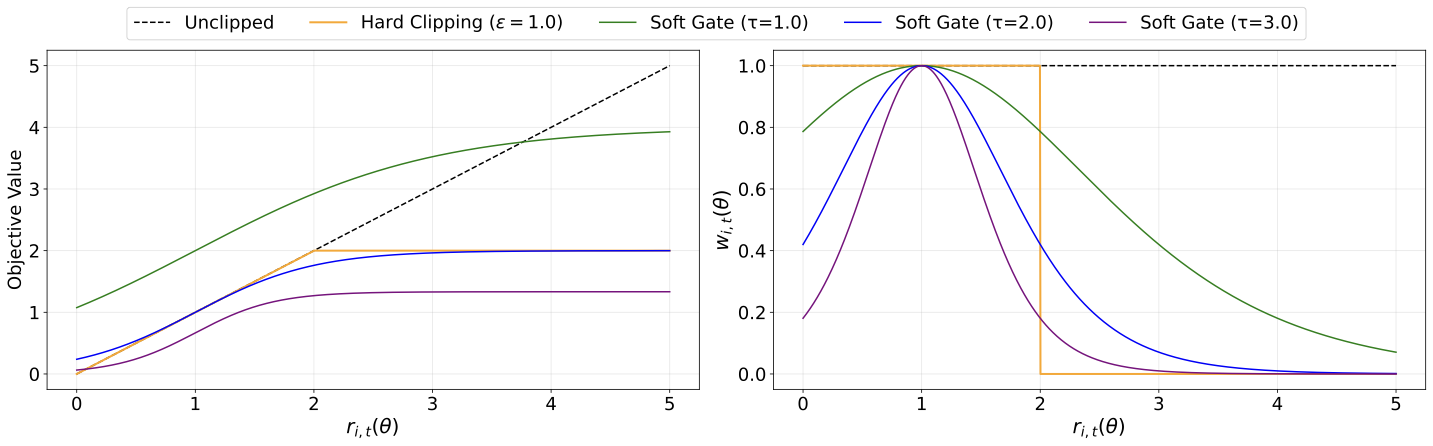
图中的右半部分给出 soft trust region 的直观形状:
- 当 \(r=1\) 时,\(p=1/2\),因此 \(w=1\)。任何温度都不会削弱 on-policy 点的梯度。
- 当 \(r\) 偏离 1 时,\(w\) 连续衰减。有限 \(r\) 下权重不会像 hard clip 那样在边界处跳到 0,但极端偏移时会趋近于 0。
- \(\tau\) 越大,钟形曲线越窄,off-policy 梯度衰减越快;\(\tau\) 越小,允许保留梯度的范围越宽。
「连续信任域」在这里表示一种软权重机制,并不等同于 TRPO 对 KL 距离施加的显式约束,也没有单调策略改进保证。
3. 正负 advantage 为什么使用不同温度
SAPO 取 \(\tau_{\mathrm{neg}}>\tau_{\mathrm{pos}}\)。论文给出的理由来自 token 梯度如何穿过 softmax logits。
令 \(z_v\) 为词表中 token \(v\) 的 logit,当前采样 token 为 \(y_{i,t}\)。对 log-policy objective 求导:
\[ \frac{\partial\left[ \log\pi_\theta(y_{i,t}\mid q,y_{i,<t}) \widehat{A}_{i,t} \right]}{\partial z_v} = \begin{cases} \left(1-\pi_\theta(y_{i,t}\mid q,y_{i,<t})\right) \widehat{A}_{i,t}, & v=y_{i,t},\\ -\pi_\theta(v\mid q,y_{i,<t})\widehat{A}_{i,t}, & v\ne y_{i,t}. \end{cases} \]
当 \(\widehat{A}>0\) 时,梯度上升会提高采样 token 的 logit,并压低未采样 token。负 advantage 的方向相反:采样 token 被压低,词表中大量未采样 token 的 logit 都会得到正向变化。语言模型的词表通常有数十万 token,而某个状态下真正合理的动作只占很小一部分,因此负向更新更容易把梯度扩散到无关 token。
增大 \(\tau_{\mathrm{neg}}\) 会缩窄负样本的 soft trust region,使它们在偏离 on-policy 点后更快衰减。论文的受控实验采用
\[ \tau_{\mathrm{pos}}=1.0, \qquad \tau_{\mathrm{neg}}=1.05. \]
差值只有 0.05。稳定性改善并不依赖一个非常激进的非对称设置。
4. 从 token gate 到序列级软信任域
SAPO 论文比「GRPO 换成 soft clip」多做了一层论证:在常见的小步更新条件下,token gate 的平均可以近似为 sequence-level gate。
定义 token log-ratio、序列均值和序列内方差:
\[ z_{i,t}(\theta)=\log r_{i,t}(\theta), \qquad \mu_i(\theta) = \frac{1}{|y_i|}\sum_t z_{i,t}(\theta) = \log s_i(\theta), \]
\[ \operatorname{Var}_i(\theta) = \frac{1}{|y_i|} \sum_t\left(z_{i,t}(\theta)-\mu_i(\theta)\right)^2. \]
推导依赖两个假设:更新步长较小,使 \(r_{i,t}\approx1\) 且 \(r_{i,t}-1\approx\log r_{i,t}\);同一序列内的 token log-ratio 方差较小。此时
\[ w_{i,t}(\theta) \approx g_{\tau_i}\!\left(z_{i,t}(\theta)\right), \qquad g_\tau(z) = \operatorname{sech}^{2}\!\left(\frac{\tau}{2}z\right). \]
对 \(g_\tau\) 在 \(\mu_i=\log s_i\) 附近做二阶 Taylor 展开并在 token 维度求平均,一阶项会抵消,近似误差满足
\[ \left| \frac{1}{|y_i|}\sum_t g_{\tau_i}(z_{i,t}) - g_{\tau_i}(\log s_i) \right| \le \frac{\tau_i^2}{4} \operatorname{Var}_i(\theta). \]
因此,在低方差序列上,SAPO 的平均 token gate 接近
\[ g_{\tau_i}(\log s_i) = \operatorname{sech}^{2}\!\left( \frac{\tau_i}{2}\log s_i \right), \]
形式上类似 GSPO 的序列级更新,只是把 hard band 换成了连续 gate。序列中若出现少数 outlier,低方差假设不再成立;这时 SAPO 回到 token 级处理,只压低异常 token,而不是丢弃整条序列。这正是论文所谓 sequence-coherent 与 token-adaptive 的含义。
5. 受控实验与温度消融
5.1 SAPO、GSPO 与 GRPO-R2
论文从 Qwen3-30B-A3B-Base 的 cold-start checkpoint 出发,在数学推理 query 上继续 RL。验证指标是 AIME25、HMMT25 和 BeyondAIME 的平均 Pass@1,每道题采样 16 次;每批 rollout 被分成四个 mini-batch 更新。GRPO-R2 指加入 routing replay 的 GRPO,用来缓解 MoE 路由在 rollout 与训练之间不一致的问题。
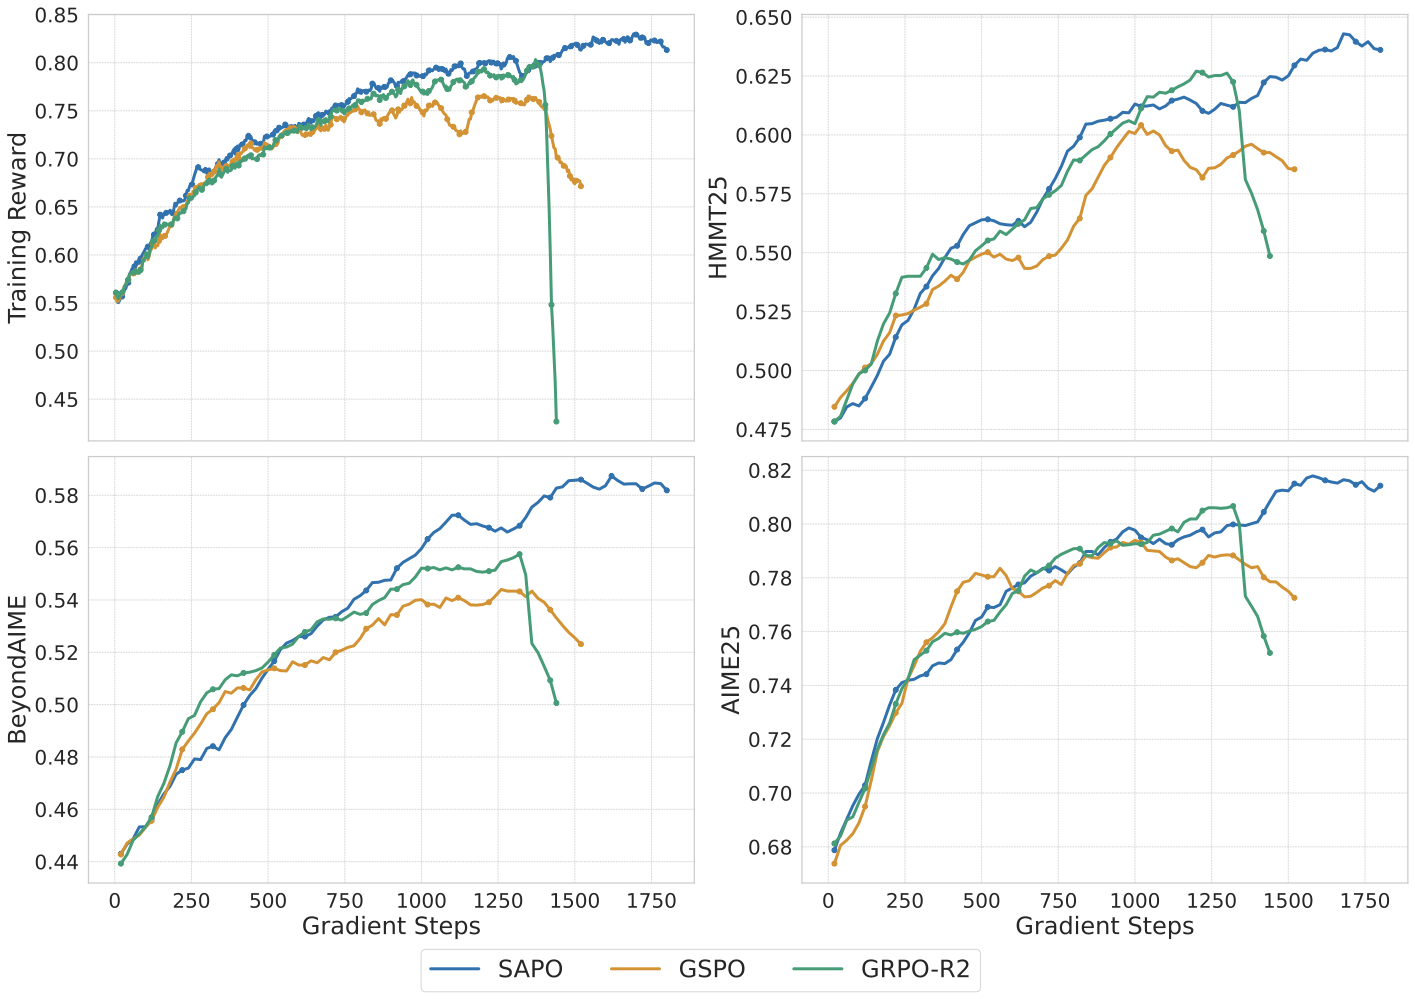
蓝色 SAPO 曲线训练到约 1800 step,training reward 和三个验证集的平均表现仍保持上升;GSPO 与 GRPO-R2 在约 1400 至 1500 step 附近出现明显回落。该图支持「SAPO 在这组预算和配置下延长了稳定训练区间」,但不应扩展成算法无条件稳定:论文摘要也承认不同方法最终都可能失稳。
图中没有重复试验的方差或置信区间,主要证据是一组训练轨迹。它能说明 failure mode 的出现时间和曲线形态,不能单独估计不同随机种子下的稳定性概率。
5.2 非对称温度消融
温度实验固定 \(\tau_{\mathrm{pos}}=1.0\),比较 \(\tau_{\mathrm{neg}}=1.05\)、\(1.0\) 和 \(0.95\)。
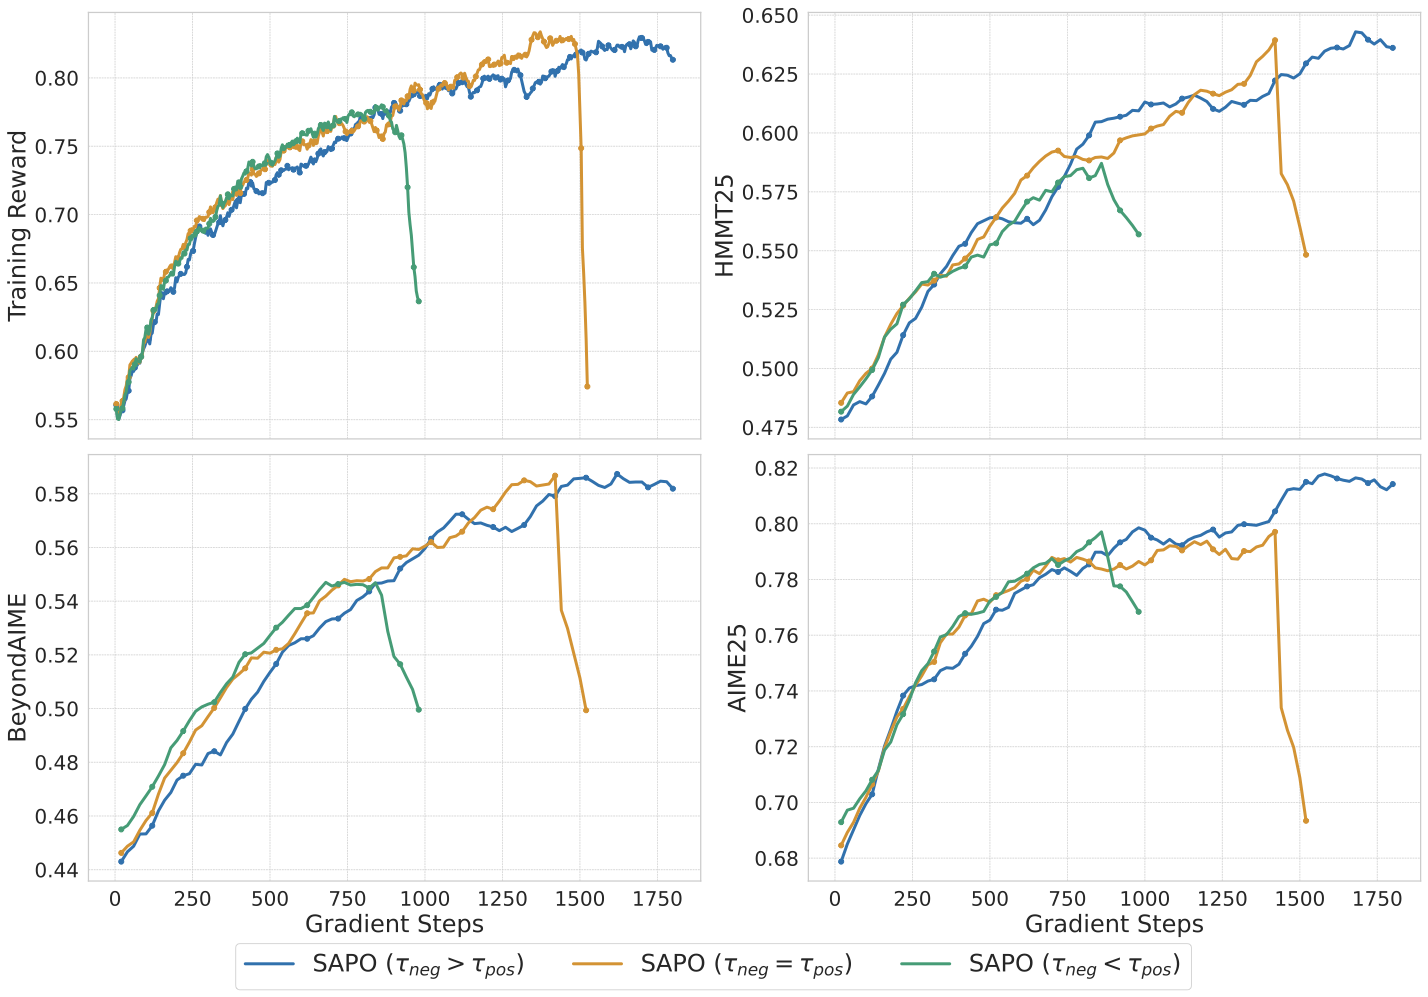
\(\tau_{\mathrm{neg}}=0.95<\tau_{\mathrm{pos}}\) 的绿色曲线最早失稳;相同温度的橙色曲线训练更久,但在约 1500 step 后明显坍塌;\(\tau_{\mathrm{neg}}=1.05\) 的蓝色曲线保持到实验末段。这个顺序与 logit 梯度分析一致:负 token 的 gate 越宽,高方差负向更新越容易积累。
6. SAPO 在 Qwen3-VL 训练中的位置
SAPO 论文还从 Qwen3-VL-30B-A3B 的 preliminary cold-start checkpoint 出发,在相同计算预算下比较 SAPO、GSPO 与 GRPO-R2。训练混合数学、代码、逻辑推理及多模态任务,每个 batch 固定各任务采样比例,并把 rollout 分成两个 mini-batch 更新。验证分数聚合了 AIME25(32 次采样的 Pass@1)、LiveCodeBench v6(8 次采样的 Pass@1)、ZebraLogic 和 MathVision。
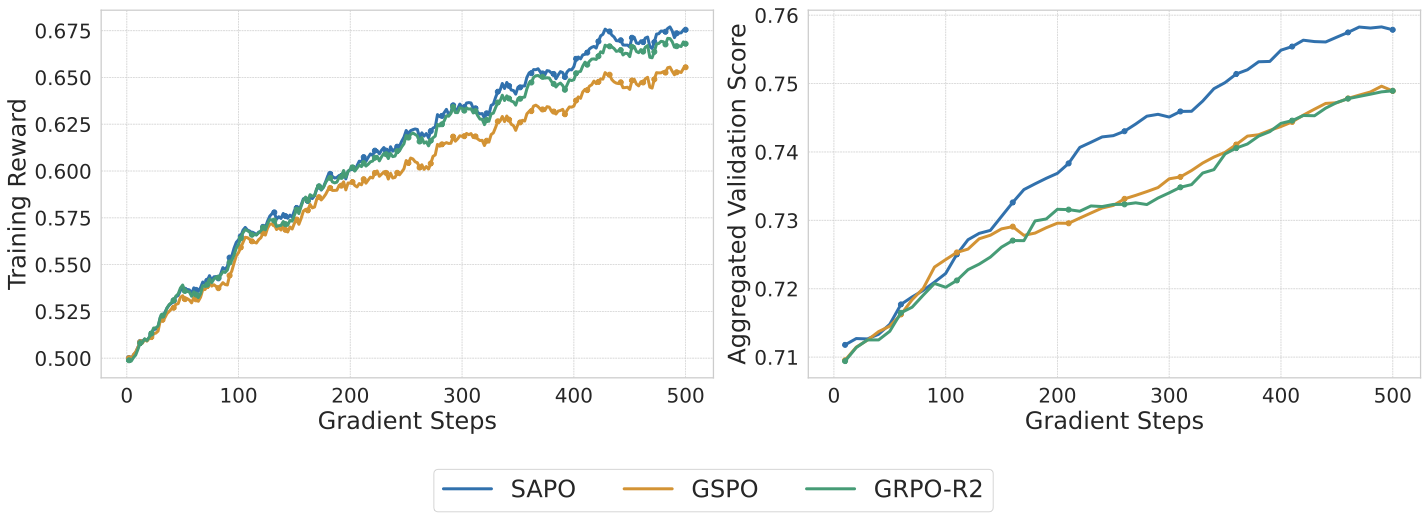
500 个 gradient step 内,三种方法的 training reward 都在上升,SAPO 的聚合验证分数在约 150 step 后逐渐拉开差距。这里没有出现受控数学实验中的剧烈 collapse,因此该图更适合支持「同等短预算下的验证性能差异」,而不是再次证明 SAPO 避免了训练坍塌。
Qwen3-VL Technical Report 把后训练 RL 分为两部分:
- Reasoning RL 覆盖数学、代码、逻辑推理、视觉定位和视觉谜题。训练集约含 30K query,每个 query 采样 16 个回答,并过滤通过率超过 90% 的简单问题;reward 来自规则或代码执行器。报告在该小节明确写明使用 SAPO。
- General RL 覆盖 VQA、image captioning、OCR、文档解析、grounding 和时钟识别。reward 同时包含规则项与 model-based judge;后者使用 Qwen2.5-VL-72B-Instruct 或 Qwen3,并参照 ground-truth answer 评分。
需要保留一个文献边界:技术报告在 Reasoning RL 的「RL Algorithm」段落点名 SAPO,General RL 小节没有再次说明 optimizer。SAPO 论文确实报告了跨文本和多模态任务的混合训练,但仅凭技术报告的章节位置,不能进一步断言 General RL 中每一种任务都由完全相同的 SAPO 配置更新。
7. 三种 group-based 优化方法的差异
| 维度 | GRPO | GSPO | SAPO |
|---|---|---|---|
| 约束粒度 | token | sequence | token;低方差、小步更新时近似 sequence gate |
| 策略比率 | \(r_{i,t}\) | 几何平均 \(s_i\) | \(r_{i,t}\),并分析其与 \(s_i\) 的联系 |
| Gate | 固定边界 hard clip | 固定边界 hard clip | 温度控制的 sigmoid soft gate |
| 越界梯度 | 危险方向上直接变为 0 | 整条序列在危险方向上变为 0 | 按偏离程度连续衰减 |
| Outlier token | 只截断该 token | 可能连带抑制整条序列 | 选择性降低 outlier 权重 |
| 正负样本控制 | 相同 \(\varepsilon\),截断方向由 advantage 决定 | 相同 \(\varepsilon\),截断方向由 advantage 决定 | \(\tau_{\mathrm{neg}}>\tau_{\mathrm{pos}}\) |
8. 方法边界与复现关注点
我对 SAPO 的判断是:改动小,但命中了 hard clipping 的一个真实失效模式。它没有引入新的 Critic、reward model 或额外 rollout;在现有 group-based pipeline 中,主要变化是代理函数和两个温度参数。这使它具备较低的工程接入成本。
结论仍有四个边界。
第一,「adaptive」指 gate 会随策略比率和 advantage 符号改变,不表示温度由数据在线学习。论文实验中的 \(\tau_{\mathrm{pos}}\) 与 \(\tau_{\mathrm{neg}}\) 仍是固定超参数。
第二,soft gate 保留中等偏移样本的梯度,不表示所有 off-policy 样本都值得学习。\(r\) 极端偏离 1 时,\(w\) 仍会趋近于 0;数值实现中还可能直接下溢。
第三,sequence-level 解释依赖 \(r\approx1\) 和较小的序列内 log-ratio 方差。MoE 路由变化、长回答或多次 mini-batch 更新都可能破坏这些条件,此时应把 SAPO 理解为 token-adaptive 方法,而不是严格的 sequence-level optimizer。
第四,主要稳定性证据来自 Qwen3-30B-A3B-Base 的数学 RL 轨迹,图中未报告多随机种子统计。复现时至少应同时记录 clipped-token fraction、ratio 分布、序列内 log-ratio variance、policy entropy 和各 benchmark 曲线;只看 training reward,很容易把 reward 上升误判为策略仍在健康学习。
9. 总结
SAPO 的关键不在 sigmoid 本身,而在它把策略偏移映射为连续梯度权重:\(r=1\) 时完整保留 policy gradient,中等偏移时逐步衰减,极端偏移时才接近 0。\(\tau_{\mathrm{neg}}>\tau_{\mathrm{pos}}\) 又针对大词表中的负向梯度扩散缩窄了有效更新区间。
与 GRPO 相比,它减少了固定 clip 边界造成的梯度浪费;与 GSPO 相比,它不会因少数 outlier token 直接牺牲整条序列。在论文给定的 Qwen3-30B-A3B 和 Qwen3-VL-30B-A3B 设置下,这个修改延长了稳定训练区间,并在相同预算下获得更高验证分数。更强的结论仍需要多随机种子、更多模型规模和公开训练配置支持。
10. 参考文献
- Gao, C., Zheng, C., Chen, X.-H., et al. Soft Adaptive Policy Optimization. 2025.
- Bai, S., Cai, Y., Chen, R., et al. Qwen3-VL Technical Report. 2025.
- Shao, Z., Wang, P., Zhu, Q., et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024.
- Zheng, C., Liu, S., Li, M., et al. Group Sequence Policy Optimization. 2025.