在 DPO 中保留一条 SFT 梯度:从相对偏好到 chosen likelihood 锚定
摘要
本文分析 BrenchCC/DPO_Trainer_with_SFT_Loss 在标准 DPO loss 上叠加 chosen-response SFT loss 的实现。核心问题很具体:DPO 只要求 chosen 与 rejected 的 reference-adjusted margin 增大,并不保证 chosen response 的绝对 log probability 上升;如果 preference 数据中的 chosen 确实值得模仿,那么额外的 response-only NLL 可以提供一条绝对锚定梯度。
这条梯度有合理动机,也有清楚的边界。DPO-Positive、Iterative Reasoning Preference Optimization、Regularized Preference Optimization 与 likelihood displacement 的实验都说明「偏好差值变大」和「chosen likelihood 上升」并非同一件事;但这些工作并没有证明在任意数据上加入 SFT 都会改善生成质量。chosen 若只是「两者中相对较好」而非可靠示范,NLL 会把其中的事实错误、格式偏差和冗长风格一并学进去。
我的判断是:sft_loss_weight 应被当作一个可证伪的工程假设,而不是 DPO 的默认补丁。仓库目前已实现这项假设所需的主要计算路径;真正缺少的是受控消融、绝对 likelihood 诊断与 held-out generation 评测。
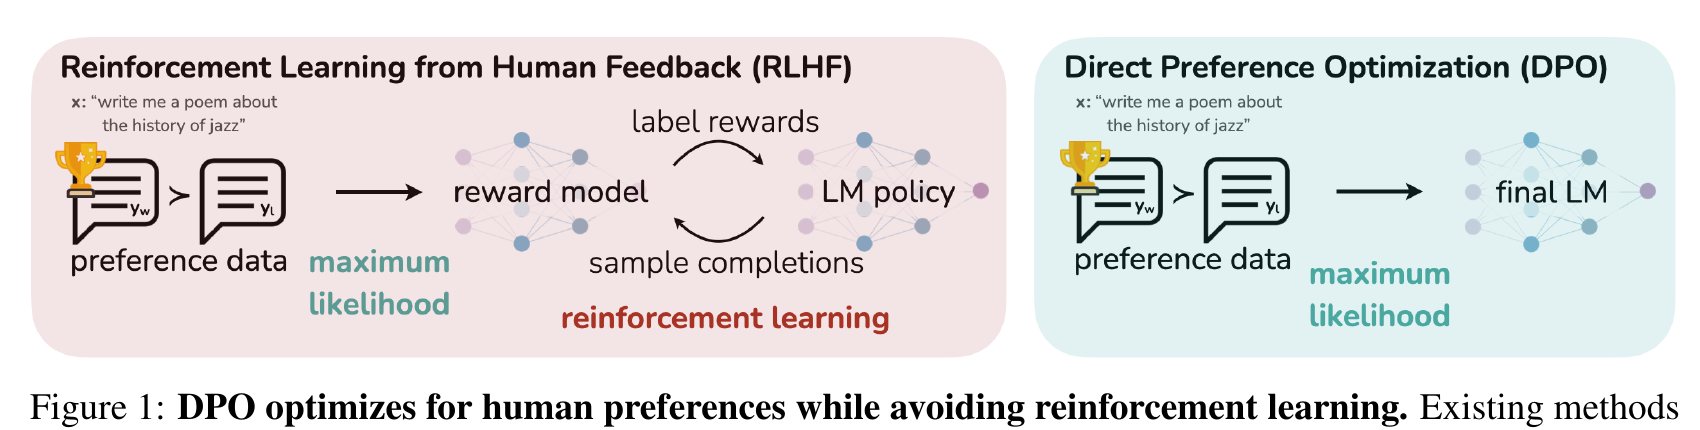
图 1:DPO 省去了显式 reward model 与在线 RL,但其二分类式目标仍然是相对偏好目标。来源:Rafailov et al., 2023, Figure 1。
1. 分析对象与证据边界
本文以仓库提交 948f3da 为代码基线。该项目是一个基于 Hugging Face Trainer 的轻量实现,支持标准 SFT、标准 sigmoid DPO、chosen-response SFT 正则、LoRA 与可选 QLoRA。它不是一个已经给出完整 benchmark 的新算法仓库。
为了避免把不同层级的证据混在一起,本文区分三类陈述:
- 代码事实:可以从当前提交直接核对,例如 chosen logits 是否复用、prompt 是否共享、labels 覆盖哪些 token。
- 论文证据:相关工作在特定模型、数据与评测下观察到 chosen likelihood 下降、长度偏差或安全行为漂移。
- 项目假设:在该仓库的数据与训练设置中加入 SFT 是否有效。没有消融结果之前,这一层只能写成待验证判断。
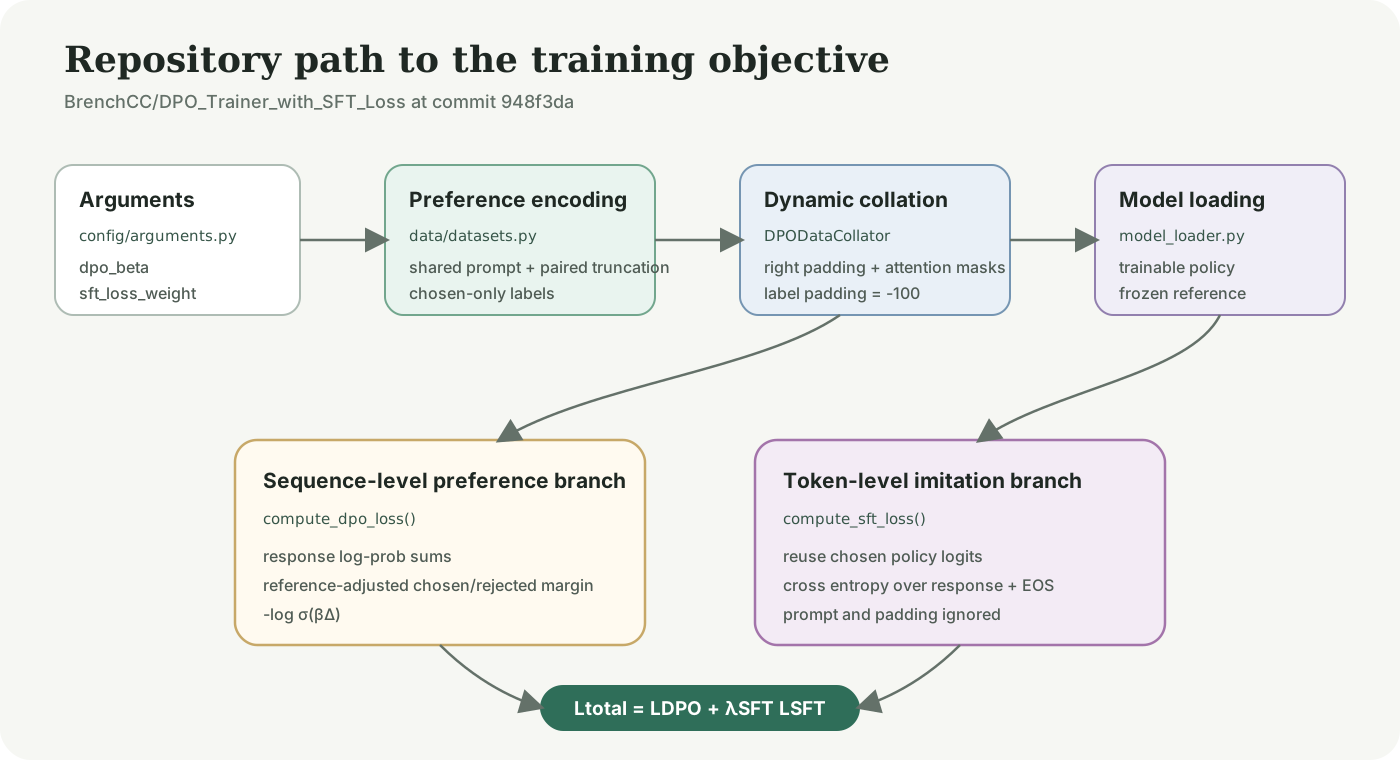
图 2:仓库的实现路径。参数进入数据编码与模型加载,DPOTrainer 再计算 sequence-level DPO 与 token-level SFT。
当前代码已经通过 13 项离线单元测试覆盖数据格式、截断、collator、loss 可微与一步训练流程。这些测试能回答「实现是否按预期连接」,不能回答「生成质量是否改善」。二者不能互相替代。
2. 标准 DPO 只约束相对差值
设 prompt 为 \(x\),chosen response 为 \(y^+\),rejected response 为 \(y^-\)。策略模型和 reference model 分别记为 \(\pi_\theta\) 与 \(\pi_{\mathrm{ref}}\)。response 的序列 log probability 是条件 token log probability 之和:
\[ \log \pi_\theta(y\mid x) = \sum_{t=1}^{|y|} \log \pi_\theta(y_t\mid x,y_{\lt t}) \]
定义 reference-adjusted score:
\[ s_\theta(x,y) = \log \pi_\theta(y\mid x) - \log \pi_{\mathrm{ref}}(y\mid x) \]
仓库实现的 sigmoid DPO margin 与 loss 为:
\[ \Delta_\theta = s_\theta(x,y^+)-s_\theta(x,y^-) \]
\[ \mathcal{L}_{\mathrm{DPO}} = -\log \sigma(\beta\Delta_\theta) \]
这与 DPO 原论文从 KL-regularized RLHF 推出的二分类目标一致。1 代码对应位置是 compute_dpo_loss()。
问题出在 \(\Delta_\theta\) 只看差值。假设 chosen score 从 \(-1\) 变为 \(-2\),rejected score 从 \(-2\) 变为 \(-5\),margin 仍从 \(1\) 增加到 \(3\)。DPO loss 会下降,尽管 chosen score 也下降了。对 ranking 目标而言,这没有矛盾;只有当 chosen 被视为高质量示范时,绝对 likelihood 下降才成为工程问题。
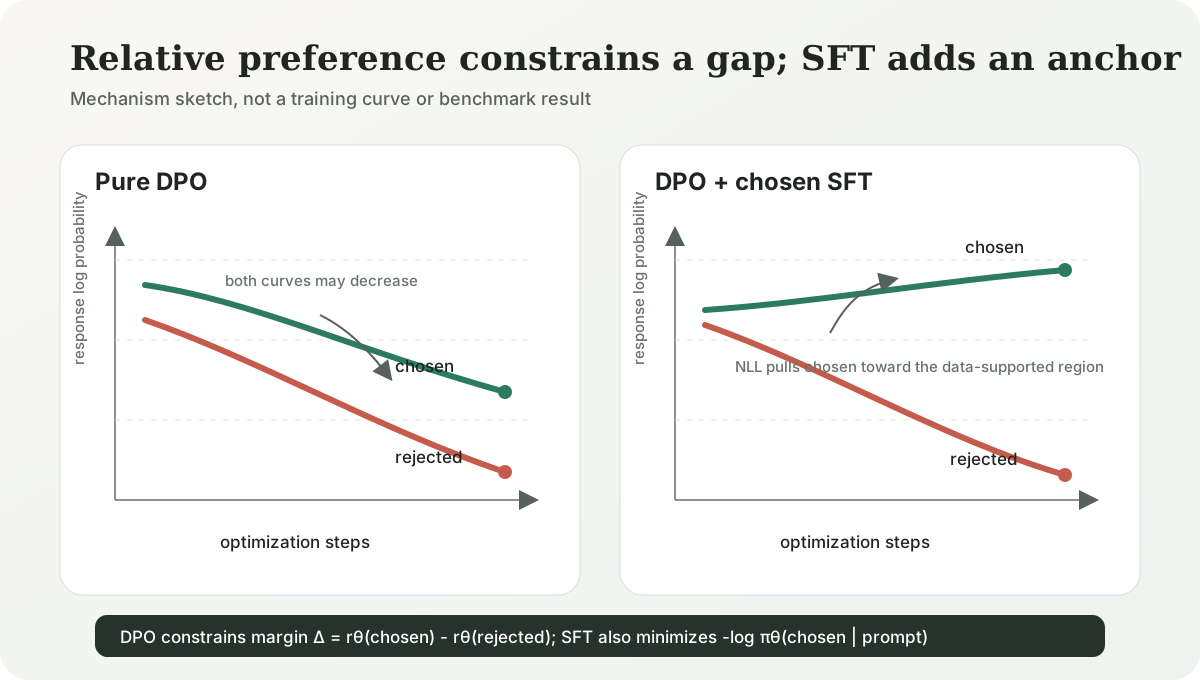
图 3:机制示意,不是训练曲线。\(\beta\) 缩放 pairwise margin,不能单独约束 chosen likelihood。
2.1 Likelihood displacement 把问题扩展到了 pair 之外
chosen 与 rejected 同时下降时,概率质量必然流向 preference pair 之外的 response。Razin 等人把这一现象称为 likelihood displacement,并进一步区分了两种情况:若概率转移到与 chosen 同样可取的 response,转移可能无害;若转移到语义相反或更不安全的 response,结果会破坏对齐目标。2
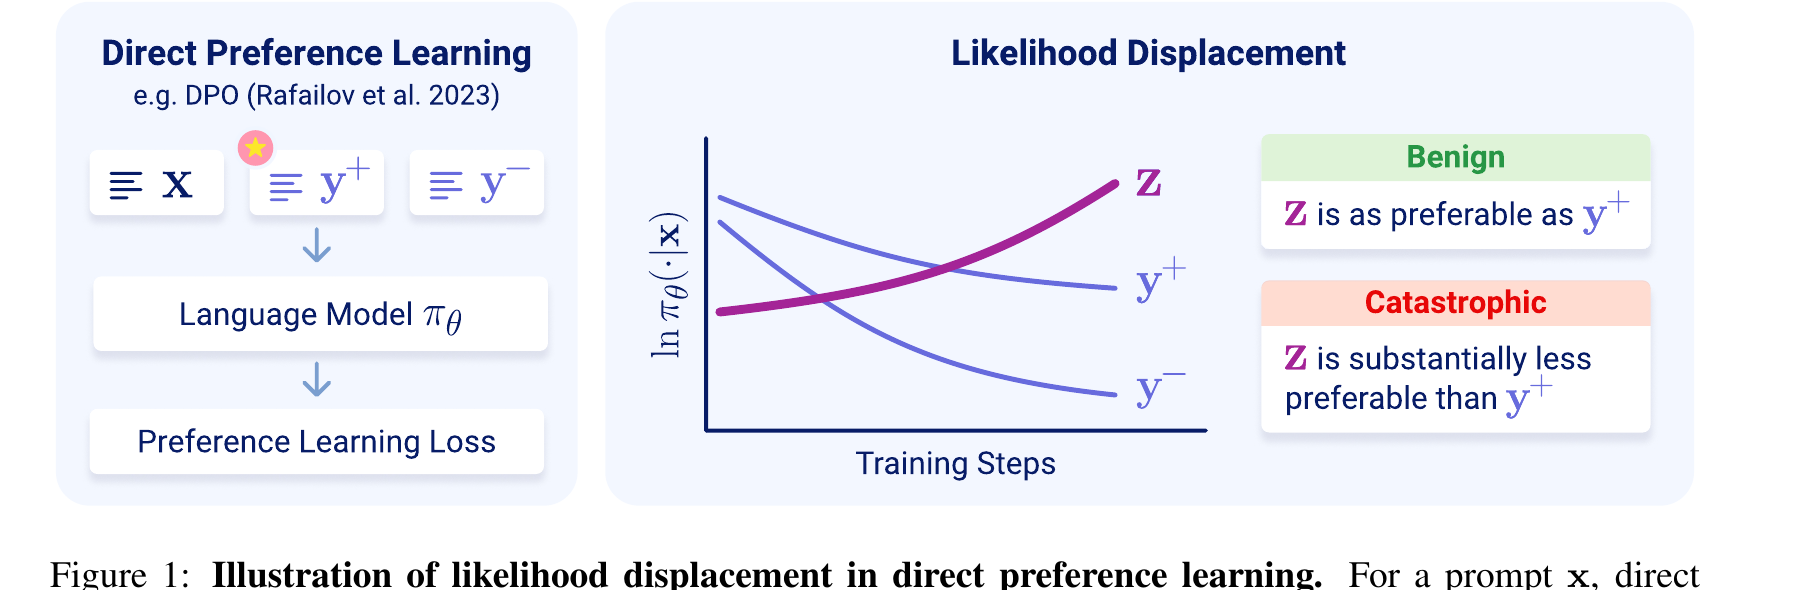
图 4:Likelihood displacement 不只讨论 pair 内 margin,还追踪 pair 外输出吸收了多少概率质量。来源:Razin et al., 2024, Figure 1。
这个区分很重要。监控 dpo_accuracy 或 preference margin 无法知道概率流向何处;即使 chosen 对 rejected 的优势持续扩大,固定 prompt 上的真实生成仍可能恶化。
3. 联合目标:SFT 改变的是梯度方向
chosen-response SFT 只监督 chosen response token 与 EOS,不计算 prompt 和 padding:
\[ \mathcal{L}_{\mathrm{SFT}} = -\frac{1}{T_+} \sum_{t=1}^{T_+} \log \pi_\theta(y_t^+\mid x,y_{\lt t}^+) \]
联合目标为:
\[ \mathcal{L}_{\mathrm{total}} = \mathcal{L}_{\mathrm{DPO}} + \lambda_{\mathrm{SFT}}\mathcal{L}_{\mathrm{SFT}} \]
两项对 chosen 的作用并不重复:
\[ \nabla_\theta \mathcal{L}_{\mathrm{total}} = \nabla_\theta \mathcal{L}_{\mathrm{DPO}} + \lambda_{\mathrm{SFT}} \nabla_\theta \mathcal{L}_{\mathrm{SFT}} \]
DPO 梯度取决于 chosen/rejected 的差值;SFT 梯度直接提高数据中 chosen token 的条件概率。dpo_beta = 0.1 与 sft_loss_weight = 0.1 即使数值相同,也不代表二者同量纲或同强度。前者进入 sigmoid 前的 margin,后者直接乘在 token-mean cross entropy 上。
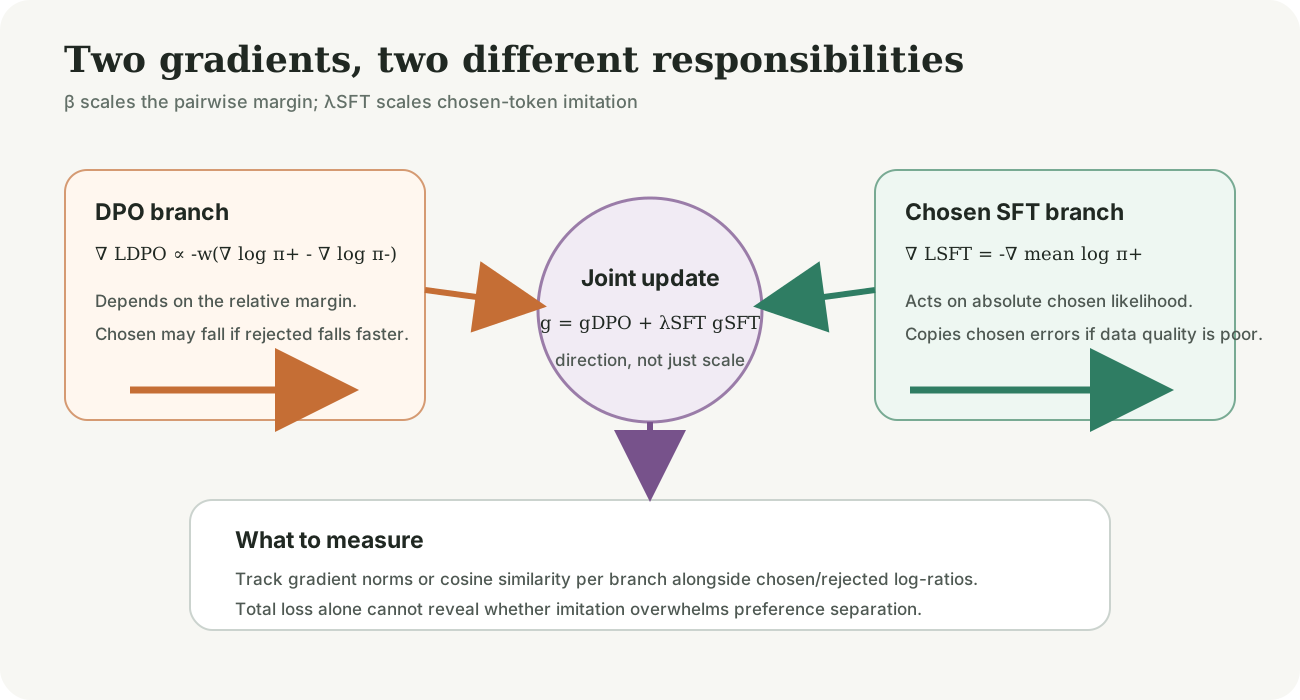
图 5:联合目标改变梯度方向。若要理解两条分支谁在主导更新,应记录 branch gradient norm 或 cosine,而不是只看 total loss。
3.1 RPO 给出正则化解释,但不等同于本项目完成了理论复现
Regularized Preference Optimization 从离线 RLHF 的 distribution shift 与 reward overoptimization 出发,将 preference optimization loss 和 baseline-policy imitation 写入同一目标。baseline 分布若取 preference 数据中的 chosen response,imitation 项就对应 chosen NLL。3
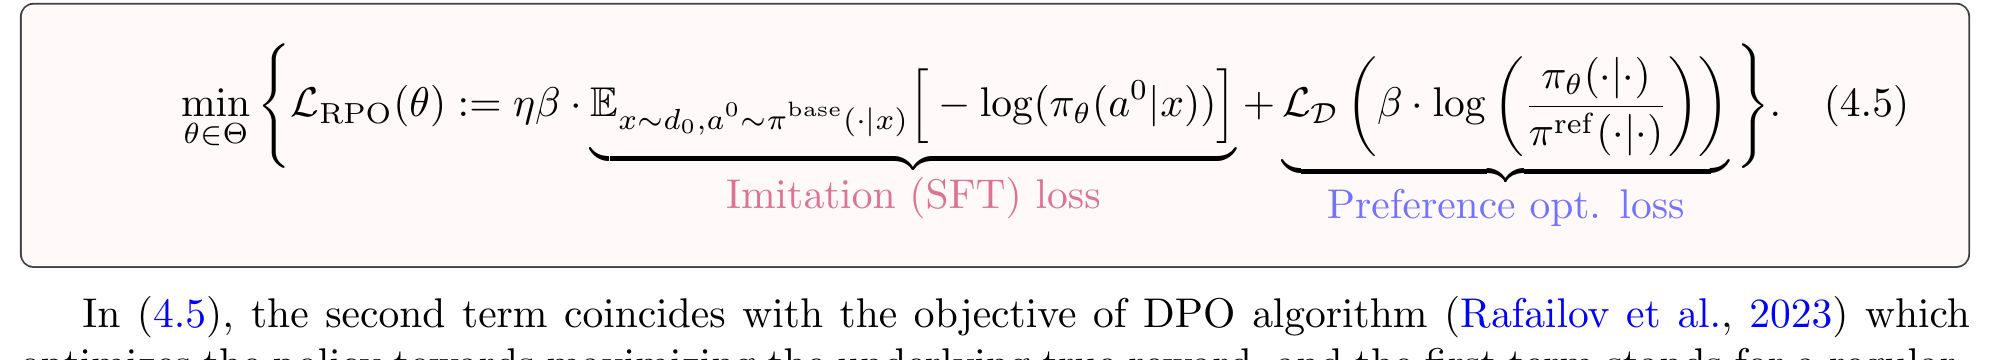
图 6:RPO 的实用目标把 imitation loss 解释成显式正则。来源:Liu et al., 2024, Equation 4.5。本项目目标结构相近,但没有复现该论文的理论条件与实验协议。
这层限定不能省。RPO 的结论依赖其 maximin 推导、baseline distribution 与数据覆盖假设;把一个相似公式写进 Trainer,不等于自动继承论文保证。
3.2 Iterative RPO 提供直接的 DPO+NLL 经验,但场景较窄
Pang 等人的 Iterative Reasoning Preference Optimization 在 winning reasoning response 上加入长度归一化 NLL。其 GSM8K 实验给出一个与本文动机高度相关的观察:chosen-only SFT 会同时抬高 chosen 与 rejected,而 DPO+NLL 可以在抬高 chosen 的同时压低 rejected。4
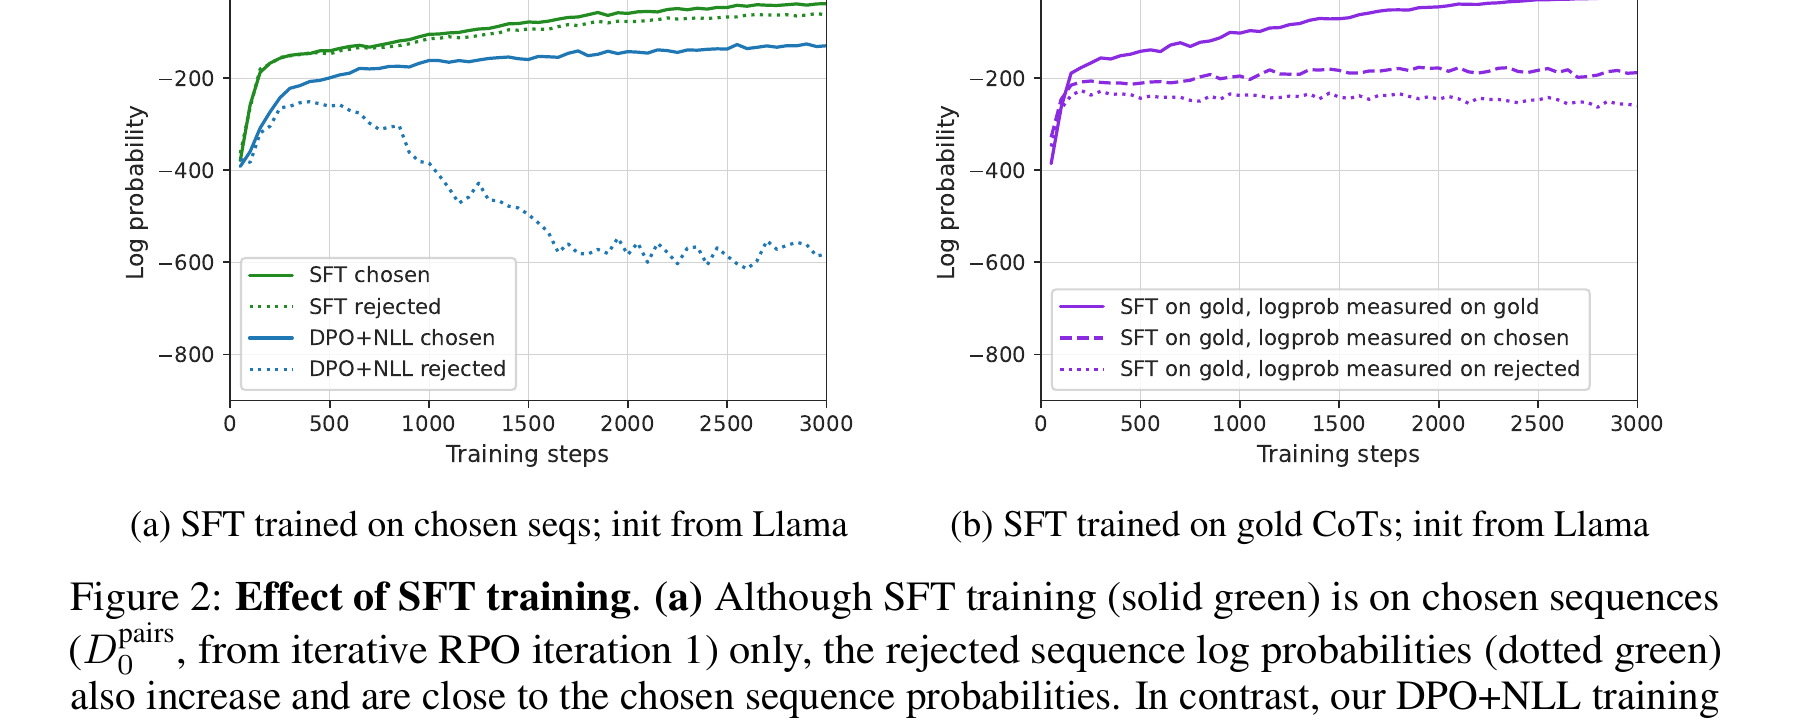
图 7:SFT-only 与 DPO+NLL 的差异。来源:Pang et al., 2024, Figure 2。
同一论文的 NLL 消融更直接:标准 DPO 的 chosen log probability 随训练下降,DPO+NLL 的 chosen 曲线则上升;两者的 chosen/rejected margin 都在扩大。该图说明 margin 与 chosen absolute likelihood 确实需要分开监控。
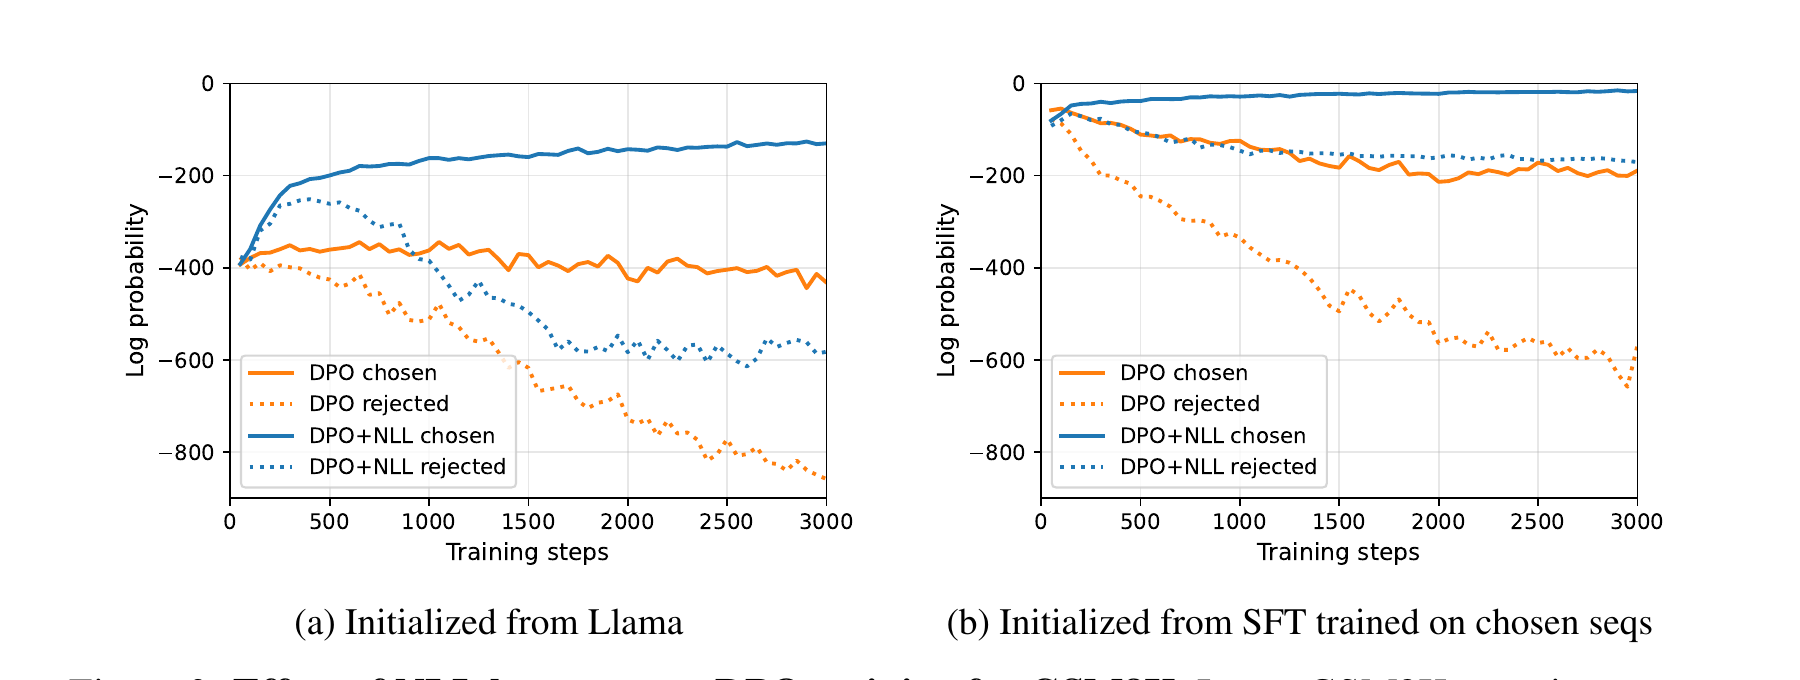
图 8:GSM8K 上的 NLL 消融。来源:Pang et al., 2024, Figure 3。这项结果来自 70B 模型、迭代 CoT 数据与特定解码协议,不能直接外推到通用 instruction preference 数据。
4. 相邻方法:相同动机不等于相同目标
4.1 DPO-Positive 在 reference 下方才触发惩罚
DPO-Positive(DPOP)处理的是 preference pair edit distance 很小时的 token-level 失败模式。标准 DPO 可能只在差异 token 上获得正向信号,却降低其后共享 token 的 likelihood。DPOP 在 chosen 低于 reference 时增加 penalty,形式上不是全程 chosen NLL。5
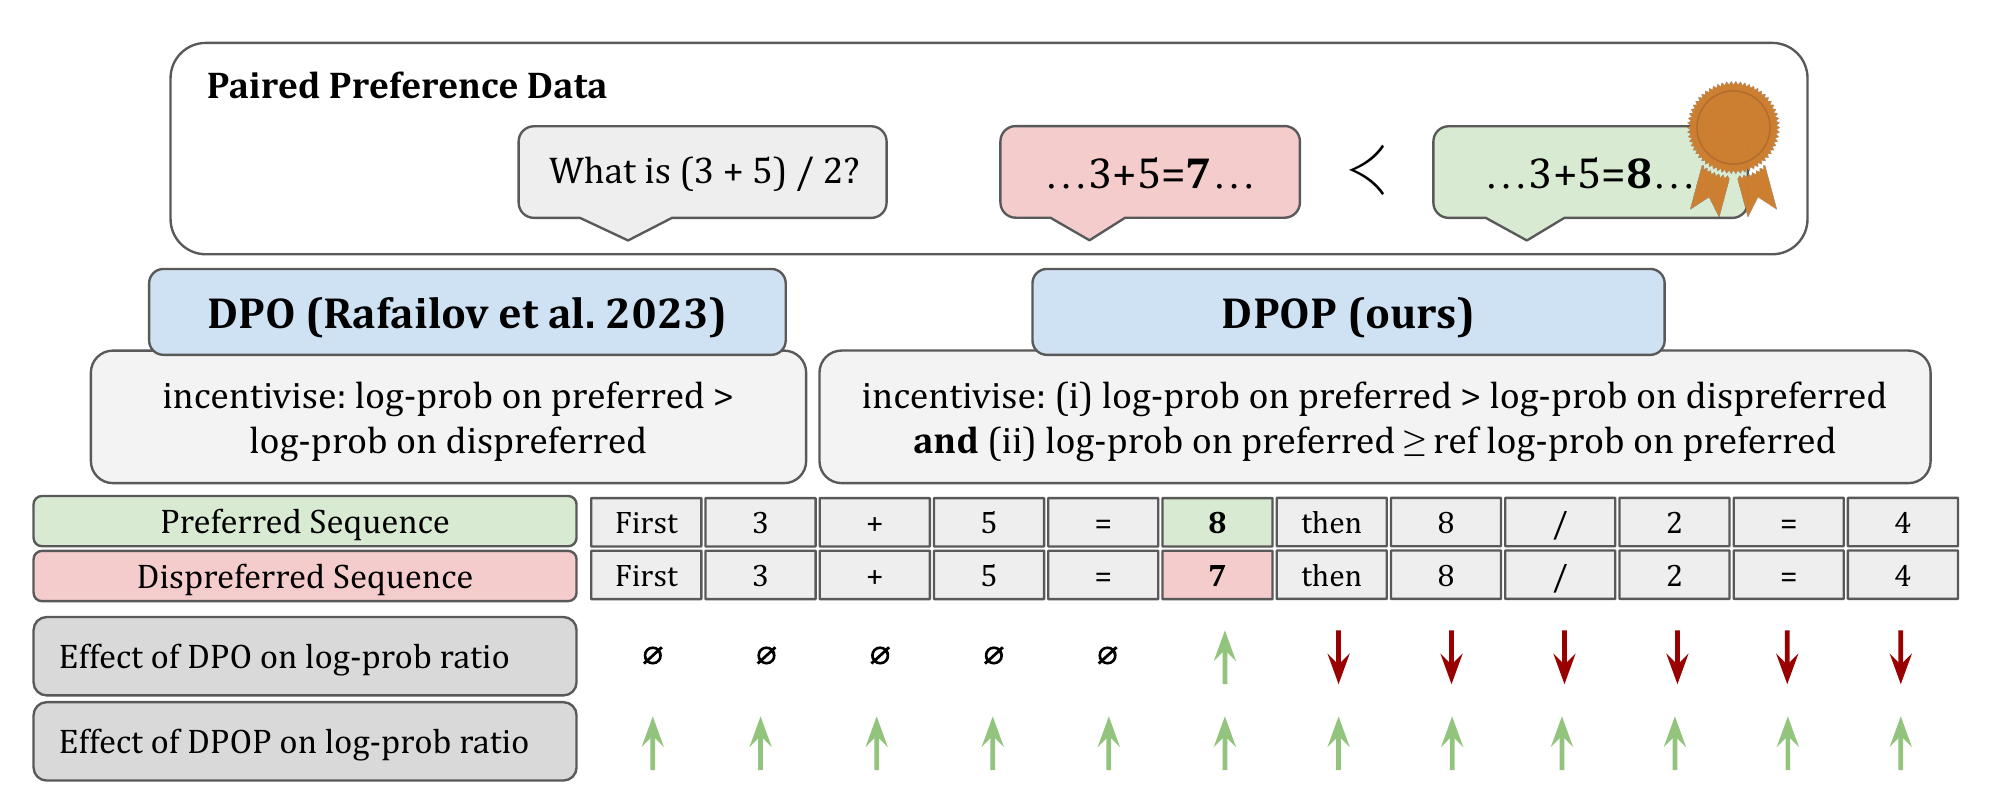
图 9:DPOP 的 penalty 有条件地锚定 chosen,相比持续启用的 SFT loss 更具针对性。来源:Pal et al., 2024, Figure 1。
在 MetaMath 的 900 个 preferred completions 上,DPO 的 average log-prob 随训练下降;DPOP 避免了差异 token 之后的显著下降。该结果支持本文监控绝对 likelihood 的动机,但不能证明固定权重 SFT 是最佳修复。
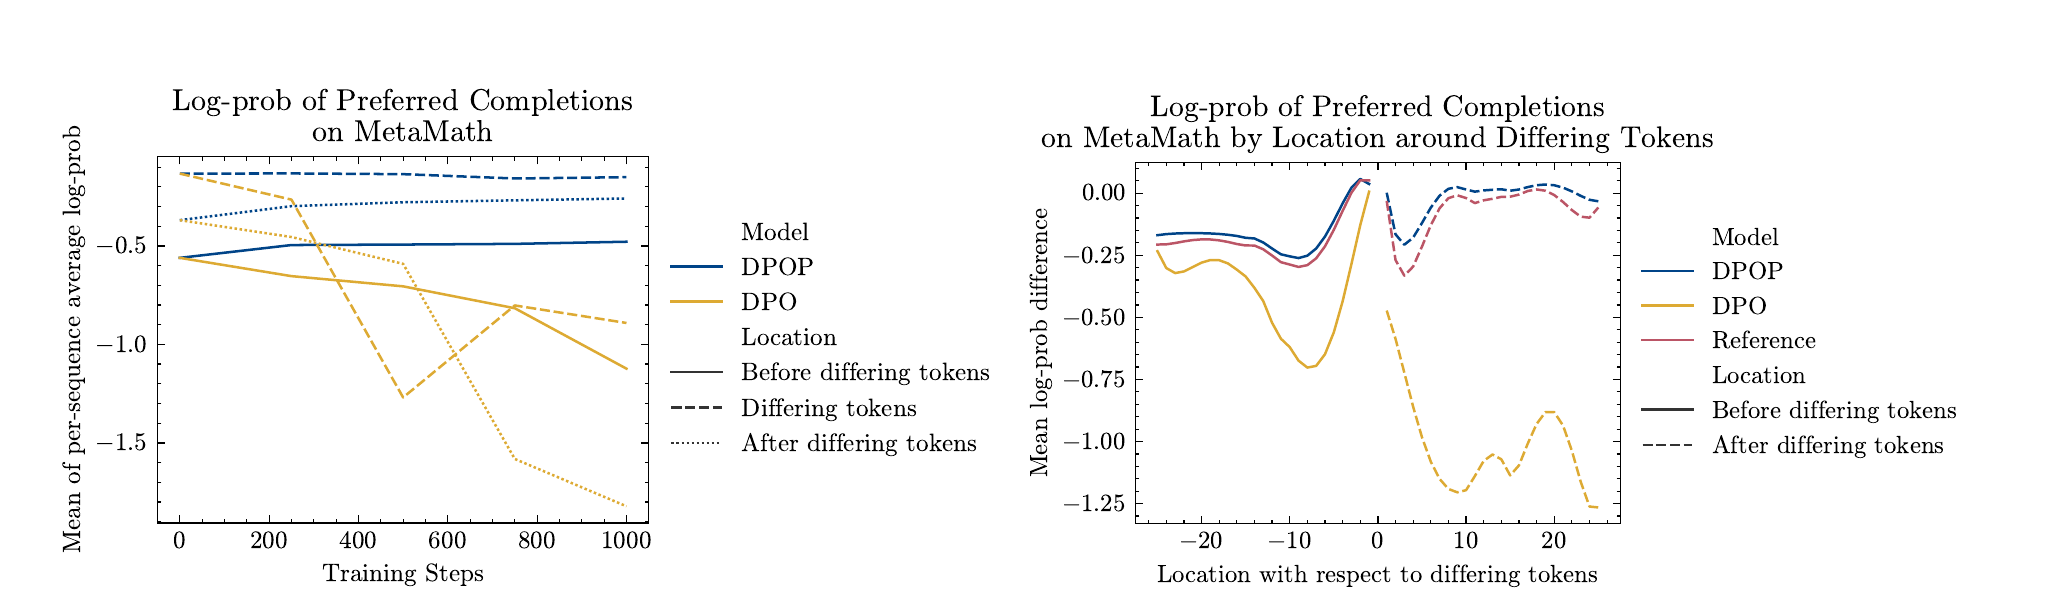
图 10:低 edit-distance pair 上的实证结果。来源:Pal et al., 2024, Figure 4。
4.2 ORPO 是 reference-free 联合目标
ORPO 使用 SFT loss 加 odds-ratio preference loss,不保留 reference model。它和本文都把 imitation 与 preference signal 放进单阶段目标,但计算图和概率比不同。把本项目称为 ORPO 会掩盖 reference model 的显存与前向开销。6
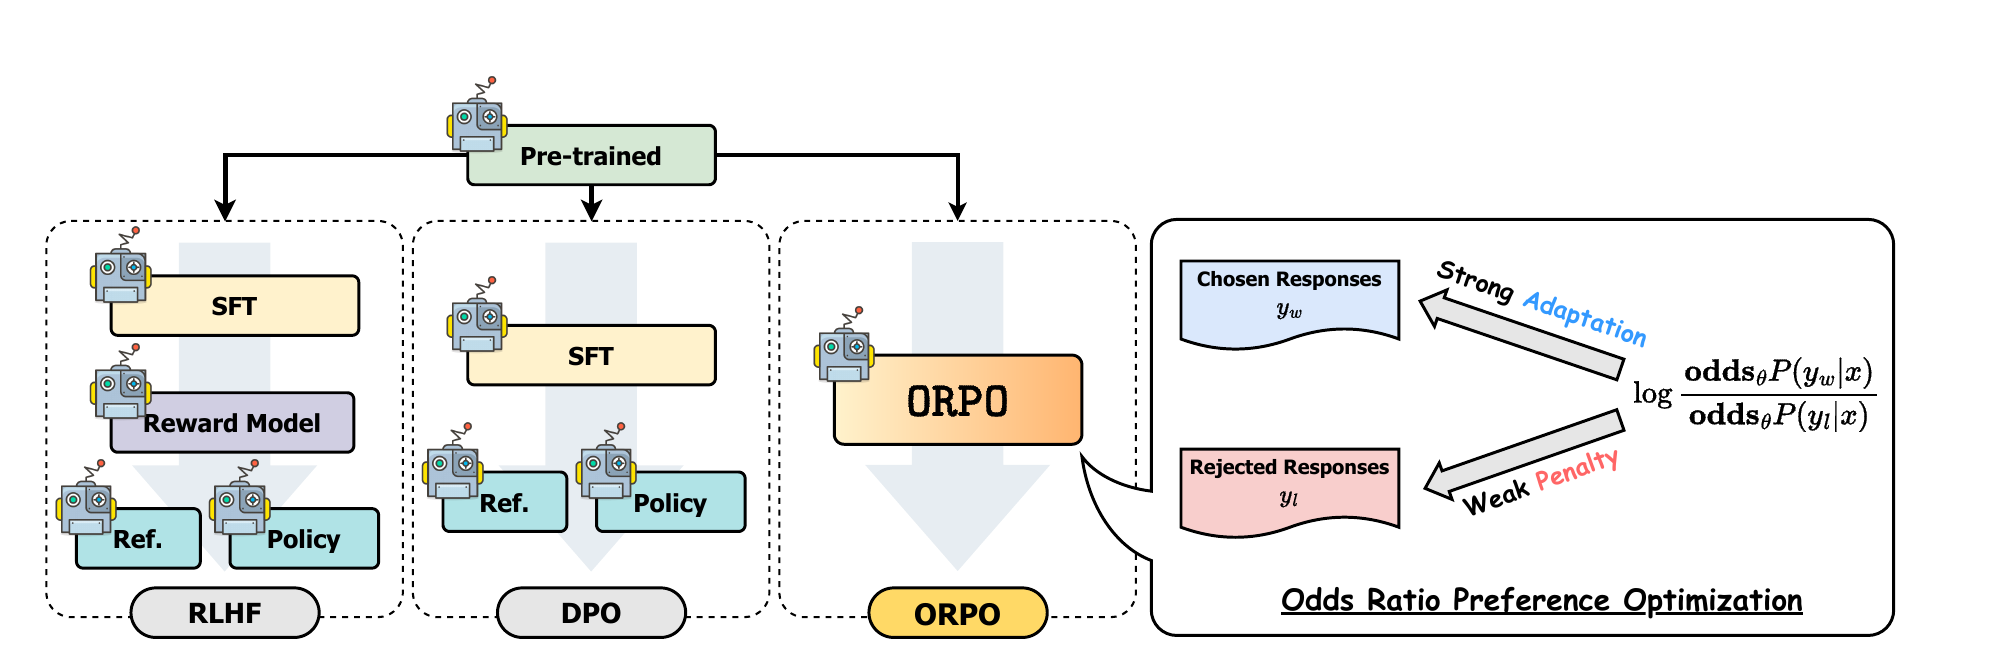
图 11:ORPO 的 reference-free 结构。来源:Hong et al., 2024, Figure 2。
4.3 χPO 提醒我们:SFT 正则不是完备修复
χPO 从 regularization 形式与数据覆盖出发,构造了 DPO+SFT 仍可能失败的例子,并在 TL;DR summarization 上报告 χPO 对训练轮数与 \(\beta\) 更稳健。7 这不是对 chosen NLL 的否定,而是提醒:likelihood 锚定只处理一部分失效机制,不能替代对 preference coverage、函数逼近和过优化的分析。
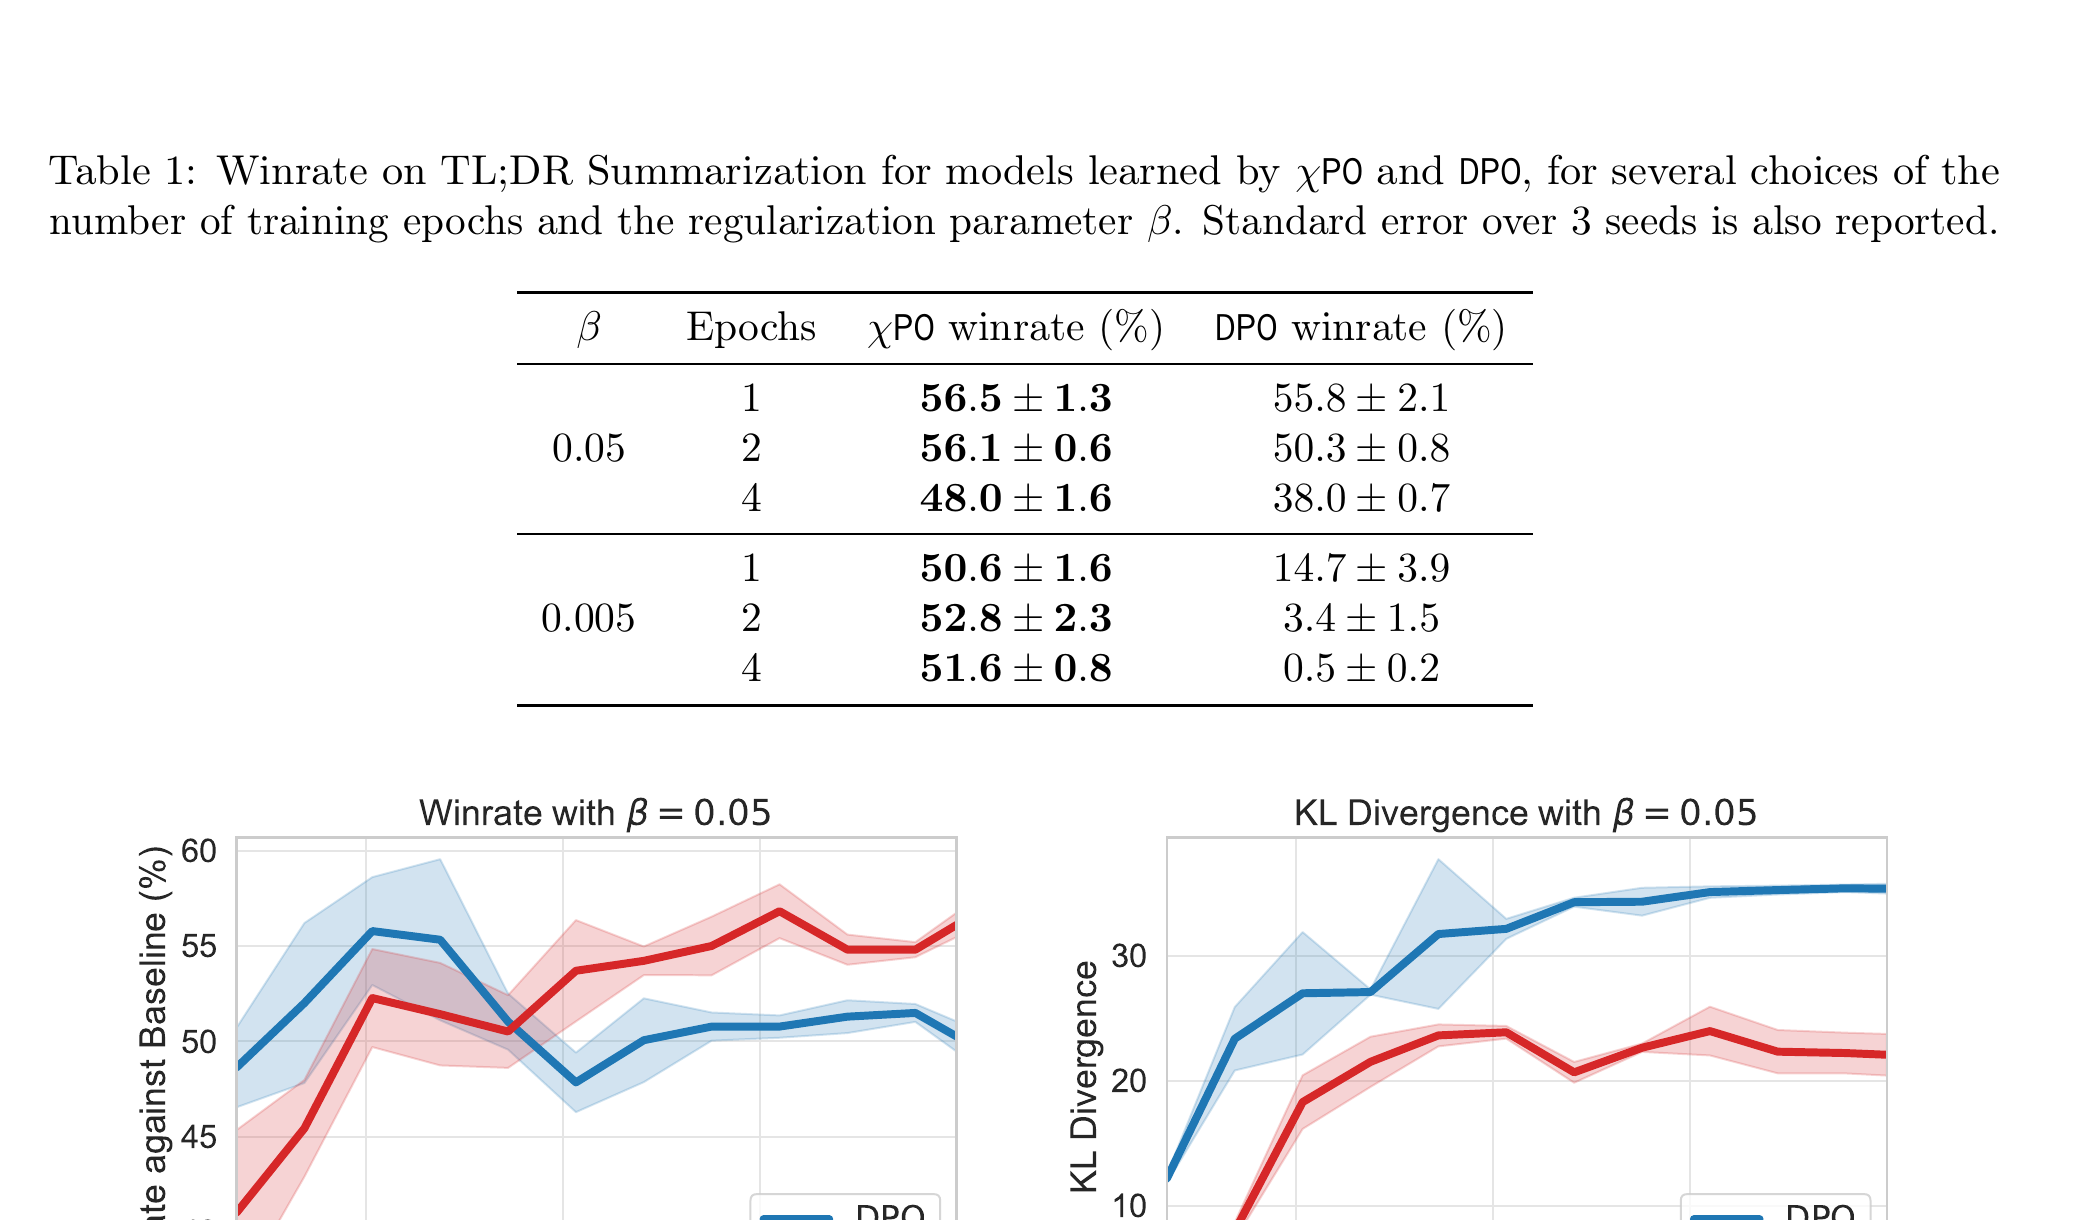
图 12:同一 \(\beta\) 下,DPO 的 KL 与性能可能继续漂移。来源:Huang et al., 2024, Figure 4。
| 方法 | preference 项 | chosen 绝对约束 | reference model | 与本项目的关系 |
|---|---|---|---|---|
| 标准 DPO | reference-adjusted log-ratio | 无 | 需要 | sft_loss_weight = 0 时退化到该目标 |
| 本项目 | sigmoid DPO | response-only SFT | 需要 | 固定权重联合目标 |
| Regularized Preference Optimization | DPO 类目标 | baseline imitation | 需要 | 公式结构最接近,理论条件不同 |
| Iterative RPO | modified DPO | winning reasoning NLL | 需要 | 同样使用 NLL,数据来自迭代 CoT |
| DPO-Positive | DPO + positive penalty | chosen 低于 reference 时触发 | 需要 | 动机相近,penalty 形式不同 |
| ORPO | odds-ratio loss | SFT loss | 不需要 | 同为联合目标,但不是 DPO+SFT |
| χPO | \(\chi^2\)-regularized preference loss | 非 chosen NLL | 需要 | 处理更广义的 overoptimization |
5. 仓库实现:公式如何落到 token 与张量
5.1 数据记录与共享 prompt
仓库的 preference record 至少包含 instruction、chosen 与 rejected,并允许 input 和多轮 history:
{
  "instruction": "解释 DPO 的训练目标。",
  "input": "区分策略模型和参考模型。",
  "chosen": "DPO 比较策略模型与参考模型在偏好对上的对数概率差。",
  "rejected": "DPO 等同于普通的语言模型预训练。",
  "history": [
    ["什么是偏好数据?", "它为同一输入提供更优与较差的回答。"]
  ]
}
在 DPODataset._encode_record() 中,prompt 只通过 chat template 编码一次,随后分别拼接 chosen 和 rejected。这样可以避免同一文本因 generation prompt、特殊 token 或截断边界不同而污染 pairwise margin。
截断顺序是:
- 分别编码 chosen/rejected response,并追加 EOS。
- response 超长时从右侧截断,最后一个位置保留 EOS。
- 按 pair 中较长 response 计算 prompt budget。
- prompt 从左侧截断,chosen/rejected 复用同一结果。
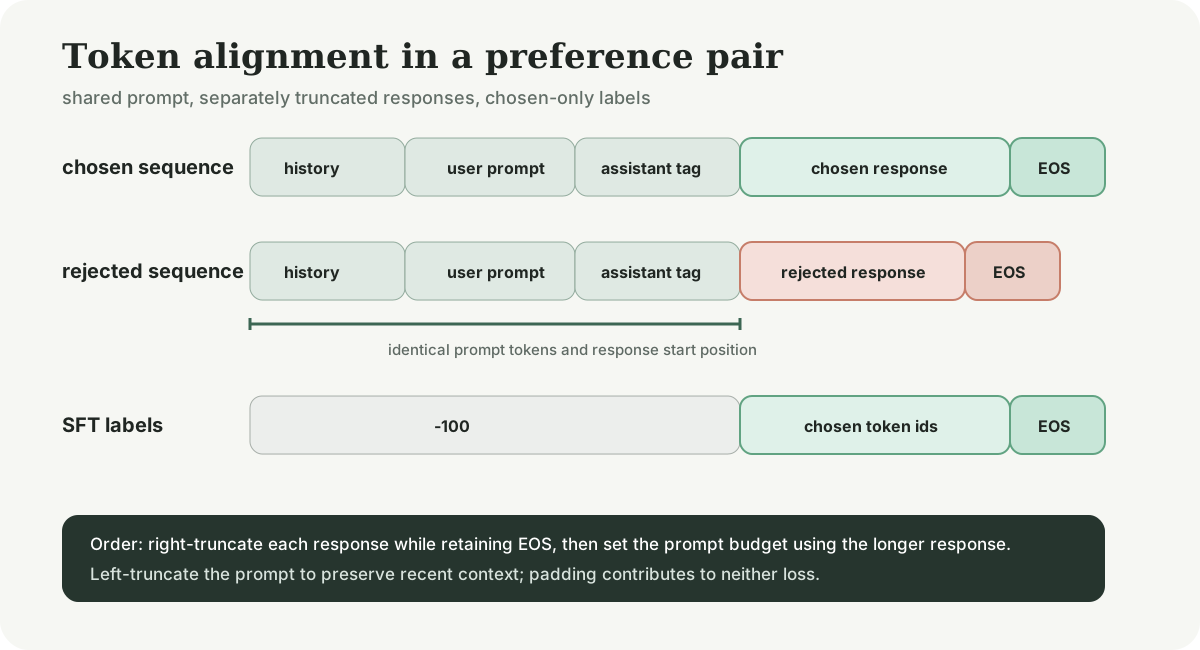
图 13:数据边界比公式更容易出错。两侧 response start position 必须一致,SFT labels 只覆盖 chosen response 与 EOS。
这套策略优先保留靠近当前回答的上下文。代价是很早的 system message 或 history 可能被截掉。若任务依赖长 system prompt,应单独统计该字段保留率,而不是只记录总截断率。
5.2 Causal shift 的 off-by-one
若 prompt 长度为 \(P\),第一个 response token 位于 input_ids[P],预测它的 logits 位于 causal shift 后的索引 \(P-1\)。仓库因此把 response_start_position 设为 len(prompt_ids) - 1。
一个最小实现如下:
import torch
import torch.nn.functional as F


def response_logps(
    logits: torch.Tensor,
    input_ids: torch.Tensor,
    attention_mask: torch.Tensor,
    response_start_positions: torch.Tensor
) -> torch.Tensor:
    """Sum response-token log probabilities.

    Args:
        logits: Causal LM logits with batch, sequence, and vocabulary axes.
        input_ids: Token IDs with batch and sequence axes.
        attention_mask: Mask selecting non-padding tokens.
        response_start_positions: First response index after causal shift.

    Returns:
        Summed response log probability for every sequence.
    """
    shifted_logps = F.log_softmax(logits, dim = -1)[:, :-1, :]
    shifted_labels = input_ids[:, 1:]
    shifted_attention = attention_mask[:, 1:].bool()
    token_logps = torch.gather(
        shifted_logps,
        dim = -1,
        index = shifted_labels.unsqueeze(-1)
    ).squeeze(-1)

    positions = torch.arange(token_logps.shape[1], device = token_logps.device)
    response_mask = positions.unsqueeze(0) >= response_start_positions.unsqueeze(1)
    return (token_logps * shifted_attention * response_mask).sum(dim = -1)
该错误不会必然触发 shape exception,却会悄悄漏掉第一个 response token。仓库测试显式覆盖了 response start、EOS 与 padding mask,这是必要的实现约束。
5.3 chosen 前向结果被两条 loss 复用
DPOTrainer.compute_loss() 先执行 chosen policy forward。其 logits 一路汇总为 chosen sequence log probability,进入 DPO;另一路与 chosen labels 计算 cross entropy,进入 SFT。SFT 分支没有新增一次模型前向。
图 14:当前实现每个 batch 有四次模型前向:policy chosen/rejected 与 reference chosen/rejected。SFT 复用 policy chosen logits。
reference model 设为 evaluation mode、关闭梯度并保持参数固定,但完整权重仍占显存。对固定数据集,可以预计算 reference log probability,用磁盘与预处理时间换训练阶段显存和吞吐。TRL 的 precompute_ref_log_probs 提供了同类思路。
6. 长度偏差不会被 SFT 自动修复
仓库使用 response token log probability 的总和,不做长度归一化:
\[ \log \pi_\theta(y\mid x) = \sum_t \log p_t \]
每个 token 的 log probability 通常为负,长 response 的序列分数天然更低。reference-adjusted ratio 会抵消一部分长度效应,但 preference label 与长度差若高度相关,模型仍可能学到 verbosity shortcut。
LD-DPO 把这种 length sensitivity 单独建模,并展示了 chosen/rejected 长度组合与 DPO 优化方向之间的系统关系。8
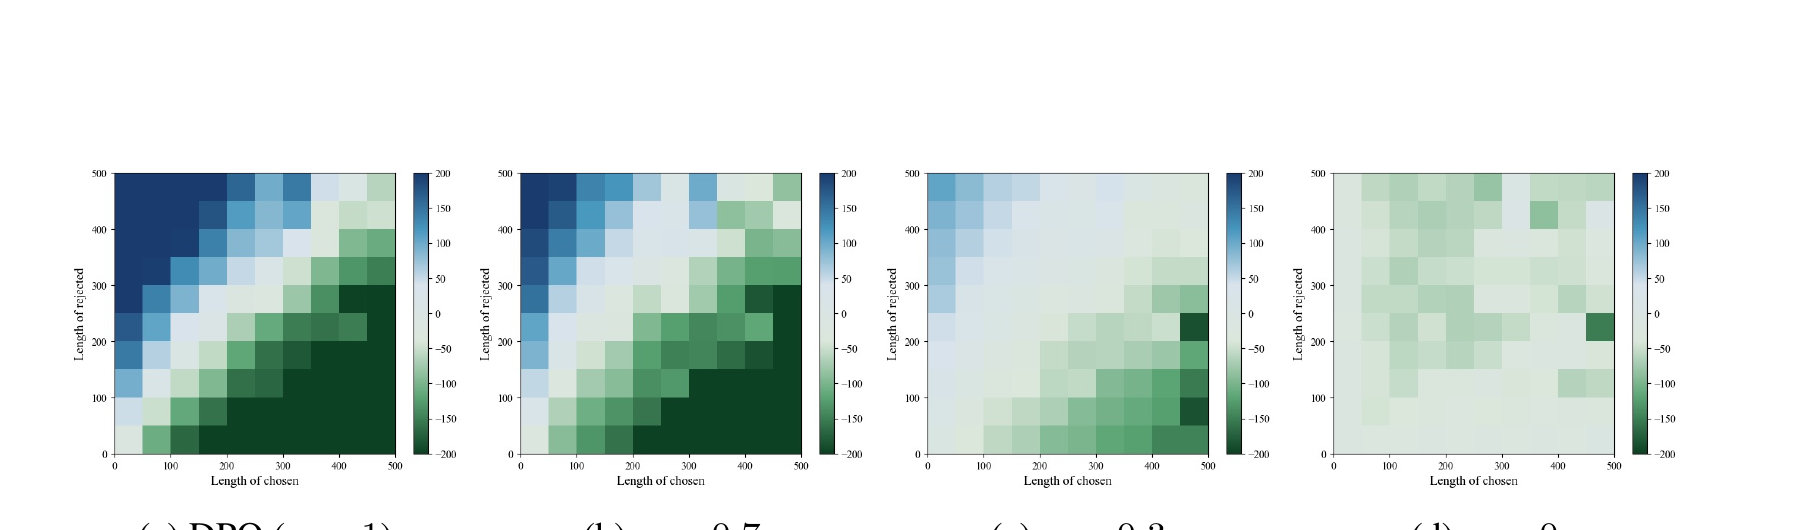
图 15:随着 LD-DPO 的 \(\alpha\) 减小,长度对目标的系统影响被削弱。来源:Liu et al., 2024, Figure 2。
最低限度的数据审计应包含 chosen/rejected token 数分布、长度差分布、preference label 与长度差相关性、按长度差分桶的 DPO accuracy,以及 generation 的平均长度与 length-controlled win rate。sft_loss_weight 不能代替这套审计。
7. 指标:训练 loss 不能单独证明生成变好
| 指标 | 定义 | 能回答的问题 | 不能回答的问题 |
|---|---|---|---|
dpo_loss |
\(-\log\sigma(\beta\Delta)\) | pair margin 是否继续被优化 | 生成质量是否提升 |
dpo_accuracy |
\(s_\theta(y^+)\gt s_\theta(y^-)\) 的比例 | observed pair 的排序 | held-out win rate |
sft_loss |
chosen token CE | chosen token 拟合程度 | preference 区分能力 |
policy_diff_mean |
\(\log\pi_\theta(y^+)-\log\pi_\theta(y^-)\) | policy 原始 pair gap | 相对 reference 的变化 |
chosen_logratio_mean |
\(\log\pi_\theta(y^+)-\log\pi_{\mathrm{ref}}(y^+)\) | chosen 相对 reference 的移动 | 严格 KL divergence |
rejected_logratio_mean |
rejected 的同类 log-ratio | rejected 是否被压低 | 严格 KL divergence |
仓库目前把最后两项命名为 kl_chosen_mean 与 kl_rejected_mean。单个已观测 response 的 log-ratio 不是严格 KL;KL 需要对某个输出分布求期望。训练日志若暂不改名,分析报告至少应明确该口径。
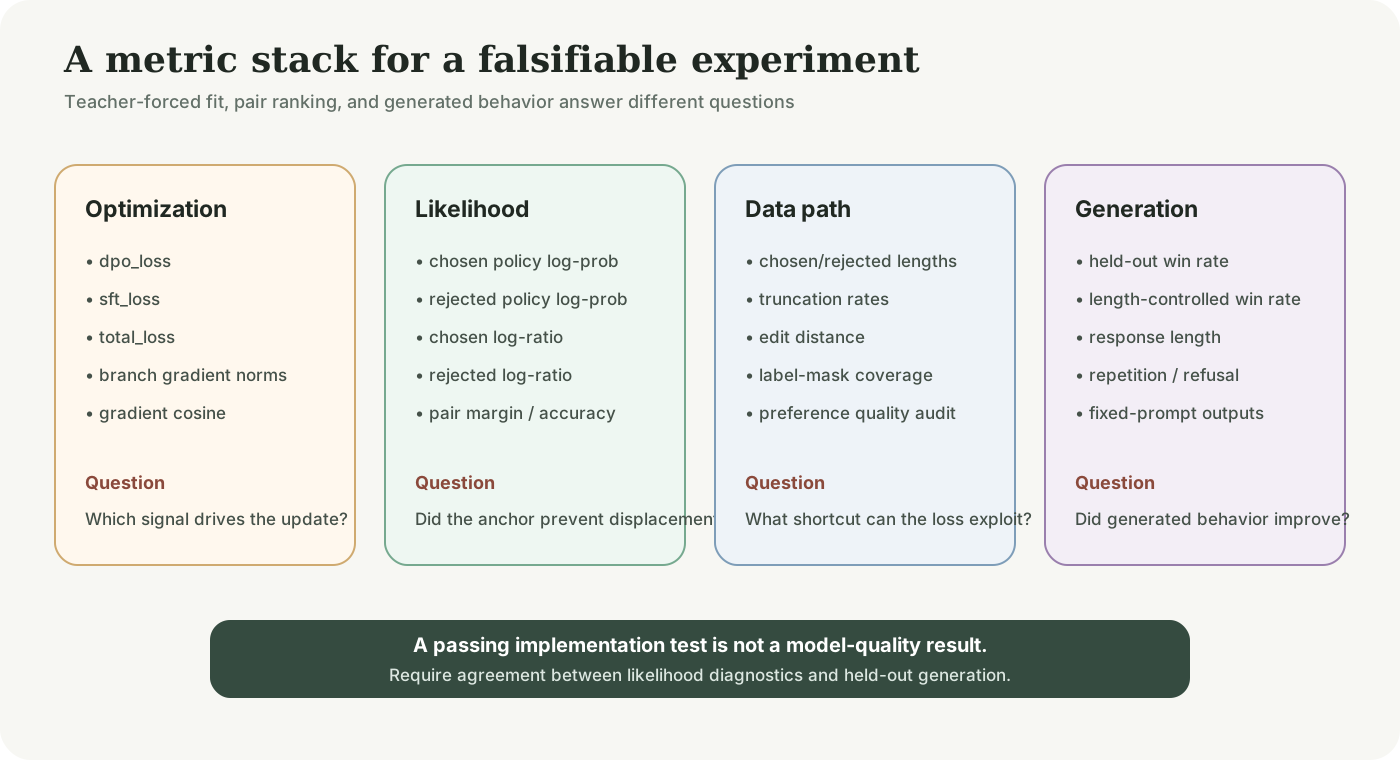
图 16:一个可信结论至少需要 likelihood 诊断与 held-out generation 同向。实现测试通过只覆盖最左侧的一部分。
Likelihood displacement 的安全对齐实验进一步说明,只加 SFT 虽然能缓解 refusal rate 下跌,但按 CHES 过滤高风险 preference pairs 的效果更强。数据质量在这里不是泛泛的「也很重要」,而是可能比 loss 修补更有决定性。
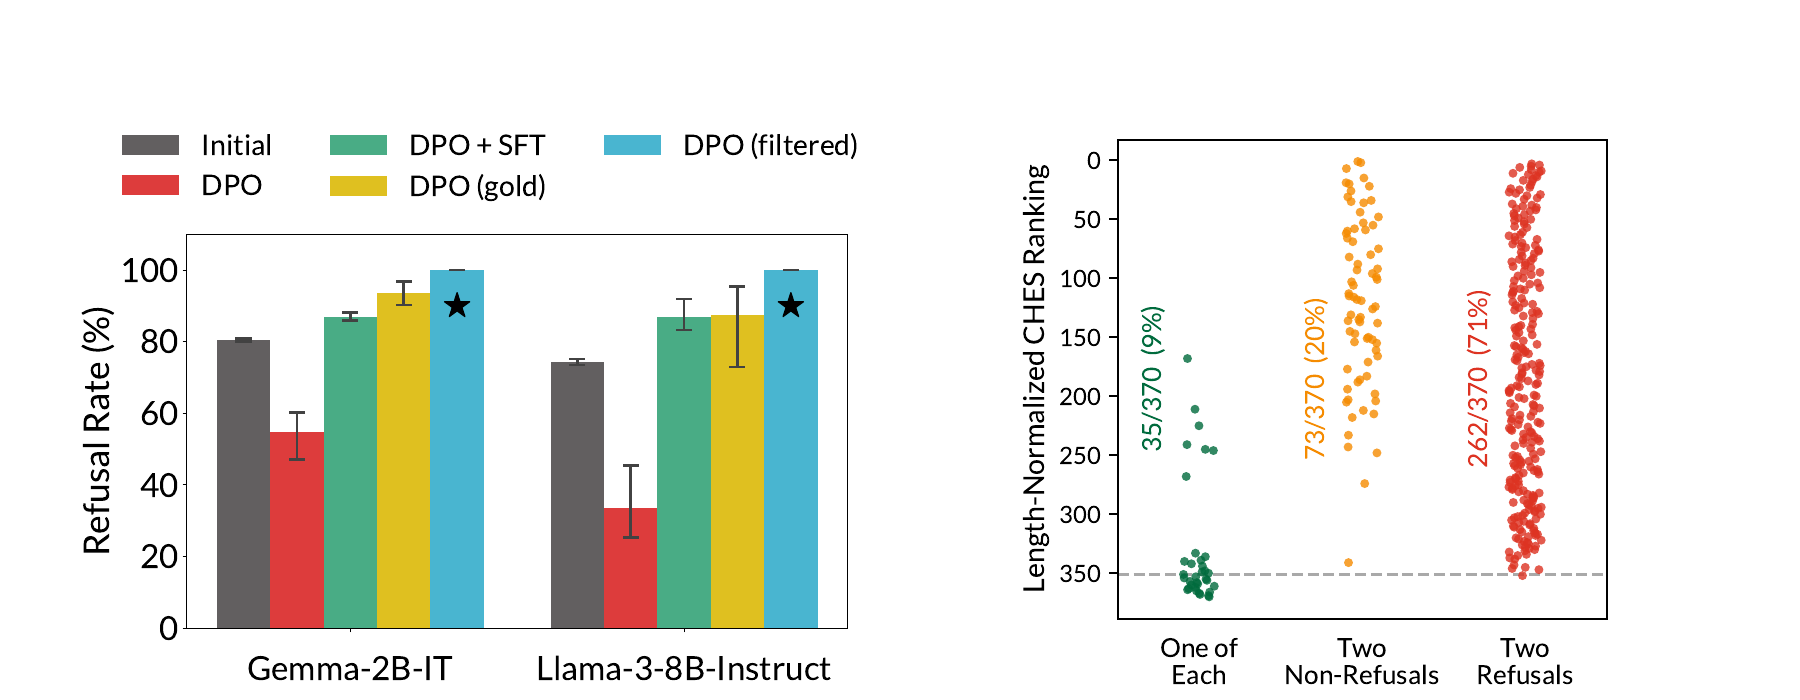
图 17:DPO+SFT 恢复了部分拒答率,过滤数据恢复得更多。来源:Razin et al., 2024, Figures 3–4。这说明 chosen NLL 是缓解手段,不是数据覆盖问题的完备替代。
8. \(\lambda_{\mathrm{SFT}}\) 消融:怎样让假设可以被推翻
合理的初始 sweep 不应只比较 \(0\) 与 \(0.1\):
\[ \lambda_{\mathrm{SFT}} \in \{0, 0.01, 0.05, 0.1, 0.25, 0.5\} \]
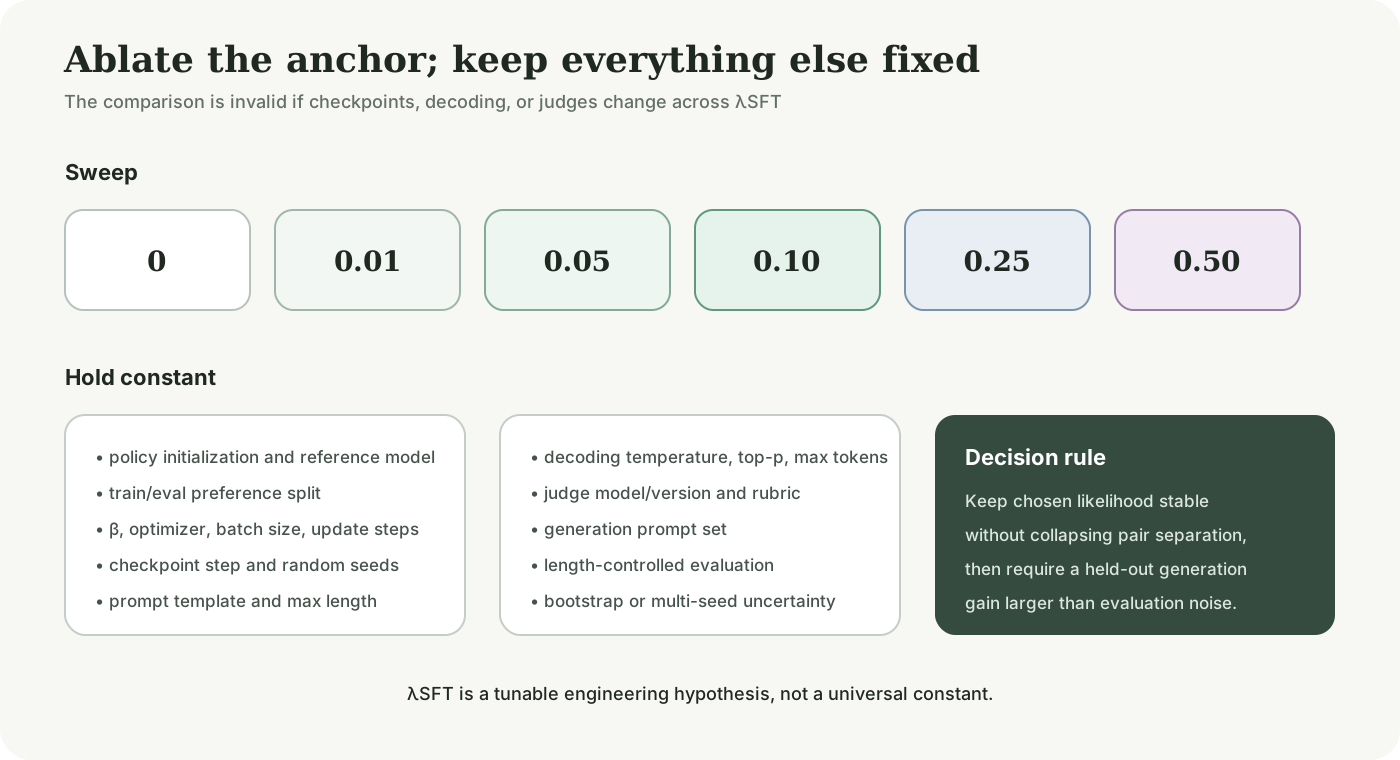
图 18:所有设置必须使用相同初始化、preference split、\(\beta\)、优化预算、checkpoint step、随机种子、解码配置与 judge。
我会用以下判据决定是否保留 SFT 分支:
- chosen log-ratio 不再持续下降,rejected log-ratio 仍保持区分度;
- held-out preference accuracy 与 generation win rate 共同改善,而不是只降低 teacher-forced SFT loss;
- 输出长度、重复率、事实错误率与拒答率没有非预期漂移;
- 多随机种子差异大于 judge 与 sampling 噪声;
- 结果在低/高 edit distance、短/长 pair 分桶中没有完全相反的趋势。
若 \(\lambda_{\mathrm{SFT}}\) 增大后 SFT loss 下降、pairwise accuracy 停滞,imitation 可能压过 preference signal。反过来,preference margin 持续增大而 chosen log-ratio 长期下降,当前权重没有形成有效锚定。两种情况都无法从 total loss 识别。
9. 当前实现的工程边界
第一,reference model 常驻显存。LoRA 只减少 policy 的可训练参数,不会消除 reference 权重;QLoRA 也只量化当前代码路径中的 policy base,reference 仍按 BF16、FP16 或 FP32 加载。训练前应分别记录 policy base、adapter、optimizer state、activation 与 reference 的显存。
第二,policy 在训练模式下对 chosen/rejected 分别前向。若 LoRA dropout 或模型内部 dropout 开启,两侧 log probability 使用不同随机 mask,margin 会增加额外方差。TRL 默认关闭 DPO policy/reference dropout;本项目若保留 lora_dropout = 0.1,应加入开关消融。
第三,SFT cross entropy 按有效 token 求 mean,而 DPO 使用 sequence log-prob sum 后按 batch 求 mean。response 长度分布变化会改变两项的相对数值尺度,因此一个数据集上的 \(\lambda_{\mathrm{SFT}}\) 不应直接迁移到另一个数据集。
第四,chosen 必须值得模仿。若 pair 只表达「A 比 B 稍好」,chosen 仍可能包含事实错误、冗长格式或安全缺陷。DPO 至少只要求相对排序;加上 NLL 后,chosen 同时成为绝对 token target。
第五,当前仓库尚未给出真实训练曲线、checkpoint 与 generation benchmark。本文引用的论文图用于建立实验问题,不是该项目已经取得相同结果的证明。
10. 结论
在 DPO 上叠加 chosen-response SFT loss,最准确的描述是:给相对偏好目标增加一条 imitation 梯度。它不改变 preference pair 的基本结构,不增加 policy forward,却会改变 chosen 的绝对优化方向,并保留 reference model 的显存与计算成本。
相关论文已经证明两个值得认真对待的现象:标准 DPO 允许 chosen likelihood 下降;pair 外概率转移可能影响生成、安全与长度。论文同样给出了限制:SFT 只能缓解部分 displacement,数据过滤、alternative regularization 与 preference coverage 仍可能更重要。
所以,下一步不应继续往 loss 里添加组件。先跑完 \(\lambda_{\mathrm{SFT}}\) 消融,把 chosen/rejected absolute log probability、branch gradient、长度分布、固定 prompt 生成与 held-out win rate 放在同一份报告里。只有这些证据一致,DPO + SFT 才从一个合理实现变成项目结论。
参考资料
Footnotes
Rafael Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model, 2023.↩︎
Noam Razin et al. Unintentional Unalignment: Likelihood Displacement in Direct Preference Optimization, 2024; ICLR 2025.↩︎
Zhihan Liu et al. Provably Mitigating Overoptimization in RLHF: Your SFT Loss is Implicitly an Adversarial Regularizer, 2024.↩︎
Richard Yuanzhe Pang et al. Iterative Reasoning Preference Optimization, 2024.↩︎
Arka Pal et al. Smaug: Fixing Failure Modes of Preference Optimisation with DPO-Positive, 2024.↩︎
Jiwoo Hong et al. ORPO: Monolithic Preference Optimization without Reference Model, 2024.↩︎
Audrey Huang et al. Correcting the Mythos of KL-Regularization: Direct Alignment without Overoptimization via χ²-Preference Optimization, 2024.↩︎
Wei Liu et al. Length Desensitization in Direct Preference Optimization, 2024.↩︎